
PromptPerf
PromptPerf · コーディング
PromptPerfは、自分のプロンプトをGPT、Claude、Geminiなど100以上のモデルで実行し、どれが最も良く答えるかを示す検証プラットフォームだ。
PromptPerf について
What Is PromptPerf
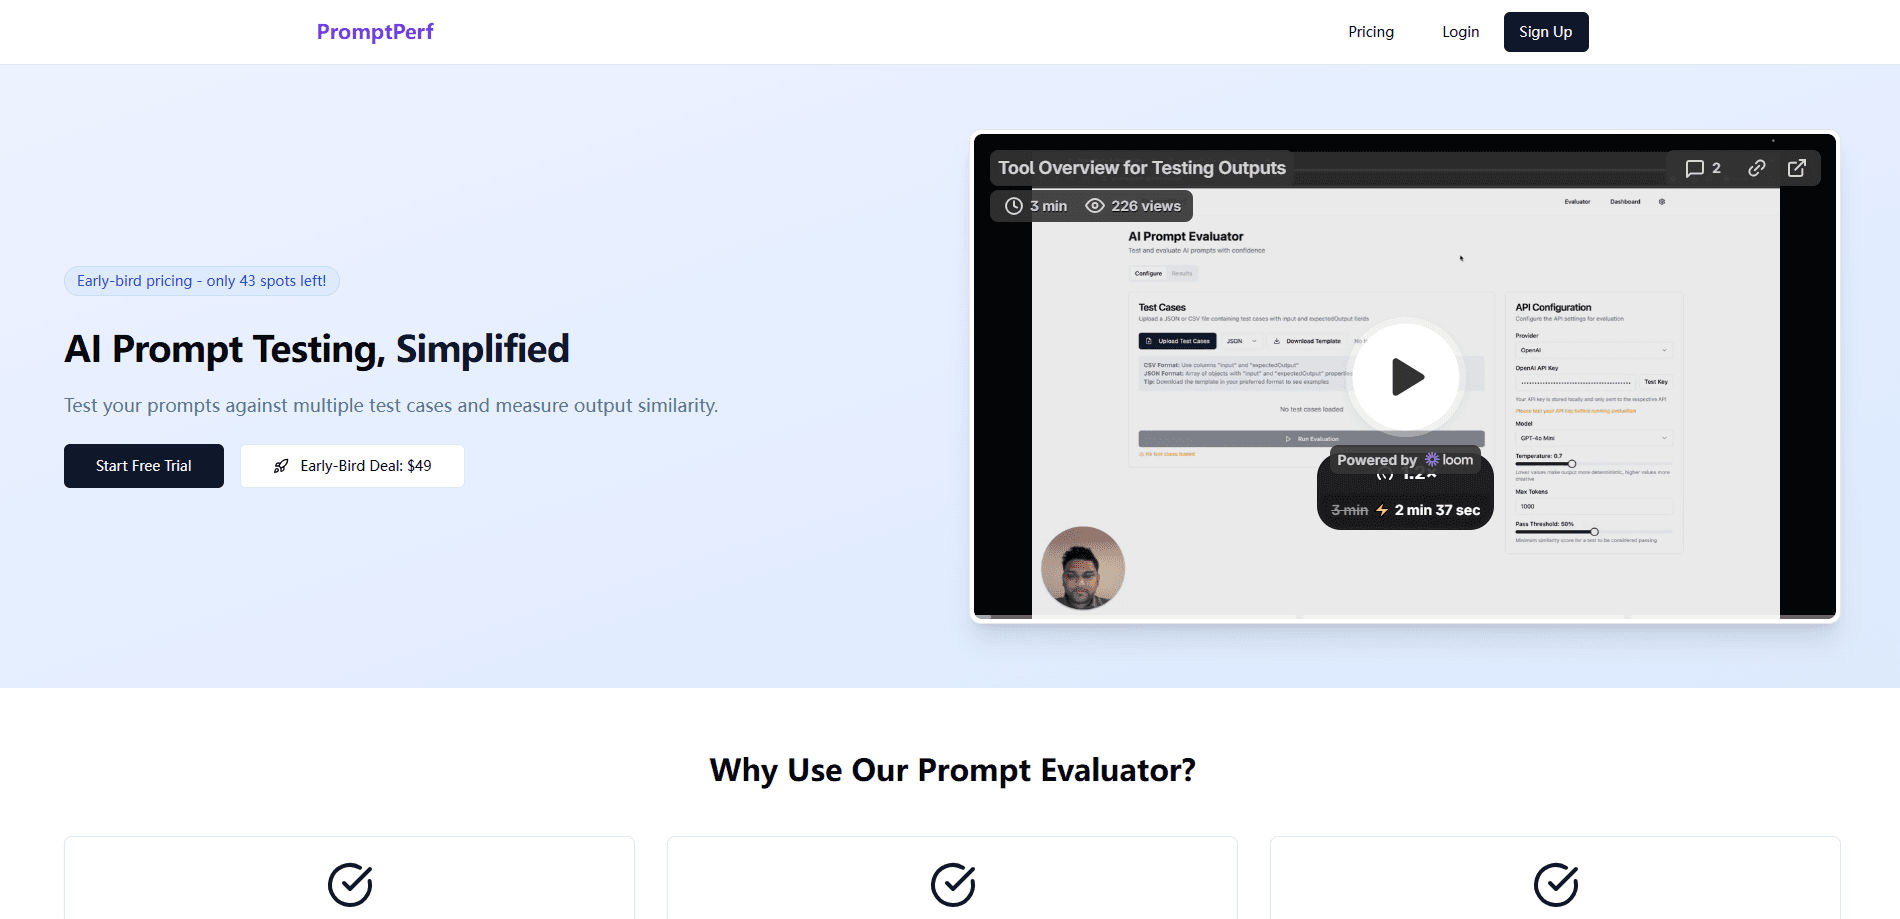
PromptPerfは、仕事でAIモデルを使い、評判だけでモデルを選ぶのに疲れた人向けのWebツールだ。例となるプロンプトを書き、良い回答がどんなものかを説明すると、そのプロンプトを複数のモデルで同時に実行する。各回答は期待した回答と照合して一致スコアを受け取るので、勘ではなく数字で裏づけられた勝者が見える。
背景にある考え方は、汎用のベンチマークは自分の用途についてほとんど語らないというものだ。公開ランキングで上位のモデルでも、自分の特定のタスクでは安い選択肢に負けることがあり、このAIモデル比較のプラットフォームはその差を自分のプロンプトで直接測る。プロンプト評価を自前のデータで行える点が強みだ。コストも記録するので、わずかな精度差と各モデルの価格を天秤にかけられる。
主な制約は範囲にある。PromptPerfは検証と比較の層であり、AIアプリを構築したり公開したりする場所ではない。接続しているホスト型モデルで動き、チーム向けツールや高度な分析といった深い機能は上位のプランに置かれている。
Getting Started
- promptperf.devの評価ツールを開き、少なくとも1つの例を追加する。自分のプロンプトと、良いモデルなら返すはずの回答を組み合わせる。
- 例を増やすかまとめてアップロードし、テストが楽な1件だけでなく複数の入力に対応するようにする。
- 比較するモデルを2つから4つ選ぶか、ツールに候補を提案させ、もっと厳しく、あるいは緩く照合したいなら創造性と合格スコアを調整する。
- テストを実行して結果を読む。各モデルが一致スコアで順位づけられ、各選択肢の相対コストも表示される。
- テストを保存し、後で再実行して、プロバイダーの更新がモデルのプロンプト処理を変えたタイミングを捕まえる。
AIツール情報
PromptPerfの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- データサイエンティストのいない個人開発者や小さなチーム。参考ランキングを読む代わりに自分の例でモデルを比較できる。無料プランは1テストあたり数件の例を扱える。
- 稼働中の機能のためにモデルを選ぶプロダクト責任者やサポート責任者。機能が本当に必要とする回答に結びついたスコアが得られる。コーディングもAPI設定も要らない。
- AIの請求額を気にする開発者。PromptPerfは安いモデルを強いモデルの隣に並べるので、わずかな精度の犠牲と節約を比べられ、自分のタスクに最適なAIモデルを汎用の表に頼らず見つけられる。
タスク
- その上に作る前にモデルを選ぶ。プロンプト検証ツールでタスク固有のプロンプトを走らせ、どのモデルが期待する出力に最もよく一致するかを見る。
- モデル更新後もプロンプトが機能するか確かめる。プロンプトテストを保存し、プロバイダーが新バージョンを出したら再実行する。
- 無料と有料の選択肢を比べる。同じ例をDeepSeekやMetaの無料モデルと有料モデルで走らせ、差が価格に見合うか確かめる。
シーン
- ある作業でChatGPT、Claude、Geminiのどれを使うか迷う。同じプロンプトを3つで走らせ、一般的な評判ではなくスコアに決めさせる。
- 要件がすぐ変わる初期の試作段階。例が変わるたびに保存したテストを再実行し、テスト基盤を作り直さない。
- AI機能を拡大する前の予算検討。コストの列を見て、呼び出しあたりが安い選択肢ならいくら節約できるか確かめる。
主な機能
Multi Model Prompt Testing
このモデル比較ツールは、1回の実行で2つから4つのモデルを突き合わせる。GPT、Claude、Geminiに加え、DeepSeekやMetaの無料モデルも含められる。すべてのモデルが同じ例に答えるので入力が一定に保たれ、選択肢間のプロンプト性能テストが公平になる。プロンプト評価の目的は、同じ問いを固定したままモデルだけを差し替えて、答えの差を見ることにある。
Match Score Against Your Expected Answer
出力を目分量で判断する代わりに、良い回答がどんなものかを書き、PromptPerfが各回答をそれと照らして採点する。合格スコアのしきい値で、その照合をどれだけ厳しくするかを決められる。
Cost Visibility Next to Accuracy
結果は各モデルの相対価格をスコアの隣に示す。精度とコストのトレードオフが明確になり、2つのモデルのわずかな差が大きな支出差になる場面で効いてくる。
Saved Tests and Re-runs
テストを保存し、いつでも再実行できる。一度きりの比較が繰り返せる確認に変わり、プロバイダーがモデルを更新した後の退行を捕まえられる。
Bulk Example Upload
1つのプロンプトを試すだけでなく、例をまとめて読み込み、1回のテストで多くの入力に対応できる。無料プランは1テストあたり最大5件まで、有料プランはこの上限を外す。
No Code and No API Setup
PromptPerfは対応モデルに届くためのAPIキーを備えているので、自分のアカウントをつなぐ必要もスクリプトを書く必要もない。プロンプトを貼り、モデルを選び、結果を読むだけだ。
メリットとデメリット
メリット
- 汎用の公開ベンチマークに頼らず、自分のプロンプトで試せる。
- コスト情報を精度の隣に示すので、安いモデルも公平に見られる。
- 無料プランは登録なしで簡単な比較に使え、無料アカウントで上限が上がる。
- 保存したテストのおかげで、モデル更新後のプロンプト再確認が楽になる。
- コーディングもAPI設定も不要で、非エンジニアの参入障壁が低い。
デメリット
- 比較とプロンプト検証のツールに限られるので、中でアプリを作ったり公開したりはできない。
- 採点は自分が書く期待回答に依存するので、例が弱いとシグナルも弱くなる。
- チーム機能と高度な分析は最安のプランには含まれない。
よくある質問
PromptPerfは自分のプロンプトを100以上のAIモデルで実行し、各回答が期待した回答にどれだけ合うかを採点する。その後モデルを順位づけするので、自分の特定のタスクで最も良い結果を出すものを選べる。
関連コンテンツ
PromptPerfに関連するツール、スキル、記事を探す。
PromptPerfの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。