

QAgent
QAgent Inc. · コーディング · ビジネス
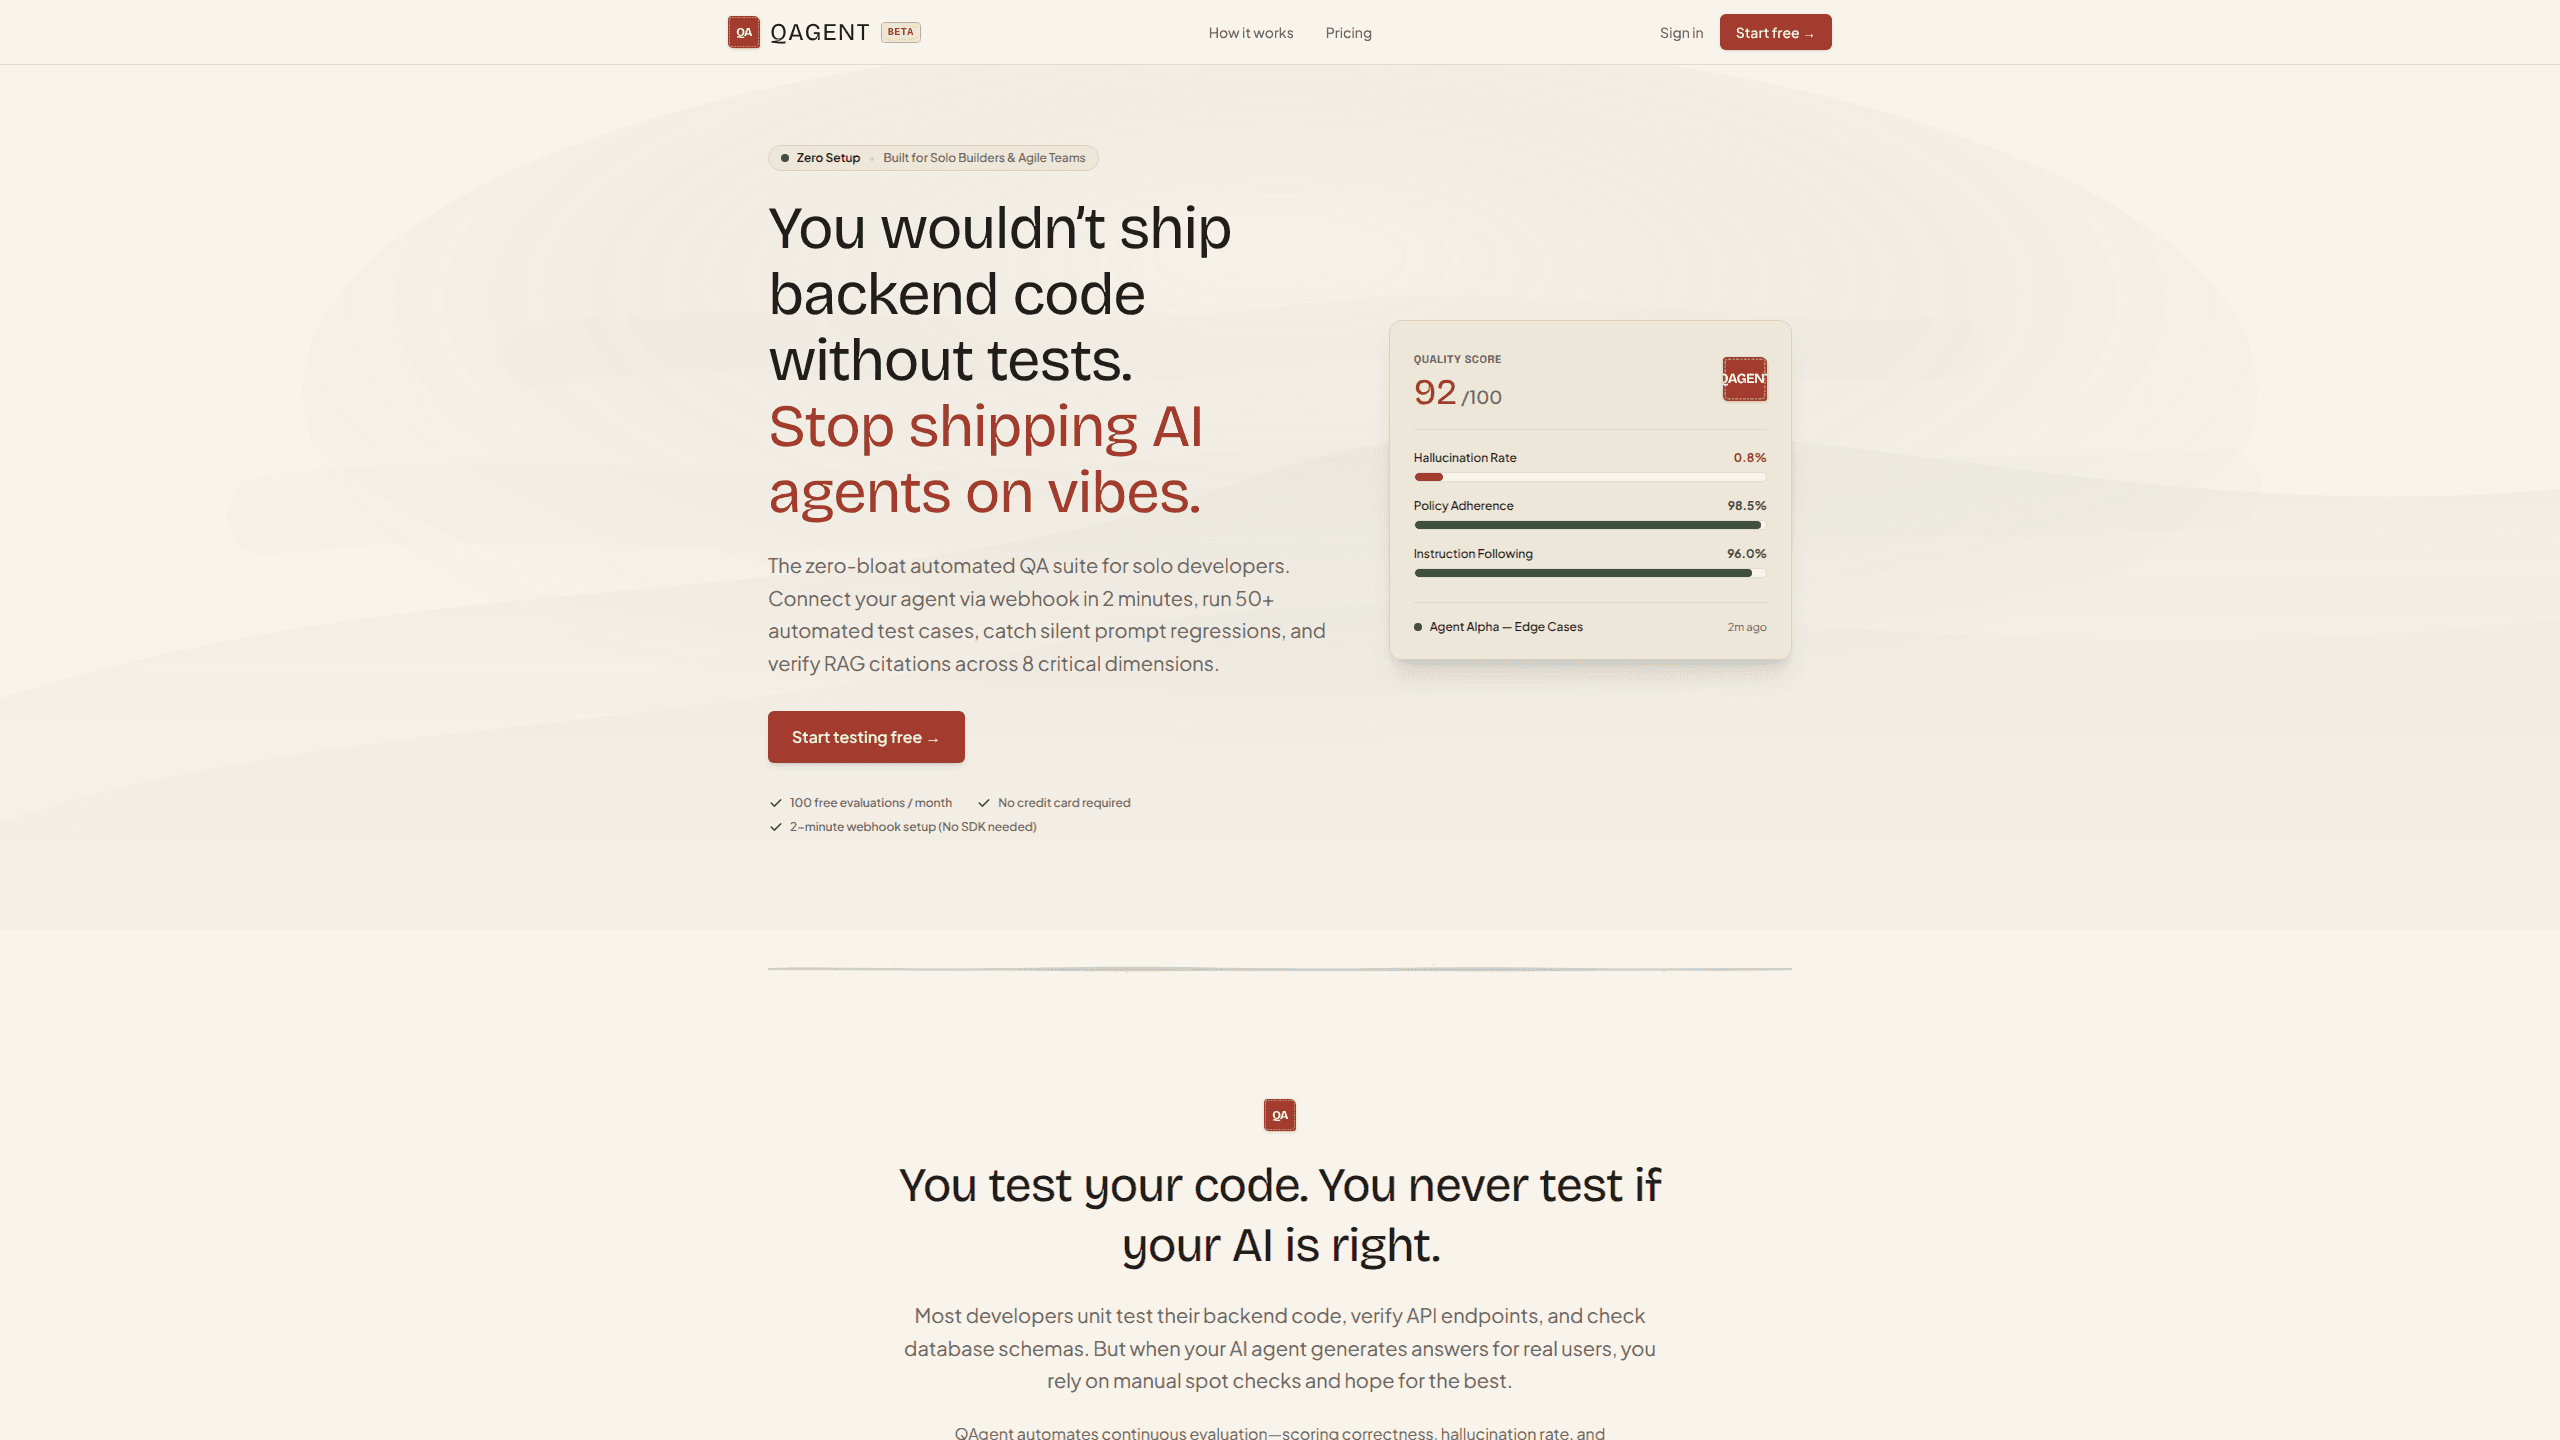
QAgentはAIエージェント向けの自動品質保証プラットフォームだ。エージェントのエンドポイントを指定し、従うべきグラウンドトゥルースを定義すると、リリースごとに回答品質、ハルシネーション率、ポリシー遵守、マルチターンの記憶を採点するテストスイートを実行する。誰でも数分で動かせるLLM評価ツールとして機能する。専任のQA部門を持たずにエージェントを出荷する個人開発者と小規模チームのために作られている。
QAgent について
QAgentとは何か
QAgentは、ほとんどのAI開発者が飛ばしてしまう問いに答えるウェブベースのテストプラットフォームだ。あなたのエージェントは本当に正しい回答を出しているのか。プレイグラウンドでいくつか返答を読んでうまくいくことを願う代わりに、エージェントを接続し、プロンプトを変えるたびに同じ一連のチェックをQAgentに実行させる。
この製品は特定の空白を突く。開発者はバックエンドのコードを単体テストし、APIエンドポイントを検証する。ところがLLMが実ユーザー向けに回答を生成した瞬間、品質チェックは手作業の抜き取り確認に変わる。これは問題だ。QAgentはエージェントの出力をテスト可能なものとして扱い、その場で説得力があるかどうかではなく、あなたが書いたルールに照らして採点する。
主な制約は範囲にある。QAgentが評価するのは正確さ、安全性、一貫性だ。プロンプトを代わりに直してくれるわけではなく、採点は与えたグラウンドトゥルースの質を超えられない。だから本物のルールを書くこと。返金ポリシーや料金プランが定義されていなければ、審査モデルには照合する対象がない。
はじめかた
- 無料アカウントを作成し、webhookエンドポイント、LangChainワークフロー、または単純なHTTP POSTターゲットでエージェントを接続する。
- グラウンドトゥルースを定義する。料金プラン、返金期間、禁止トピック、エージェントが守るべきあらゆるナレッジ文書だ。
- プロンプトと期待される挙動を対にしたテスト用ルーブリックを書く。明確な「必須」と「禁止」のルールを使う。
- スイートを実行し、合格・不合格の評価と、各失敗のステップごとの根本原因を確認する。
- 同じスイートをリリースフローに組み込み、デプロイ前にプロンプトの編集が再採点されるようにする。
AIツール情報
QAgentの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 個人開発者
- QA担当を雇っていない小規模チーム
- フリーランサーと代理店
タスク
- ハルシネーションの捕捉
- プロンプトのリグレッション追跡
- RAG引用の検証
- マルチターンの記憶テスト
シーン
- ある顧客のエッジケースを直すための深夜のプロンプト調整と、その後の約1分での完全なリグレッション実行。
- AIチャットボットを顧客に渡す際、事実のグラウンディングとポリシー遵守を示すスコアカードを添える。
- 直感ではなく自動評価の結果でデプロイのリリースを判断する。
- 敵対的入力を試し、エージェントが出せない割引を約束するのではなく人間にエスカレーションすることを確認する。
主な機能
8つの評価軸
QAgentは単一の曖昧なスコアではなく、8つの別々の指標でエージェントを採点する。それらは回答品質、事実のグラウンディング、ポリシー遵守、エスカレーションの正確さ、RAG忠実度、文脈関連性、文脈の再現率、マルチターンの記憶をカバーし、各軸が実際の本番障害モードに対応する。この細かさが効く。低い数値は漠然とした雰囲気ではなく、具体的な問題を指し示す。
決定論的なLLM as a judge採点
文字列や正規表現の照合ではなく、QAgentは校正済みの審査モデルで各回答を吟味する。速度のためにGroqのLPU上で動く。完全なリグレッションスイートを1分以内に終わらせたいときに効いてくる。合格・不合格の判定には信頼度が付くので、結果が境界線に近く、信用する前に手作業でよく見るべきタイミングが分かる。
グラウンドトゥルースとルーブリックの仕組み
すべてのテストは3つの材料を組み合わせる。あなたの公式ルール、RFC 2119形式の期待挙動を記したテストプロンプト、エージェントのライブ応答だ。審査モデルはルーブリックに厳密に照らして確認する。丁寧でも間違った回答は不合格になる。これがQAgentとチャット画面での気分チェックを分けるものだ。
誤検知のためのスマートな除外
審査モデルはハルシネーションと通常の挙動の違いを分かっている。セッションごとに変わるチケットID、ライブ残高、丁寧な挨拶は、根拠のない主張としてフラグが立たない。いいね。最上位の取得チャンクが完全な回答を含むなら、下位の結果がスコアを引き下げない。ジェイルブレイクテストは、攻撃文書がないことで検索側にペナルティを与えない。
プロンプトのリグレッション追跡
QAgentはプロンプトの反復ごとにスコアの差分を記録する。あるケースを直した変更が別の箇所で低下を招いていないかが即座に分かる。まさにそれが狙いだ。システムプロンプトを頻繁に編集するチームにとって、これは静かな劣化をグラフ上の見える線に変える。
品質監査レポート
SoloプランはCSVと印刷可能な品質監査レポートを書き出す。グラウンディング率、RAG忠実度、ポリシー遵守を示す。顧客が約束ではなく証拠を求める場面で役立つ。ファイルを送ればいい。レポートはテスト実行を、プロジェクト引き渡しに添付できるものへと変える。
メリットとデメリット
メリット
- webhookの設定は約2分で、インストールするSDKも書く定型コードもない。
- 名前の付いた8つの軸が、1つの混ざったスコアではなく具体的なフィードバックを与える。
- 月100回の評価が付く無料枠のおかげで、支払う前に試しやすい。
- 透明な監査証跡が各テストのクエリ、ルーブリック、応答、評価側の所見を示す。
- 年契約の縛りも営業電話もない定額月額料金。
デメリット
- 無料プランで接続できるエージェントのエンドポイントは1つなので、複数のエージェントを試すには有料プランが要る。
- 採点は完全に与えたグラウンドトゥルース次第だ。曖昧なルールは曖昧な結果を生む。
- プラットフォームはまだベータなので、機能や制限が変わりうる。
よくある質問
AIエージェントが正しくポリシー準拠の回答を出すかをテストする。ハルシネーション検出、指示の追従、RAG忠実度、エスカレーション挙動、マルチターンの記憶をカバーし、8つの軸で採点する。
関連コンテンツ
QAgentに関連するツール、スキル、記事を探す。
QAgentの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Google EmbeddingGemma 2
Google DeepMind · ライティング · 画像 · コーディングGoogle EmbeddingGemma 2 は 7 億 4000 万パラメータのオープンなモデルで、テキスト、コード、画像、音声、動画フレームを同じ 768 次元空間のベクトルに変え、スマートフォンやノート PC 上で動く。

GitGlow
GitGlow · コーディング · 生産性向上GitGlow は自分のコードと AI エージェントの変更を一つのレビューにまとめるデスクトップ Git クライアントだ。出荷前に、マシンから何が出ていくのかを確かめられる。