
QwQ-32B
Alibaba (Qwen team) · ビジネス · その他
QwQ-32BはAlibabaのQwenチームによるオープンウェイトの推論モデルだ。数学とコードの問題を段階的に解き、手持ちのGPU1枚で動く。
QwQ-32B について
What Is QwQ-32B
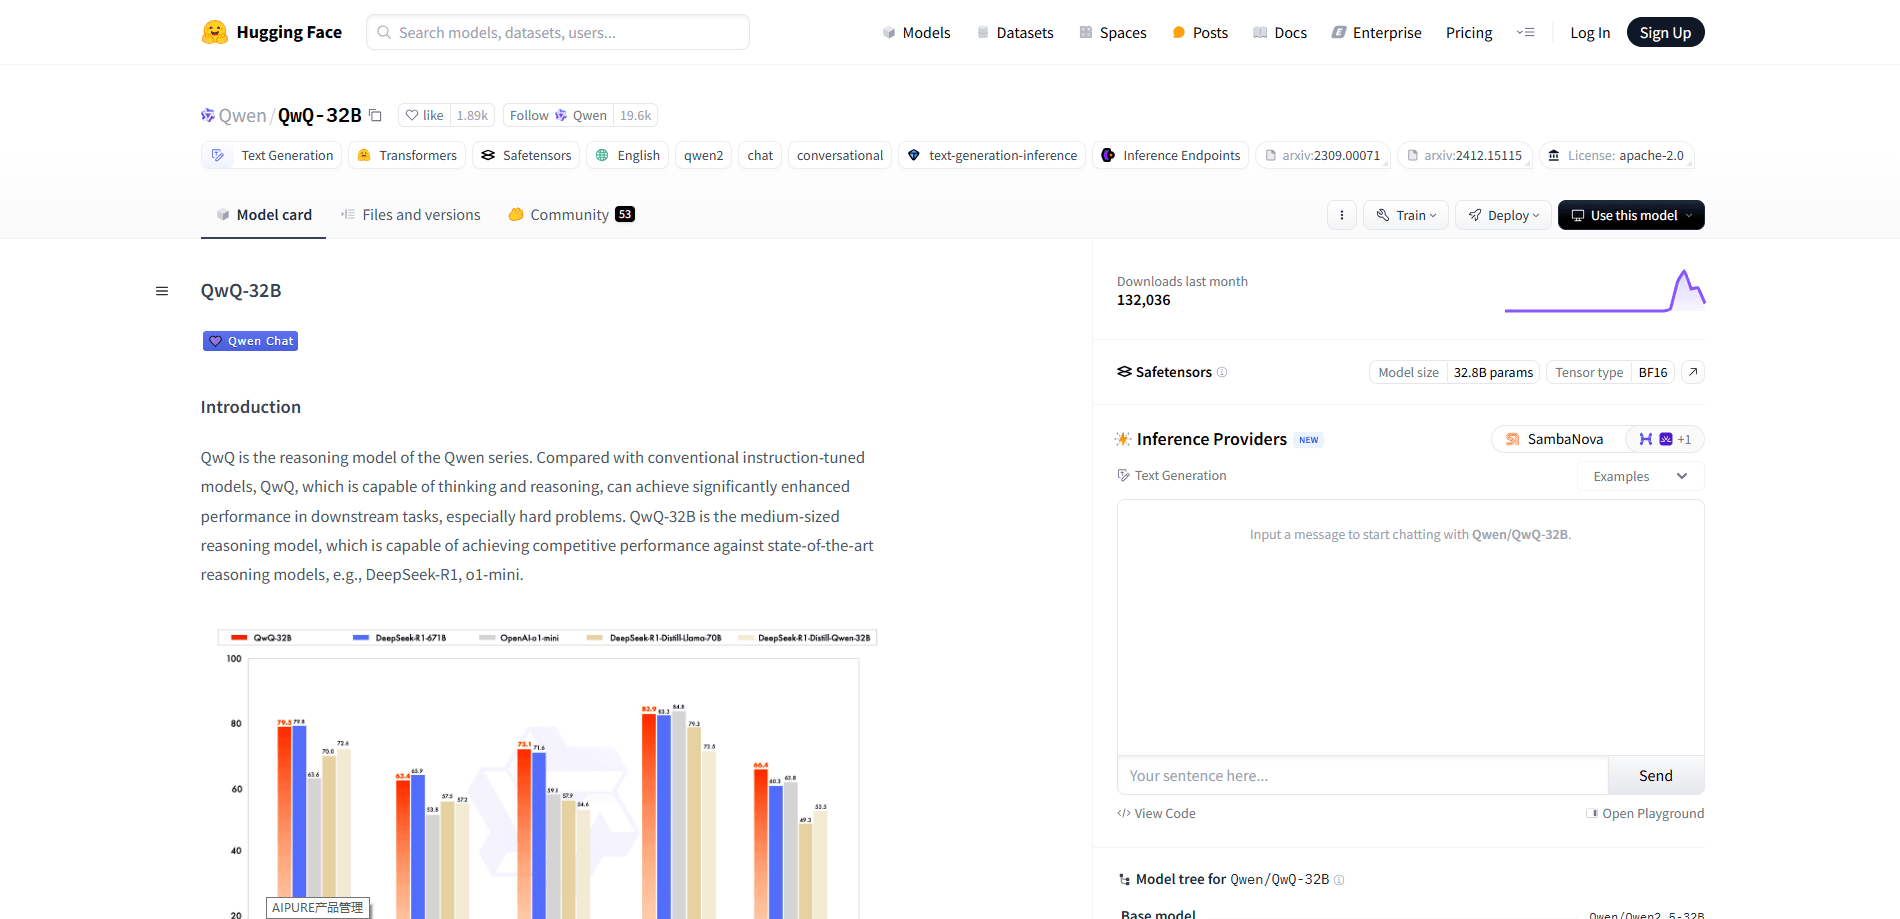
QwQ-32BはAlibabaのQwenチームによる推論特化の言語モデルで、2025年3月にApache 2.0ライセンスで公開された。このQwQ-32B推論モデルのパラメータ数は320億。土台は汎用モデルのQwen2.5-32Bだ。即答せず、長い思考の連鎖を書き出し、自分の手順を検証してからようやく答えを確定する。この癖こそ推論と呼ばれるもので、当てずっぽうが高くつく問題に強い理由でもある。
Qwenチームが掲げる最大の主張は、QwQ-32Bが6710億パラメータのDeepSeek-R1と互角に渡り合うという点だ。その差を埋めたのは規模ではなく強化学習だとチームは説明する。数学とコードでRLを拡大し、その後にもう一段、汎用能力向けの学習を足したのだ。利用者にとっての要点はシンプルで、自分で動かせるほど小さいのに強力な推論モデルだということだ。
弱点は守備範囲にある。QwQ-32Bは話す前に考えるため、取るに足らない質問でも動作が遅く、重みは最初の公開時点で止まっている。後続のQwen推論モデルは対応言語を広げ、高速モードと深考モードを切り替えられる。このオープンソース推論モデルは何でも屋のアシスタントではなく、推論に絞った道具と捉えるのが正しい。
Getting Started
- Hugging FaceかModelScopeから重みをダウンロードするか、
ollama run qwqで量子化版を取得する - 手持ちのハードウェアに合わせ、vLLMやSGLang、Ollamaといった推論サーバーにモデルを読み込む
- サーバーが公開するOpenAI互換エンドポイントにプロンプトを送り、最終回答の前に思考の過程を読む
- ホスト型で使うなら、Alibaba Cloud Model StudioのQwen APIをモデル名
qwq-32bで呼び出す
AIツール情報
QwQ-32Bの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 自分のマシンで推論モデルを動かしたい開発者。32Bなら量子化後にハイエンドGPU1枚に収まるため、機密の作業が手元から出ない。
- 数学やコードの問題でつまずく学生と独学者。モデルが手順をさらけ出すので、間違いが行き止まりではなく教材になる。
- 推論モデルを比較したい研究者。重みが公開されているので、同じプロンプトを走らせ直し、思考の過程を直接調べられる。
タスク
- 競技寄りの数学問題を解く。一歩ずつ進むため、普通のチャットボットが崩れる多段の文章題にも耐える。
- コードを書き、デバッグする。実装を固める前に、境界条件とテストケースを推論で詰める。
- ツールを使うエージェントを組む。関数を呼び出し、返ってきた結果で計画を調整できる。
- 量子化したローカル推論。4ビット版ならモデルがコンシューマー向けGPUに収まるので、QwQ-32Bローカル実行の道が開け、オフラインでも考えさせられる。
シーン
- 機密データを社内に留める。重みを自分で動かすので、契約書や診療記録が第三者のサーバーに届くことはない。
- オフラインや閉じたネットワークでの作業。モデルを読み込んでしまえば、問題を解くのに接続は要らない。
- 推論機能の試作。OpenAI互換サーバーなら、既存アプリにQwQ-32Bを差し込んで結果を見比べるのは簡単だ。
主な機能
長い思考の連鎖による推論
QwQ-32Bは答えを出す前に、問題を明示的な手順で解き進める。その思考を読めば、どこで道を誤ったかが分かり、プロンプトを書き直せる。自信ありげに聞こえるモデルと、実際に検証できるモデルの違いはここにある。
桁違いに大きなモデルに迫る数学とコードの性能
Qwenチームによれば、QwQ-32BベンチマークはAIMEやLiveCodeBenchといったテストでDeepSeek-R1に並ぶ。規模の差は歴然としている。この2分野は学習の中心だったため、QwQ-32B数学とコードの場面では自然な選択になる。
推論の途中で使えるツール呼び出し
QwQ-32Bは考えている最中に関数を呼び出し、その結果を計画に組み戻す。最新データや外部の操作が必要なとき、当て推量ではなくツールに手を伸ばすタイミングを自分で判断する。チャット相手ではなく、エージェントの頭脳として使える所以だ。
Apache 2.0のオープンウェイト
重み一式をダウンロードでき、ライセンスも寛容だ。微調整も量子化も、製品への組み込みも自由にできる。ベンダーのアカウントの裏に何も閉じ込められていない点は、上に何かを作る人にとって大きい。
量子化すればGPU1枚で動く
フル精度では多くのメモリを食うが、4ビット版ならコンシューマー向けGPUに収まる。かつてデータセンターを要した推論が、自分のマシンで手に入る。
OpenAI互換での配信
vLLMやSGLangといったサーバーは、OpenAI流のAPIでQwQ-32Bを提供する。既存コードを新しいURLとキーに向け直すだけで動くので、乗り換えは書き直しではなく数分で済む。
メリットとデメリット
メリット
- 何倍も大きなモデルと渡り合う推論品質。根拠はQwenチームのベンチマークだ
- Apache 2.0のオープンウェイトで、セルフホストも微調整も配布も自由
- 量子化版はコンシューマー向けGPU1枚で動き、機密データを手元に保てる
- ツール呼び出しが推論の流れに組み込まれ、エージェントの土台として頼れる
- OpenAI互換サーバーなので、導入時のコード変更はわずかで済む
デメリット
- 仕様上どうしても遅い。些細な質問でも思考を一巡するため、チャット感覚で使うと重い
- 重みは2025年の公開時点で止まり、後続Qwenモデルが備えた多言語対応やモード切替は使えない
- フル精度のメモリ要求が高く、並のハードウェアでは量子化を避けられない
- 学習が数学とコードに寄っているため、自由な文章やマイナーな言語では汎用モデルに後れを取ることがある
よくある質問
AlibabaのQwenチームによる、推論に絞ったオープンウェイトの言語モデルだ。320億パラメータを持ち、答える前に問題を段階的に解き進める。数学とコードに強いのはそのためである。
関連コンテンツ
QwQ-32Bに関連するツール、スキル、記事を探す。
QwQ-32Bの代替ツール

Knocket
Knocket (Tencent RTC team) · 生産性向上 · ビジネス · チャットボットKnocketは無料のライブチャット兼コンタクトページだ。訪問者はウェブサイト、アプリ、共有リンクから書き込み、こちらはTelegramか一つの受信トレイから返信する。

shippedit.me
Krawlup · マーケティング · ビジネスshippedit.me は現在 Krawlup へ転送される。SEO、AEO、表示速度を毎週監査し、修正内容を MCP 経由で AI コーディングエージェントに渡すウェブプラットフォームだ。

Ayven
Alknoma · 生産性向上 · ビジネスAyvenはAlknomaのAIコントロールセンターだ。普通の言葉で伝えた目標を日付入りの計画に変え、チームのメンバーとAIエージェントに仕事を割り振り、判断が自分の領分であるときだけ承認を求める。