
RLAMA
Dontizi · コーディング · 生産性向上
RLAMAは、自分の文書からプライベートなRAGシステムを組む無料・オープンソースのCLIツールだ。Ollama RAGの仕組みを使い、ローカルのモデルで動くため、データは端末の外に出ない。
RLAMA について
What Is RLAMA
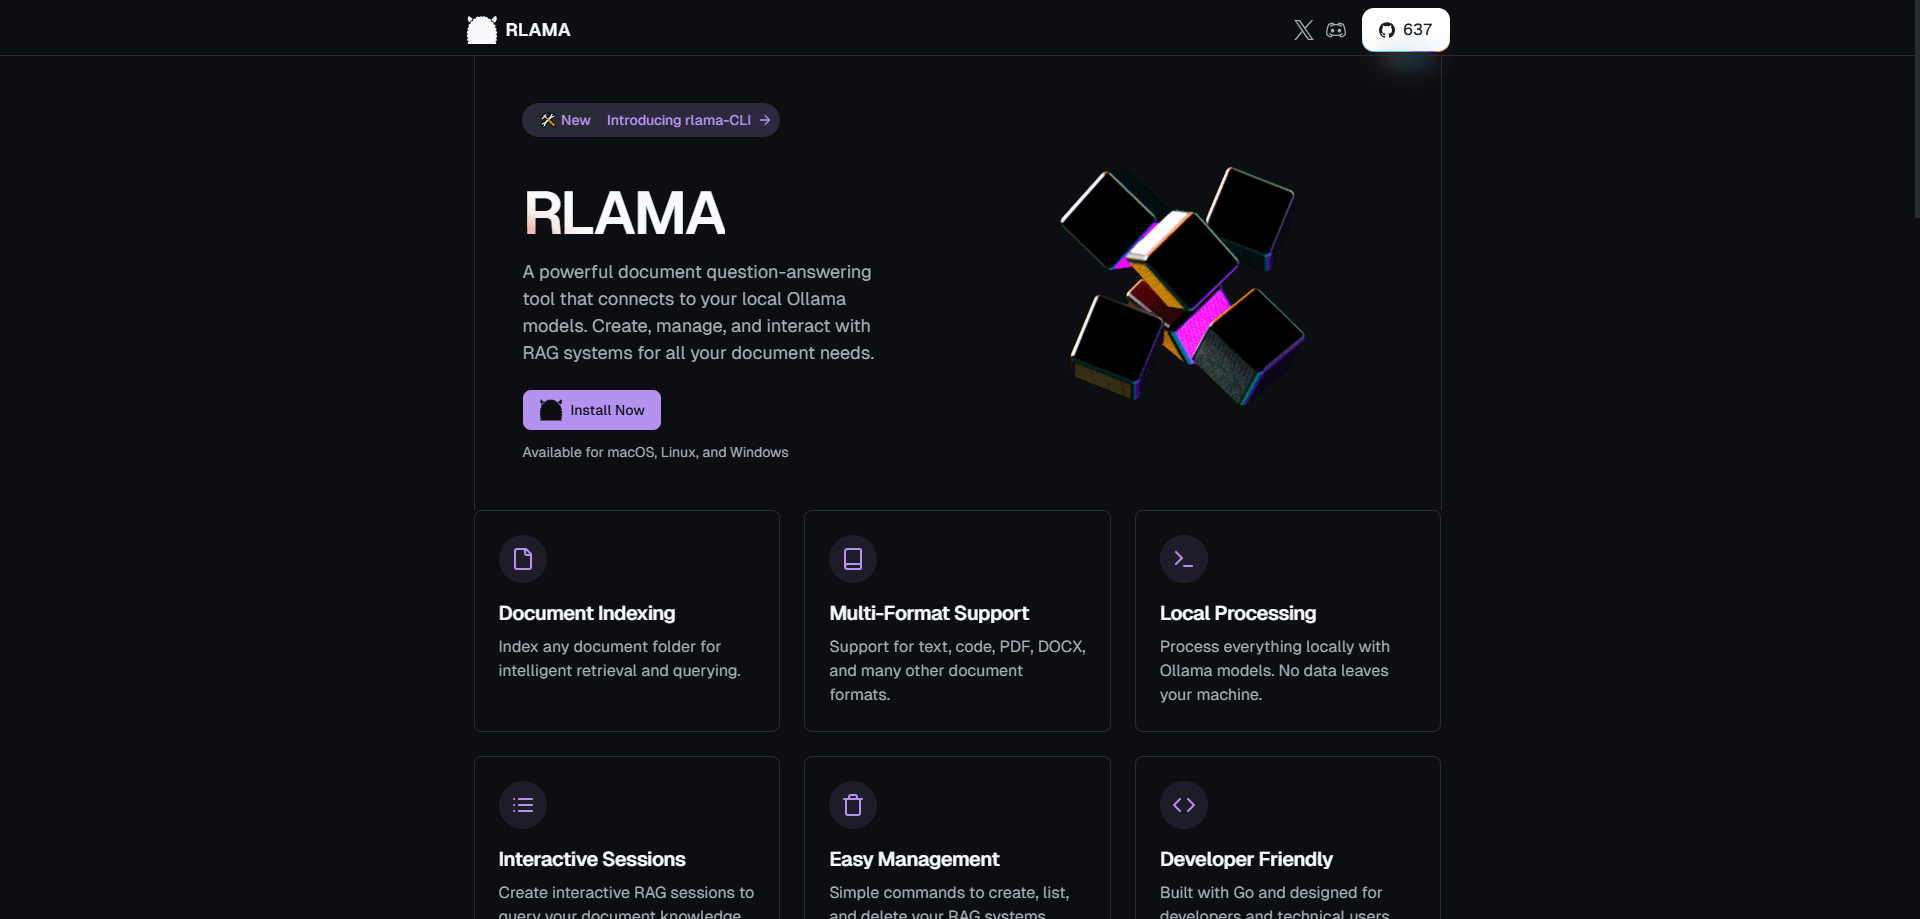
RLAMAは、自分の文書を対象にした質問応答ツールで、端末の中だけで動くように作られている。ローカルのRAGツールで、言語モデルをオフラインで走らせるOllamaと組み合わせ、フォルダ内のファイルを検索できる知識ベースに変える。開発者はApache 2.0ライセンスで公開しており、コードは開かれていて無料で使える。
仕組みは単純だ。フォルダを指定すると、RLAMAがファイルを読み、断片に分割し、各断片のベクトルをディスクに保存する。質問すると、合致する箇所を探し出し、手元のモデルに渡し、モデルはその資料を文脈にして答える。この方式を検索拡張生成(RAG)と呼び、回答を実際の出典につなぎ止める。モデルが記憶だけで推測するのを防ぐ仕掛けだ。
難点は導入にある。RLAMAはCLIであり、ワンクリックで使えるアプリではない。ターミナルで作業し、動かす前にOllamaを入れて起動しておく必要がある。ホスト版も存在しない。これはセルフホストRAGにとってむしろ本質だ。結果は選んだモデルと文書の質に左右され、非力なハードウェアや小さなモデルは回答に表れる。プロジェクトは現在休止中で、新機能はしばらく出てこない。
Getting Started
- ollama.aiからOllamaを入れ、少なくとも1つのモデルを取得する。例として ollama pull llama3 を実行する。
- 一行スクリプトでRLAMAを導入する。curl -fsSL https://raw.githubusercontent.com/dontizi/rlama/main/install.sh | sh。
- フォルダを指定してRAGシステムを作る。rlama rag llama3 my-docs ./docs。
- 対話セッションを開いて質問する。rlama run my-docs。
- 後からファイルを足すなら rlama add-docs、自動で取り込みたいならフォルダ監視を有効にする。
AIツール情報
RLAMAの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- ローカルで文書を検索したい開発者:RLAMAはコードや文書のフォルダを、クラウドAPIに何も送らずに検索可能な索引へ変える。ターミナルの作業にもなじむ。
- プライバシーを重視するチーム:処理は自分のOllamaインスタンスを通り、データは ~/.rlama に収まる。機微なファイルは端末から出ない。
- すでにOllamaを使っている人:モデルを取得して動かしていれば、RLAMAはほぼ追加設定なしでRAGの層を載せる。
- RAGの仕組みを知りたい人:公開されたGoのコードと少数の明快なコマンドで、流れ全体が見渡せる。
タスク
- 文書フォルダ全体への質問:RLAMAはフォルダ内の各ファイルを索引し、その集合から答える。1ページずつ読む必要はない。
- コードベースの調査:Go、Python、JavaScriptなどのソースに対応し、関数やモジュールのつながりを尋ねられる。
- ウェブサイトからの知識ベース構築:crawl-ragコマンドがサイトを読み、ページを索引に取り込む。
- 知識ベースの最新化:フォルダ監視とウェブサイト監視が、決めた間隔で新しいファイルやページを索引に加える。
- 他ツールへのRAG組み込み:内蔵のAPIサーバーが照会エンドポイントを公開し、自分のスクリプトやアプリから呼べる。
シーン
- 顧客契約をどこにもアップロードできないフリーランス:ローカル索引ならファイルは1台のノートPCに残り、回答も非公開のままだ。
- 大きなリポジトリを探す開発者:断片の確認と意味ベースの分割が、ファイル全体ではなく適切な箇所を見つける助けになる。
- PDFを山ほど抱えた研究者:RLAMAはPDF、DOCX、EPUBを読む。論文の山が質問できる対象になる。
- 小さなモデルを試す趣味の人:Hugging Face連携で、RAGを組む前にGGUFモデルを試せる。
主な機能
ローカルRAGパイプライン
ragコマンドでフォルダを索引し、runコマンドで照会し、~/.rlama内のローカルファイルで全体を保つ。文書は読み込まれ、分割され、Ollama経由でベクトルになり、ディスクに保存される。外部サーバーには一切触れない。これがこのツールの狙いだ。
複数の分割方式
RLAMAは文書を4通りに分ける。固定長、意味ベース、階層、ハイブリッドだ。ハイブリッドはファイル種別ごとに最適な方法を選び、Markdownは見出しで、コードは関数とクラスで、プレーンテキストは段落で切る。断片の質が検索精度を左右し、多くのローカルRAGツールがここで足踏みする。
ウェブサイトの取得と監視
crawl-ragコマンドはフォルダではなくサイトからRAGを組む。深さ、並列数、除外パスを調整できる。web-watchはそのサイトを見張り、新しいページを索引へ取り込む。ドキュメントサイトを手作業で再索引せずに最新へ保てる。
フォルダ監視
RAGにフォルダを割り当て、一定間隔で確認させるか、そのRAGを使うときだけ確認させられる。新しいファイルは自動で索引に入る。変更のたびにadd-docsを走らせる手間が消える。
内蔵APIサーバー
apiコマンドがHTTPサーバーを起動し、単一の POST /rag エンドポイントがRAG名、プロンプト、任意のコンテキスト数を取る。ローカル文書の質疑応答を、スクリプトや小さなアプリ、CLIを話さないツールに組み込める。
OllamaとHugging Faceのモデル
RLAMAはベクトル化も生成もOllamaに頼り、Ollamaが動かせるモデルなら何でも受け付ける。hf-browseとrun-hfコマンドはHugging FaceのGGUFカタログに届き、RAGに組み込む前にモデルを探して試せる。
メリットとデメリット
メリット
- 完全にオフラインで動く。文書は端末から出ず、照会ごとの費用もかからない。
- Apache 2.0で無料かつオープンソース。単一のGoバイナリを一行で導入できる。
- 4つの分割方式とウェブクローラーを備え、多くのローカルRAG入門ツールより踏み込んでいる。
- 内蔵APIサーバーにより、CLIが他ツールから呼べる存在になる。
- Linux、macOS、Windowsで動き、クラウドに依存しない。
デメリット
- CLI専用のため、デスクトップアプリを期待する人はターミナルで作業することになる。
- 導入にはOllamaの起動とモデルの取得が先に必要で、この手順が初心者を止める。
- 回答の質は選んだモデル次第で、小さなモデルと非力なハードでは結果が浅くなる。
- 開発は休止中で、新機能は当面なく、修正も遅くなる。
よくある質問
RLAMAは自分のファイルの上に非公開の質問応答システムを組む。フォルダかウェブサイトを索引し、質問するとその内容から回答が返る。すべてローカルのOllamaモデルで動く。
関連コンテンツ
RLAMAに関連するツール、スキル、記事を探す。
RLAMAの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。