
Soup CLI
MePlay, Inc. · コーディング
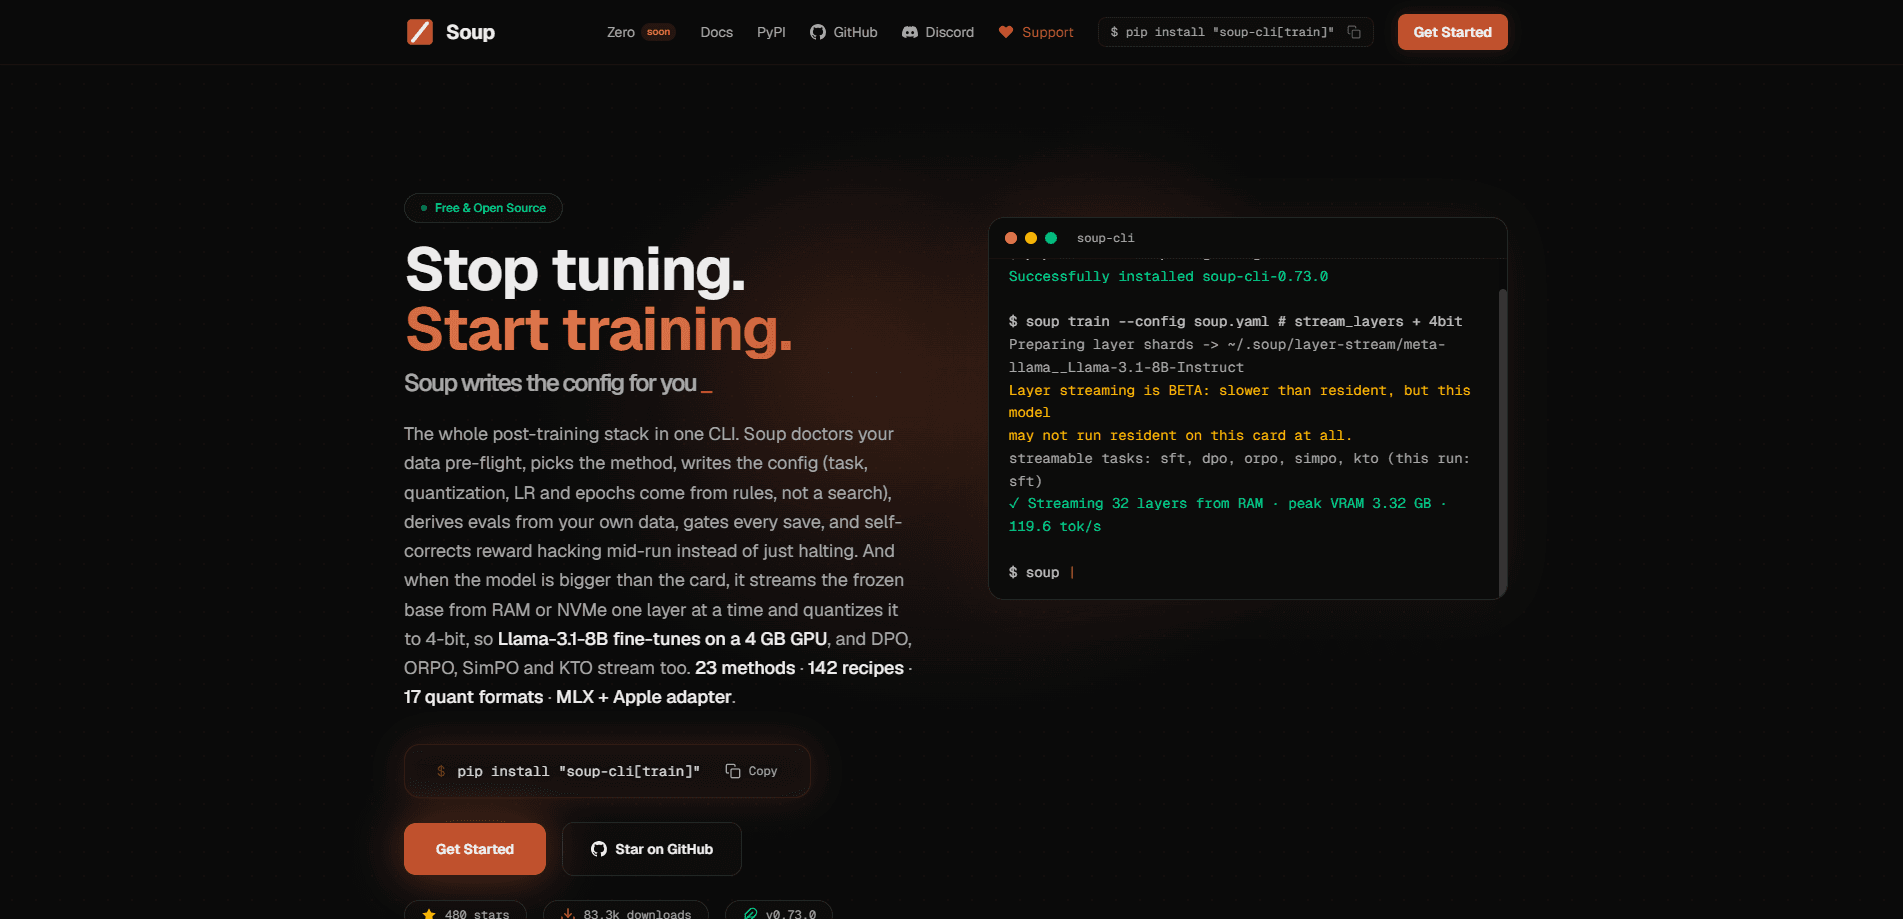
Soup CLI は、大規模言語モデルをファインチューニングおよびポストトレーニングするためのオープンソースのコマンドラインツールだ。LLM ファインチューニングツールとして、いつものセットアップ作業を一つの流れにまとめる。YAML ファイルを一つ書き、`soup train` を実行すれば、Soup が GPU 検出、バッチサイズ、量子化を自分で処理する。このプロジェクトは、クラウド GPU を借りたり訓練スクリプトと格闘したりせず、モデルをローカルでファインチューニングしたい人向けに作られている。目玉機能のレイヤーストリーミングを使えば、8B モデルをわずか 4 GB の VRAM しかないノート PC の GPU で訓練できる。
Soup CLI について
Soup CLI とは何か
Soup CLI(soup-cli という Python パッケージとしても公開されている)は、ポストトレーニングのループ全体をカバーする CLI 中心のスタックだ。データのクリーニング、手法の選択、設定の生成、評価、チェックポイントの選別まで含む。MePlay, Inc. が保守し、Apache-2.0 ライセンスで公開されているため、ソースを読み、フォークし、自分のパイプラインに組み込むことができる。
それが解決する主な問題は手間だ。モデルを訓練したことのある人なら分かるはずだ。ハードウェアを選び、依存関係の衝突と戦い、バッチサイズを当て推量し、ステップ 400 でクラッシュをデバッグする。Soup はそれを、自分の代わりに書いてくれる設定ファイル一つに圧縮する。なぜ重要か。初心者のファインチューニングのほとんどは、訓練そのものではなくセットアップで潰れるからだ。対象は、インフラエンジニアにならずに動くファインチューニングを求める開発者、研究者、小規模チームだ。
最大の制約はハードウェアだ。訓練には依然として CUDA GPU が要るし、普通のマシンで実際の 7B〜8B ジョブを回すなら、フル精度の訓練ではなく QLoRA と量子化された重みを受け入れることになる。それがトレードオフだ。小型 GPU を使い物にする機能であるレイヤーストリーミングは、今も BETA 表示で、手動でオンにする必要がある。
はじめ方
- パッケージをインストールする。
pipx install "soup-cli[train]"かuv tool install "soup-cli[train]"を使う。素のsoup-cliは PyTorch なしの軽量 CLI なので、ファインチューニングには[train]エクストラが要る。 - 設定を生成する。
soup init --template chatを実行し、チャット形式のファインチューニング用のsoup.yamlの雛形を作る。 - データとベースモデルを指定する。YAML を編集して、データセットのパスと適応させたいモデルを設定する。
- 訓練を始める。
soup trainを実行し、GPU を検出させて設定を選ばせる。大きなモデルを小さなカードで扱うなら、先にstream_layers: trueを設定する。 - 結果を配信または書き出す。
soup serveを使い、調整後のモデルを OpenAI 互換の API エンドポイントの背後に公開する。
AIツール情報
Soup CLIの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 個人開発者と趣味の人:コンシューマー向け GPU を一つ持ち、クラウドの計算費を払わずにモデルをファインチューニングしたい人。CUDA カード、Apple Silicon、または CPU が必要だ。
- ML エンジニアと研究者:アドホックなスクリプトではなく、バージョン管理された YAML で定義した再現可能なポストトレーニングパイプラインを求めるチーム。
- 小規模スタートアップ:自社モデルを提供するにあたり、重みとデータをホスティング型の訓練サービスに送らず、手元に置いておきたいグループ。
タスク
- 教師ありファインチューニング:自分のデータセットを使い、ベースモデルをチャット形式や狭い領域に適応させる。
- 選好最適化:DPO、KTO、GRPO、BCO を実行し、モデルを人間または報酬の選好に寄せる。
- ローカル実験:本格的な訓練に踏み切る前に、モデルがそのタスクをそもそも学習できるかを試す。
シーン
- ノート PC だけのワークフロー:レイヤーストリーミングを有効にして、4 GB の GPU で量子化した 8B モデルを訓練する。
- プライベートなファインチューニング:自社データとモデルの重みを、自分で管理するハードウェアに置く。
- 調整済みモデルのサービス化:`soup serve` で OpenAI 互換のエンドポイントを立ち上げ、社内アプリやデモに使う。
主な機能
設定一つ、コマンド一つ
中心となる考え方は、一つの YAML ファイルがジョブ全体を記述するというものだ。soup init で開始用の設定を生成し、いくつかフィールドを編集して、soup train を実行する。Soup は設定を読み、GPU を確認し、合うバッチサイズと量子化を選ぶ。訓練用の shell スクリプトをフォルダごと管理してきた人には、そこが魅力だ。設定がそのままドキュメントになる。
小さな GPU のためのレイヤーストリーミング
レイヤーストリーミングは最も注目される機能だ。凍結したベースモデル全体を VRAM に載せる代わりに、Soup はそれをメモリの外に置き、デコーダ層を一つずつ GPU に流し込む。4 GB の RTX 3050 Laptop で、8B モデルがピークメモリ 3.32 GB で動くとプロジェクトは報告する。大きな成果だ。ただし、これは任意機能で今も BETA であり、スループットの数値は特定の旧バージョンのものだ。だから速度は約束ではなく下限として捉えたほうがいい。
組み込みの評価とチェックポイント選別
Soup は訓練で止まらない。設定から評価を導き、それに照らしてチェックポイントを選別するため、劣化した実行は黙って保存されずに警告される。頻繁に訓練するチームにとって、これは生の速度よりも大事だ。前より悪いチェックポイントを教えてくれるパイプラインが欲しいはずだ。
OpenAI 互換の配信
soup serve コマンドは、訓練済みモデルをコマンド一つで API サービスに変える。標準の /v1/chat/completions、/v1/models、/health エンドポイントを公開し、ストリーミング応答に対応し、スループットを上げるために vLLM や SGLang のバックエンドに切り替えられる。LoRA アダプタはそのまま配信でき、ベースモデルはアダプタ設定から解決されるので、重みを手作業で先にマージする必要はない。
ローカル優先、クラウド不要
すべては、すでに持っているハードウェアで動くように設計されている。クラウドは不要だ。必須のアカウントも、ホスティング型のダッシュボードもなく、自分で設定しない限りデータがマシンから出ることもない。機密データを扱うチームにとって、管理型の訓練サービスに対する決め手はここであることが多い。
データツールと検査コマンド
軽量な soup-cli インストールにも、soup data ... と、PyTorch なしで動く検査コマンドが含まれる。つまり、GPU が一切ないマシンでもデータセットをクリーニングし、検査できる。今準備して、後で訓練する。
メリットとデメリット
メリット
- Apache-2.0 のオープンソースなので、ベンダーロックインがなく、ソースを完全に監査できる。
- YAML 設定ファイル一つで、ファインチューニングが通常要求するスクリプトとセットアップのほとんどを置き換えられる。
- レイヤーストリーミングにより、本当に大きなモデルを小型のコンシューマー GPU で訓練できる。
- 配信と評価が同じツールの一部であり、自分でつなぎ合わせる別々のユーティリティではない。
- 完全にオフラインで動くため、データと重みが自分のハードウェアに留まる。
デメリット
- 目玉機能のレイヤーストリーミングは今も BETA で、手動で有効にする必要があるため、設定して放置できる選択肢ではない。
- 最高の性能は CUDA GPU を前提とする。Apple Silicon と CPU の対応は実験的で遅い。
- 分割インストールは初心者を混乱させる。素の `pip install soup-cli` では `[train]` エクストラを足すまで訓練できない。
- ドキュメントは密度が高くバージョン固有なので、古いガイドの助言が現行リリースと合わないことがある。
よくある質問
大規模言語モデルをファインチューニングおよびポストトレーニングするためのオープンソースのコマンドラインツールだ。YAML ファイル一つにジョブを定義して soup train を実行すると、GPU 検出、量子化、バッチ処理を代わりに処理する。
関連コンテンツ
Soup CLIに関連するツール、スキル、記事を探す。
Soup CLIの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。