
UbiOps
UbiOps · 生産性向上 · マーケティング · 学習 · その他
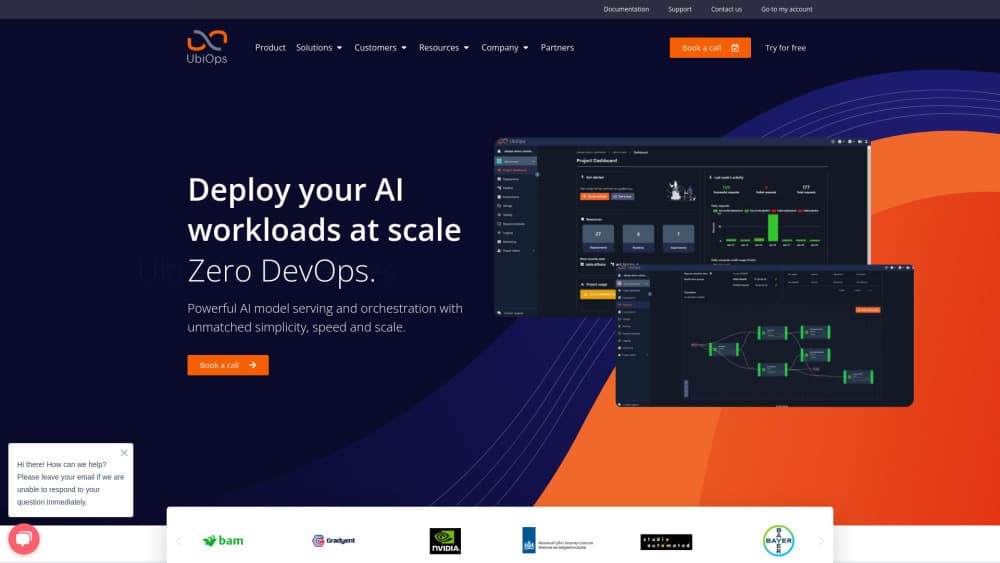
UbiOpsは、PythonコードやLLMをスケールするAPIに変えるAIモデル配信プラットフォームだ。MLOpsの機能も一通り揃い、自社クラウド、オンプレミス、あるいはその両方で同時に動かせる。
UbiOps について
About
UbiOpsとは
UbiOpsは、自前の配信レイヤーを組まずにAIを本番へ出したいチーム向けのオランダ製MLOpsプラットフォームだ。渡すのはモデルのコードかコンテナイメージだけでいい。コンテナのビルド、APIエンドポイントの公開、リクエストのキュー、負荷分散、オートスケーリング、そしてログとメトリクスまでプラットフォーム側が引き受ける。
本当の売りはインフラの自由度にある。コントロールプレーンが複数の計算環境の上に座り、それらを1つのリソースプールとして扱う。だから同じ処理が昼は社内のGPUで動き、夜にはパブリッククラウドのリージョンへ流れる。これがハイブリッドクラウドAIの実態で、データの所在規則を持つ病院、電力会社、公共機関が選ぶ理由でもある。彼らはモデルAPIの事業者にデータを渡せない。
制約も先に書いておく。ビジュアルなモデル構築ツールも、既製アプリのカタログもない。動くコードとDockerの基礎知識、エンドポイントが何を受け取るかの設計が要る。ノーコードのチャットボット作成ツールを探しているなら、製品違いだ。
使い始める
- UbiOpsのWebアプリでアカウントを作り、スクリプトで扱うならPythonクライアントかCLIを入れる。
- 依存関係を含めた環境を定義する。用意されたPythonランタイムが合わなければ、自前のDockerイメージをpushすればいい。
- デプロイを作成し、コードをアップロードして、APIの入出力スキーマを宣言する。
- インスタンスタイプを選び、インスタンス数の下限と上限を決める。トラフィックが波状ならゼロスケールを有効にする。
- エンドポイントにリクエストを送って動作を確かめ、一連の流れが必要になったら複数のデプロイをパイプラインでつなぐ。
AIツール情報
UbiOpsの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 機械学習エンジニア:配信レイヤーの作業をプラットフォームが持つため、デプロイ用のコードを自分で書ける人なら、プラットフォームチームなしで機械学習モデルをエンドポイントとして公開できる。
- 規制産業のデータサイエンスチーム:病院、電力会社、公共機関はデータを自社ハードウェアに置いたまま、オートスケーリングと監視を手に入れられる。マネージドの推論サービスではほぼ得られない条件だ。
- プラットフォーム/MLOpsエンジニア:インスタンスタイプのグループと複数環境の制御により、クラウドと社内クラスタへ作業を振り分ける窓口が1つにまとまる。
タスク
- モデルをRESTエンドポイントとして配信する:コードを上げれば、負荷分散と文書化されたリクエスト形式を備えたバージョン付きAPIが半日で手に入る。
- 自社GPUでLLM推論を回す:既製のGenAIサーバーを自前のDockerイメージでデプロイし、アクセスがなければプラットフォームに停止させる。
- 前処理、モデル、後処理をつなぐ:パイプラインがデプロイ間でデータを渡し、分割、絞り込み、条件分岐を組み込みのオペレーターでまかなう。つなぎ込みのコードはほとんど要らない。
- 一時的な計算力が要る学習ジョブ:実験と学習実行は同じ計算プールを使うため、長時間のジョブが社内クラスタにないクラウドGPUを借りられる。
シーン
- ピークが読めないコンピュータビジョンサービス:オートスケーリングがリクエストを複数インスタンスへ分散し、キューが空になれば容量を戻す。
- 試作から製品へ移す段階:ノートPCで動かしたデプロイが、インスタンス上限を上げるだけで本番トラフィックを捌く。
- 特定クラウド事業者からの脱却:コントロールプレーン経由で環境間を移動できるため、数年がかりの移行でも囲い込みを減らせる。
主な機能
管理されたAPIエンドポイント付きのデプロイ
デプロイごとにバージョン付きHTTPエンドポイント、リクエストキュー、入力検証が付く。対応ランタイムか自前のコンテナでコードを渡せば、ビルド、起動、公開までプラットフォームが行う。新しいバージョンは旧版を消さずに昇格も切り戻しもできるので、失敗したリリースは2クリックで戻せる。
オートスケーリングとゼロスケール
プラットフォームはリクエスト量を見ながらインスタンスを増減する。ゼロスケールは使われていないデプロイを完全に止める。GPUモデル配信では、この停止が費用を大きく左右する。、1日に数回しか呼ばれないモデルが24時間分の遊休GPU代を払うことはない。インスタンスタイプのグループを使えば、社内GPUを優先し、埋まったときにクラウドへ逃がせる。
パイプラインとワークフローオペレーター
AIオーケストレーションは多くのチームが軽く見る部分で、ここがプラットフォームの価値を決める。AIパイプラインは複数のデプロイを1つの呼び出し可能なサービスにまとめ、中の各オブジェクトが独立してスケールする。組み込みオペレーターがデータの分割、再構成、絞り込み、条件分岐を担うので、手書きしていた配線の大半が不要になる。パイプラインは入出力して同僚と共有できる。
学習実験と実行
配信だけでなく、UbiOpsは同じインフラで学習ジョブも動かす。実験が環境、コード、ハードウェアを固定し、学習実行がその下で走る。結果はWebアプリで実行間比較ができる。成果物は自分で管理するストレージに残るので、学習済みモデルはデプロイまであと一歩だ。
カスタムサービスと自前のDockerイメージ
サービスはデプロイ内に長時間動くHTTPサーバーを公開する。標準のリクエスト形式に収まらない高スループットのGenAIサーバーはこの形で動かす。自前のDockerイメージと組み合わせれば、vLLM系の推論スタック、複数エンドポイントのアプリ、生のHTTPを前提とするものまで対応できる。
監視、バージョン管理、アクセス制御
ログ、利用メトリクス、アラートはプラットフォームに含まれる。壊れたデプロイは利用者の指摘より先に表に出る。ロールベースの権限、監査ログ、暗号化がコンプライアンス側を覆い、データ処理の設定でペイロードを保存するかどうかを決められる。
メリットとデメリット
メリット
- 自社ハードウェアでもパブリッククラウドでも、その混在でも動く。マネージドの推論サービスではほとんど許されない。
- オートスケーリングにゼロスケールが含まれ、波のあるモデルや低頻度のモデルでも費用が膨らまない。
- オペレーター込みのパイプラインが、多段のAI処理に必要なつなぎ込みコードを減らす。
- バージョン管理と切り戻しがあるため、専任のリリース工程を持たないチームでもモデル更新のリスクを抑えられる。
- 同じプラットフォームが配信と学習の両方を担うので、計算力のために別の事業者を探さずに済む。
デメリット
- 公開価格表がない。月額を見積もる前に営業と話す必要があり、予算計画が遅れる。
- デプロイ用のコードを書き、コンテナを理解する必要がある。アナリストや業務ユーザーだけでは前に進まない。
- 画面は環境、インスタンスタイプ、リクエストといったMLOpsの語彙を前提にしている。最初の1週間は資料を読む時間が要る。
- 基盤モデルの学習や微調整を代行する機能はない。あくまで自分のコードを動かす製品なので、モデル側の作業は手元に残る。
よくある質問
モデルやデータ処理のコードを本番用APIとして動かす。コンテナをビルドし、サービスを起動し、リクエストを複数インスタンスへ分散させ、トラフィックに応じて容量を調整する。
関連コンテンツ
UbiOpsに関連するツール、スキル、記事を探す。
UbiOpsの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Knocket
Knocket (Tencent RTC team) · 生産性向上 · ビジネス · チャットボットKnocketは無料のライブチャット兼コンタクトページだ。訪問者はウェブサイト、アプリ、共有リンクから書き込み、こちらはTelegramか一つの受信トレイから返信する。

FloorGen
Vinit Kumar (FloorGen) · 生産性向上 · 中国のAIFloorGenはブラウザで動く間取り作成ツールだ。文章かスケッチから編集できる2D間取り図と3Dウォークスルーを作る。PDF、DXF、動画に書き出せ、アカウントなしでも描き始められる。