

Web Bench
Skyvern and Halluminate · コーディング · 生産性向上
Web BenchはSkyvernとHalluminateが作ったAIウェブ閲覧エージェントのベンチマークで、452サイト・5,750タスクで性能を測る。
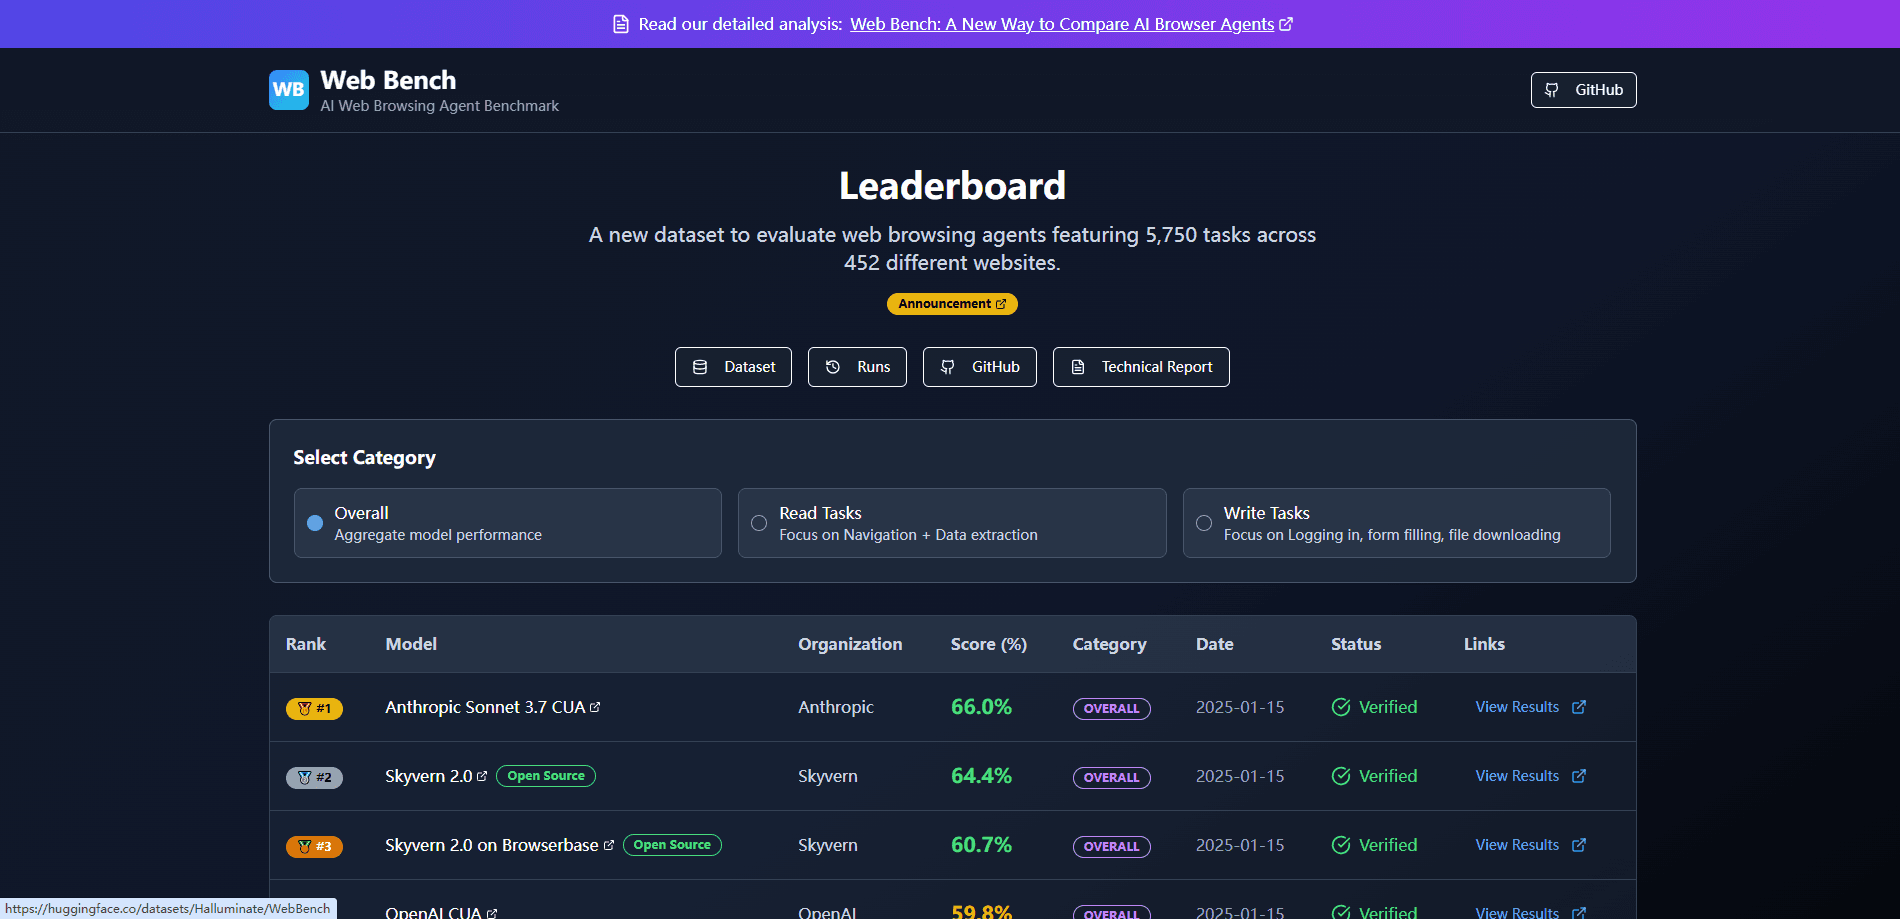
Web Bench について
What Is Web Bench
Web Benchは、AIブラウザエージェントが実稼働中のサイトで本物のタスクをどれだけこなせるかを測るベンチマークだ。SkyvernとHalluminateが公開した狙いは、15サイト・643タスクしかなかった旧版WebVoyagerの置き換えにある。今やブラウザを操るエージェントは求職応募や請求書の取得、税務フォームの記入まで担う。より広い土台が必要だった。
このベンチマークは各タスクを二種類に分ける。読み取りタスクはサイトをたどって情報を抜き出す作業を指す。書き込みタスクはログイン、フォーム記入、二段階認証の突破、ファイルのダウンロードを指す。書き込みタスクは以前のベンチマークにほとんどなく、多くのエージェントがここでつまずく。この切り分けが、ただのチャットボット試験ではなくブラウザエージェントの評価だという性格を決めている。
弱点は範囲と更新頻度にある。対象は世界のアクセス上位1,000サイトに入る英語圏のサイトだけで、ウェブのごく一部だ。結果もチームが題材を再実行したときにしか動かない。測るのは精度・コスト・速度であり、エージェントを口座に残しておいて安全かどうかではない。
Getting Started
- webbench.aiの公開ランキングを開き、総合・読み取り・書き込みのスコアで各エージェントを比べる。
- GitHubかHugging Faceのオープンデータを見て、実際のタスクとサイト一覧を確かめる。
- 技術レポートを読み、各実行がどう採点・検証されたかを把握する。
- エージェントを作っているなら、Halluminateチームに連絡して自分の結果をランキングに載せる。
AIツール情報
Web Benchの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- AIエンジニア:点数表を読めるなら、ベンダーの言葉ではなく証拠で閲覧エージェントを選べる。
- プロダクトチーム:顧客に出す前に、フォーム記入や請求書取得をこなせる段階かを判断できる。
- 研究者:オープンなデータで読み取りと書き込みの失敗パターンを調べられる。
タスク
- 自社版の評価:自分のエージェントを題材に走らせ、既知の競合とスコアを並べて比べる。
- エージェントの選定:単一の総合点ではなく、自分の業務に合うタスク種別でランキングを並べ替える。
- 弱点の特定:失敗の内訳を読み、誤りがモデル由来か、ブラウザ基盤由来かを見分ける。
シーン
- コンピュータ操作エージェントの導入直前で、ログインや決済を突破できる証拠が要るチーム。ブラウザ内で動くコンピュータ操作エージェントは、ここで最も直接的な信号を得る。ウェブエージェントのランキングはタスク種別ごとに並べ替えられる。
- ブラウザ自動化の二社を比べていて、共通の物差しが欲しいスタートアップ。
- レポートに最新のブラウザエージェント精度を引用したいライターやアナリスト。
主な機能
読み取りと書き込みの分離
Web Benchはデータを取るタスクと変えるタスクを分ける。読み取りは回遊と抽出、書き込みはログインやフォーム入力、二段階認証、ダウンロードを担う。この分離が効くのは、読み取りで光るエージェントがサイトを書き換える操作で崩れるからだ。
452サイト・5,750タスク
題材はアクセス上位1,000サイトから選んだ452サイトで5,750タスクを走らせる。広さが要点だ。以前のベンチマークは数サイトしか試さず、エージェントはレイアウトを覚えられた。サイトが増えれば、実際に使うページへ結果が移りやすくなる。
オープンなタスクデータ
約2,454タスクがGitHubとHugging Faceでオープンデータとして公開される。指示を検分し、題材を再実行し、学習に使うこともできる。閉じたランキングを疑うチームにとって、採点が追える状態を保てる。
エージェント失敗と基盤失敗の分離
失敗した実行には原因の印が付く。エージェントの誤りは回遊の失敗、達成の思い込み、タイムアウト、抽出の誤りを指す。基盤の誤りはプロキシ遮断、CAPTCHA、ログイン時のボット判定を指す。この分離で、モデルを直すのかブラウザ環境を直すのかが分かる。
コストと速度の指標
精度だけでなく、Web Benchはタスクごとの実行時間とステップ数を追う。ステップ数が多くのエージェントの費用を決めるため、実運用でいくらかかるかの見積もりに役立つ。時間課金とステップ課金のどちらが合うかも見えてくる。
コパイロットと自律の二モード
ランキングは二つの構成を採点する。自律ベンチマークは人手を挟まず走らせる。コパイロットのベンチマークは人が輪に入った状態で走らせる。両者を比べれば、人が工程に関わることで結果がどれだけ変わるかが分かる。
メリットとデメリット
メリット
- 以前のベンチマークが省いたログイン、CAPTCHA、フォーム記入という実際の摩擦を捉える。
- オープンなデータと実行ログがあるため、チームは点数を信じるのではなく確かめられる。
- 読み取りと書き込みの分離により、結果を特定の業務に結び付けられる。
- ステップ数と時間を含むので、精度とコストを並べて判断できる。
デメリット
- 英語圏のサイトしか対象にせず、多言語のエージェントはここで信号を得られない。
- 上位1,000サイトから抽出するため、ニッチや地域限定のページは試されない。
- 点はチームが題材を再実行したときにしか更新されず、新しいエージェントに遅れることがある。
- 書き込みタスクの上限が全体に低く、現行最強のエージェントでも低い数字しか出ない。
よくある質問
AIブラウザエージェントが実サイトで本物のタスクをこなす精度と、各実行にかかるステップ数・時間を測る。どの結果も精度とコスト、速度の信号が混ざっている。
関連コンテンツ
Web Benchに関連するツール、スキル、記事を探す。
Web Benchの代替ツール
Forefront
Forefront · コーディングForefrontはオープンソースAIで構築するためのウェブプラットフォームだ。主要なオープンソース言語モデルを自分のデータで微調整し、性能を評価し、API経由で実行したり、エクスポートして自分でホストしたりできる。クローズドなプラットフォームの手軽さを求めつつ、モデルとデータの所有権にはこだわる開発者が対象だ。

Startkit
StartKit.AI · コーディングStartkitは、AI SaaSとAIラッパー製品を作るためのボイラープレートだ。面倒な部分をあらかじめ配線済みにしたAIスタートアップボイラープレートと考えればいい。認証、StripeとLemon Squeezyの決済、利用制限、トランザクションメール、そしてOpenAI、Anthropic、Groq、Llamaと通信するAI APIスターターキットが含まれる。リポジトリをクローンして価格を設定し、ユーザーが実際にお金を払う部分に取りかかれる。ReactとTailwind上のNext.jsで作られているため、ボイラープレートコードの多くはすでに見慣れたものだ。
Testim
Tricentis · コーディングTestimは、Web・モバイル・Salesforceアプリ向けにエンドツーエンドテストを構築して実行するAIテスト自動化プラットフォームだ。機械学習を頼りに、インターフェースが変わってもテストを安定させ、チームが壊れたセレクターの修正に費やす時間を減らす。今日から使い始められる自動テストツールとしては悪くない。ブラウザで操作を録画してテストを作り、より細かい制御が必要なときはJavaScriptを足す。忙しいQAチームにとって堅実な選択肢である。