
ZeroGPU
ZeroGPU.ai · 生産性向上
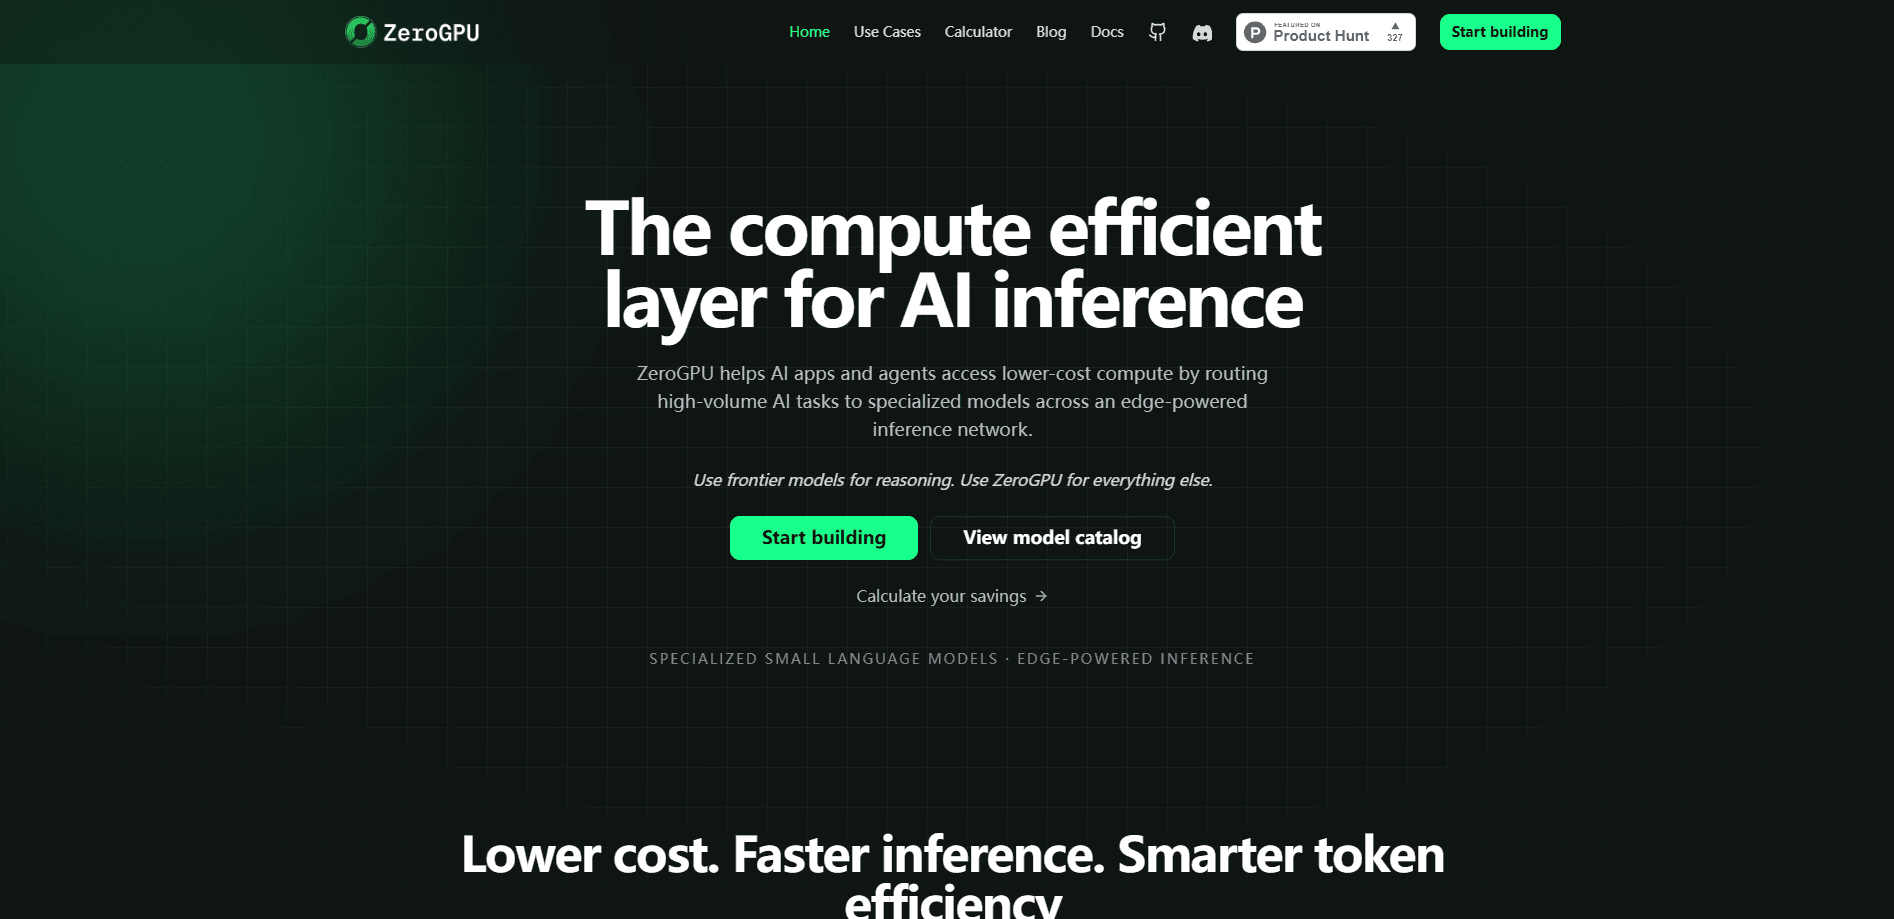
ZeroGPUはエッジAI推論プラットフォームだ。高価なフロンティアGPUではなく、特化型の小型モデルとオープンウェイトモデルで大量のAIワークロードを処理する。狙うのは、サポートチケットの仕分け、スパムの警告、AIコンテンツモデレーションなど、本番トラフィックの大半を占める反復作業である。売りはシンプルだ。呼び出し1回あたりの支払いが減る。OpenAI互換APIを公開しているため、チームはそれを既存のパイプラインに差し込み、トークン単位で支払える。これで低レイテンシ推論が本番規模でも手の届くものになる。
ZeroGPU について
ZeroGPUとは
ZeroGPUはAI推論における計算効率のレイヤーだ。背景にある考えは率直である。ほとんどのAIワークロードはフロンティアモデルを必要としない。サポートチケットを仕分けたりスパムコメントに警告を付けたりするのに、多段階のコーディング問題を解くのと同じ推論力は要らない。ZeroGPUはそうした繰り返し可能な作業を小型およびnano言語モデルに振り分け、集中型GPUではなくエッジデバイスのネットワーク上で動かす。同社は従来のGPUクラウドと比べて推論コストが50〜70%低く、特化したワークロードでは最大10倍速いと主張する。ただし性能はワークロード、モデル、構成によって変わるとも明記している。
これが解く主な問題は経済性だ。何百万件もの項目を分類するのにフロンティアモデルの料金を払えば、請求額は量に応じて膨らみ、すぐに痛手になる。エッジハードウェア上の小型モデルは、本番トラフィックの大半を占める絞り込まれたタスクでコストとレイテンシの両方を下げる。代償は能力である。ZeroGPUは複雑な推論、長いコンテキストの分析、開かれた生成向けには作られていない。そこは依然としてフロンティアモデルの領域だ。ZeroGPUはそれらと並んで、大量の実行レイヤーを担う。
もう一つ知っておきたい制約がある。このプラットフォームはオープンウェイトモデルに頼るため、出力の品質はワークロードがどのモデルに割り当てられるかに左右され、完全に自前で訓練したモデルほどの柔軟性は得られない。新しいタスクやニッチなタスクには、まだ対応する小型モデルがない可能性がある。
始め方
- ZeroGPUのプラットフォームで登録し、ダッシュボードでAPIキーとプロジェクトIDを確認する。
- 既存のOpenAI SDKクライアントを
https://api.zerogpu.ai/v1に向けるか、x-api-keyとx-project-idヘッダーを付けてリクエストを送る。 - モデルカタログからタスクに合うモデルを選ぶ。たとえば分類やモデレーションのバリアントだ。
- responsesエンドポイントに最初のリクエストを送り、出力がパイプラインの想定と一致するか確認する。
- 呼び出しを本番に組み込み、プランの残高に対して利用量を追跡する。
AIツール情報
ZeroGPUの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- バックエンドエンジニアとMLエンジニア
- AIプロダクトチーム
- 利益率の厳しいスタートアップ
タスク
- サポートチケットの振り分け
- コンテンツモデレーション
- データ抽出
- 感情分析
シーン
- 大量の項目に対して毎日バッチ分類を実行する
- リードスコアリングや行動シグナルで顧客プロファイルを充実させる
- 公開前にユーザー生成コンテンツをふるいにかける
主な機能
OpenAI互換API
ZeroGPUはhttps://api.zerogpu.ai/v1でOpenAI互換のエンドポイントを公開する。すでにOpenAI SDKを使っているなら、それをZeroGPUに向けるだけでコードの大半をそのまま使える。認証は標準のベアラトークンではなく、x-api-keyとx-project-idヘッダーで行う。これは小さな設定変更であり、書き直しではない。既存のパイプラインにとって導入を安くする機能はこれだ。摩擦が減り、切り替えが速い。
特化した小型・nanoモデル
このプラットフォームは各ワークロードを、そのタスク向けに選ばれた小型またはnanoモデルに割り当てる。分類や抽出の専用モデルは、その絞り込まれた作業では大きな汎用モデルを上回り、しかも安く速く動く。モデルカタログから適切なものを選べ、ルーティングはシステムが裏で処理する。適材適所である。
エッジが支える推論ネットワーク
ZeroGPUは単一の集中GPUクラスタではなく、エッジデバイスのネットワーク上でワークロードを動かす。同社は10万台以上のエッジデバイスを挙げ、本番規模でもレイテンシが低く保たれる理由としてこのネットワークを示す。なぜ重要か。反復作業では、計算をリクエストに物理的に近づけると往復時間が縮む。
コストとレイテンシの削減
目玉は、従来のGPUクラウドと比べて推論コストが50〜70%低く、特化したワークロードでは最大10倍速いという点だ。要するに安くて速い。同社は結果がワークロード、モデル、構成によって変わると明言しており、この数字は出発点の目安であって保証ではない。サイト上の削減計算ツールを使えば、契約前に効果を見積もれる。AIコンテンツモデレーションや大量分類では、ここでこのプラットフォームの価値が効いてくる。
幅広い活用例の網羅
活用例のカタログは、広告意図の分類、メールの仕分け、コンテンツモデレーション、サポート自動化、データ充実、100以上の言語の翻訳、パーソナライズ、文書OCR、不正検出、PIIのマスキング、ジェイルブレイク検出、マルチモーダル推論に及ぶ。この広さは重要だ。多くの異なるプロダクトの実行レイヤーを狙っており、単一のニッチではないことを示す。
エージェントに優しい購入導線
ZeroGPUはAIエージェントへ直接販売する。エージェント向けストアフロントが価格と支払い手順を公開し、エージェントは登録フローや人手を介さずに認証情報を登録してプランを購入できる。支払いはx402かMPPでウォレット決済、または人の助けを借りてカードで行う。自律型パイプラインを狙った珍しい仕組みだ。
メリットとデメリット
メリット
- OpenAI互換APIにより、すでにOpenAI SDKを使うチームは設定変更ひとつで移行できる。
- トークン単位の課金により、コストは固定のGPU予約ではなく実際の利用量に応じて伸縮する。
- 50〜70%のコスト削減と最大10倍のレイテンシ改善という数字は、本番トラフィックの大半を占める大量タスクを狙っている。
- エージェント向けストアフロントと自律購入は、人手の登録を待てない自動化パイプラインに合う。
- 幅広い活用例のカタログがモデレーション、分類、抽出、OCR、翻訳を押さえる。
デメリット
- 小型・オープンウェイトモデルは複雑な推論や長いコンテキストの作業でフロンティアモデルに及ばないため、そこは別のプロバイダーが要る。
- 削減幅はワークロードと構成で変わるため、実際の効果は契約前に自分で測定する必要がある。
- 出力の品質はタスクがどの小型モデルに割り当てられるかに左右され、珍しいタスクでの柔軟性が限られる。
- 独自ヘッダーでの認証は標準のベアラ方式と異なるため、一部のSDK連携には調整が要る。
よくある質問
ZeroGPUは、大量で反復的なAIタスクをエッジネットワーク上の小型・nanoモデルで実行する。典型的な作業は分類、コンテンツモデレーション、データ抽出、翻訳、サポートチケットの振り分けだ。パイプラインの実行レイヤー向けに作られており、複雑な推論向けではない。
関連コンテンツ
ZeroGPUに関連するツール、スキル、記事を探す。
ZeroGPUの代替ツール

Base Code
Base44 (Wix) · コーディング · 生産性向上Base CodeはBase44の共有クラウド開発環境だ。既存のGitHubリポジトリに対する変更をチャットで伝え、プレビューで確認し、プルリクエストとして返せる。

Knocket
Knocket (Tencent RTC team) · 生産性向上 · ビジネス · チャットボットKnocketは無料のライブチャット兼コンタクトページだ。訪問者はウェブサイト、アプリ、共有リンクから書き込み、こちらはTelegramか一つの受信トレイから返信する。

FloorGen
Vinit Kumar (FloorGen) · 生産性向上 · 中国のAIFloorGenはブラウザで動く間取り作成ツールだ。文章かスケッチから編集できる2D間取り図と3Dウォークスルーを作る。PDF、DXF、動画に書き出せ、アカウントなしでも描き始められる。