

HunyuanVideo-Avatar
Tencent Hunyuan · 이미지 · 동영상
HunyuanVideo-Avatar는 이미지 한 장과 음성으로 감정을 조절하는 말하고 노래하는 영상을 만드는 Tencent의 오픈 모델이며, 여러 인물이 한 화면에 나오는 것도 지원한다.
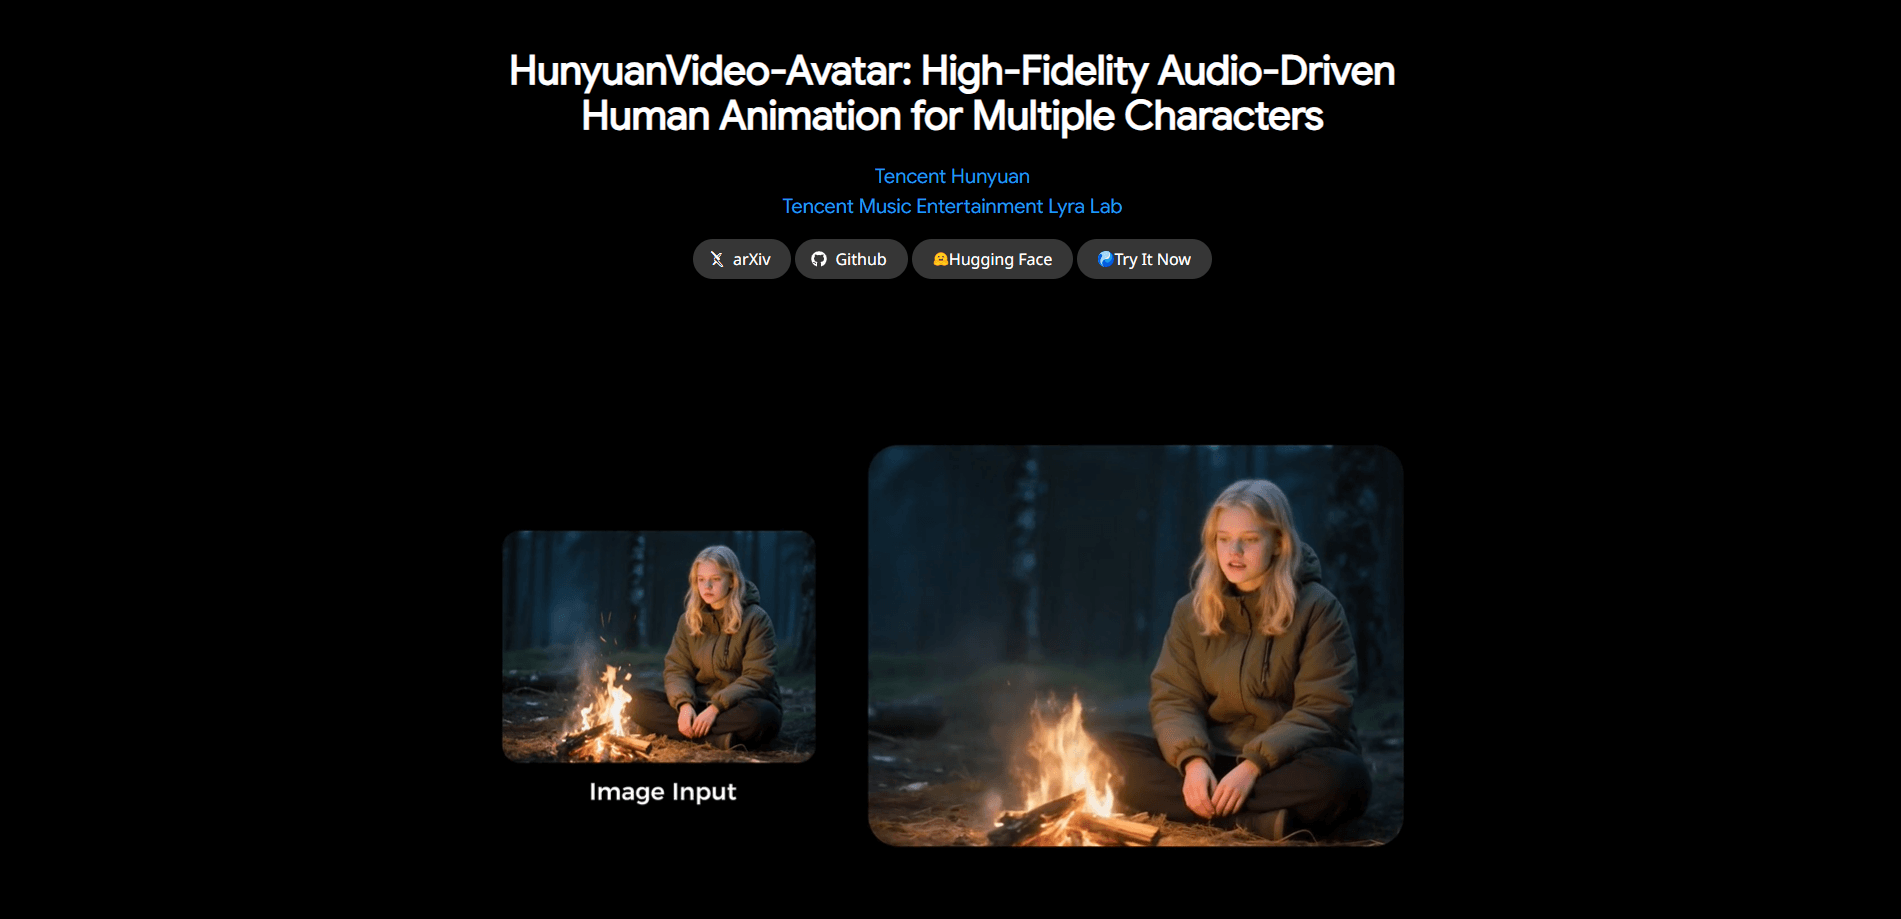
HunyuanVideo-Avatar 소개
What Is HunyuanVideo-Avatar
HunyuanVideo-Avatar는 음성으로 사람을 움직이는 오픈 모델이다. Tencent Hunyuan이 Tencent Music의 Lyra Lab MuseV 팀과 함께 만들었고 2025년 5월에 공개했다. 인물 사진 한 장과 음성 트랙 하나를 넘기면 얼굴이 움직이고 입모양이 발화에 맞으며 인물의 정체성이 첫 프레임부터 마지막까지 유지되는 영상을 돌려준다.
립싱크 도구는 대개 입에서 멈춘다. 이 모델은 머리와 어깨에서 전신까지 화면 전체를 움직인다. 게다가 참조 이미지에서 감정을 읽어내므로 같은 클립이 밝게도 차분하게도 나온다. 한 장면에 여러 사람을 넣고 각자를 자기 음성 트랙에 묶는 처리도 해낸다. 예전 모델이 얼굴을 뒤섞기 쉬웠던 바로 그 지점이다. 출력은 최대 720p이며, 공식 체험 페이지는 음성 업로드를 약 14초로 제한한다.
누구나 클릭 한 번에 쓰는 웹앱은 아니다. 모델은 코드와 가중치로 배포되어 직접 내려받아 돌려야 하므로, 그대로 쓰려면 NVIDIA GPU와 제대로 갖춘 파이썬 환경이 필요하다. Tencent의 Hunyuan 사이트에 호스팅 체험판이 있지만, 깊이 들어간 다인 기능은 오픈 버전에 들어 있다. 움직이는 얼굴과 목소리에 대한 권리와 동의는 모델이 아니라 사용자 몫이다.
Getting Started
- 공식 GitHub 저장소를 열어 복제하고, CUDA를 지원하는 NVIDIA GPU가 있는 파이썬 3.10 환경을 구성한다.
- README에 나온 PyTorch와 FlashAttention 의존성을 설치하고 사전 학습된 가중치를 내려받는다.
- 인물 이미지로는 밝고 정면을 향한 사진을 고르고, 발화나 노래가 담긴 깨끗한 음성을 준비한다.
- 추론 스크립트를 실행하고, 장비와 메모리에 맞춰 단일 GPU 또는 다중 GPU 모드를 고른다.
- 렌더링된 영상을 확인하고 필요하면 해상도나 이미지 자르기를 조정한 뒤 결과를 내보낸다.
제품 정보
HunyuanVideo-Avatar의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 숏폼 영상 제작자
- 개발자와 연구자
- 이커머스와 라이브 방송 팀
- 일러스트와 3D 아티스트
작업
- 인물 사진을 말하는 영상으로 만들기
- 노래 클립 제작하기
- 감정 조절하기
- 두 사람 장면 움직이기
- 자체 파이프라인 만들기
활용 상황
- 상품 영상을 빠르게 갱신하기
- 다른 언어 버전 만들기
- 팟캐스트를 영상으로 만들기
- 아바타 콘셉트 시험하기
주요 기능
One Image Plus Audio
핵심 원리는 말하기 쉽고 해내기 어렵다. 인물 사진 한 장과 음성 트랙 하나를 넘기면 입모양이 음성에 맞고 몸동작이 자연스러운 말하거나 노래하는 영상을 돌려준다. 크기와 해상도가 다른 이미지를 받으므로 좁게 자른 사진도 전신 샷도 입력으로 쓸 수 있다. 촬영 하루를 아껴 주는 기능이며, 멈춰 있는 사진이 촬영한 연기를 대신한다.
Emotion-Controllable Expression
음성 감정 모듈이 감정 단서를 읽어 캐릭터 얼굴에 얹는다. 표정은 평평하게 머무르지 않고 음성의 분위기를 따라간다. 참조 이미지가 그 감정을 이끌므로 같은 대사도 무엇을 넣느냐에 따라 밝게도 차분하게도 들린다. 딱딱한 아바타가 대본을 읽는 걸 본 사람이라면, 여기가 결과를 살아 있게 만드는 부분임을 알 것이다.
Multi-Character Dialogue
다인 모드는 여러 사람이 한 장면을 나누게 하고 각자를 자기 음성으로 움직인다. 예전 모델이 갈라 놓기 어려워하던 지점이다. 얼굴을 인식하는 음성 어댑터가 얼굴마다 마스크를 씌워 한 캐릭터의 목소리가 다른 캐릭터의 입으로 새지 않게 한다. 이 덕분에 두 진행자 팟캐스트나 주고받는 인터뷰가 손으로 맞춰야 하는 클립 두 개가 아니라 영상 하나로 나온다. 단순한 얼굴 바꾸기 도구보다 이 모델을 고르는 가장 큰 이유다.
Multi-Style and Multi-Scale Characters
모델은 실사 얼굴, 일러스트, 3D 렌더, 의인화 캐릭터에서 똑같이 작동하므로 양식화한 마스코트도 실사 진행자와 같은 입과 움직임 처리를 받는다. 인물, 상반신, 전신 구도로도 생성해 말하는 머리 하나로 부족할 때 힘이 된다. 입력에서 타협이 줄어드는 만큼 도구에 맞추지 않고 자기 작품의 화풍을 지킬 수 있다.
High-Dynamic Video Output
생성된 클립은 멈춘 그림에 얼굴을 붙인 게 아니라 전경과 배경 모두에 움직임을 담는다. 캐릭터가 움직이고 장면이 흐르며 결과는 최대 720p로 버틴다. 대가는 무게다. 움직임이 많은 생성이야말로 모델을 GPU 메모리에 굶주리게 하는 원인이라, 가장 번잡한 장면일수록 가진 것 중 가장 좋은 카드를 요구한다.
Open Code and Weights
추론 코드와 모델 가중치가 공개되어 Tencent 조건에 따라 개인 및 상업적 사용이 허락된다. 자기 하드웨어에서 전부 돌리고 속을 살피며 자기 데이터로 미세 조정할 수 있다. 얼굴과 목소리를 제3자 서비스에 보내고 싶지 않은 팀에 이 개방성이 가장 큰 매력이며, 모델이 연구 커뮤니티에서 빠르게 퍼진 이유이기도 하다.
장단점
장점
- 사진 한 장과 음성만 있으면 되므로 멈춰 있는 이미지가 촬영한 연기를 대신한다.
- 음성 감정 모듈이 고정된 표정이 아니라 소리를 따라가는 분위기를 캐릭터에 준다.
- 다인 지원이 화자마다 자기 음성을 유지해 클립을 손으로 꿰매는 수고를 던다.
- 실사, 일러스트, 3D, 동물 캐릭터로 돌아가므로 자기 화풍이 그대로 남는다.
- 코드와 가중치가 열려 있어 팀이 닫힌 서비스를 빌리는 대신 로컬에서 돌리고 미세 조정한다.
단점
- 직접 돌리려면 NVIDIA GPU가 필요하고, 최고 품질은 96GB 카드를 권장해 대부분의 소비자용 기기를 배제한다.
- 호스팅 체험판은 음성을 약 14초로 제한하고 실시간 작업에는 느려서, 긴 클립은 로컬 환경이 필요하다.
- 보급형 하드웨어에서는 렌더가 느려 강한 카드 없이는 큰 작업의 빠른 마감이 현실적이지 않다.
- 오픈 버전에는 공개 API 안내가 없어 개발자가 서빙 계층을 직접 만들어야 한다.
자주 묻는 질문
HunyuanVideo-Avatar는 음성으로 사람을 움직이는 Tencent의 오픈 모델이다. 인물 이미지와 음성을 받아 캐릭터가 입모양과 표정을 맞춰 말하거나 노래하는 영상을 만든다. 한 장면에 캐릭터가 둘 이상인 경우도 다룬다. Tencent Hunyuan과 Tencent Music Lyra Lab MuseV 팀이 만들었고 2025년 5월에 나왔다.
관련 콘텐츠
HunyuanVideo-Avatar와 관련된 도구, 스킬, 아티클을 살펴보세요.
HunyuanVideo-Avatar 대안

Tractionwave
TractionWave · 이미지 · 마케팅TractionWave는 정적 광고용 AI 어텐션 히트맵 도구다. PNG나 JPG를 올리면 예측된 시선 위치, 순위가 매겨진 핫스팟, 수정안이 나온다. 예산을 집행하기 전에 판단하는 데 쓴다.

Imejis.io
Imejis.io · 이미지 · 마케팅Imejis.io는 에이전트와 마케팅 팀을 위한 AI 디자인 스튜디오다. 평소 쓰는 말로 이미지를 설명하면 문구를 쓰고 레이아웃을 잡은 뒤 모든 크기로 다시 배치하고 완성 파일을 내보낸다.

Layoutr
Van Dijk Ontwikkeling · 이미지 · 중국 AILayoutr는 브라우저에서 도는 평면도 툴이다. 가진 평면도를 실제 축척에 맞추고, 실물 크기 가구를 놓고, 방을 3D로 확인한 뒤 AI로 렌더링한다.