
Kyutai TTS
Kyutai · 음성 및 언어
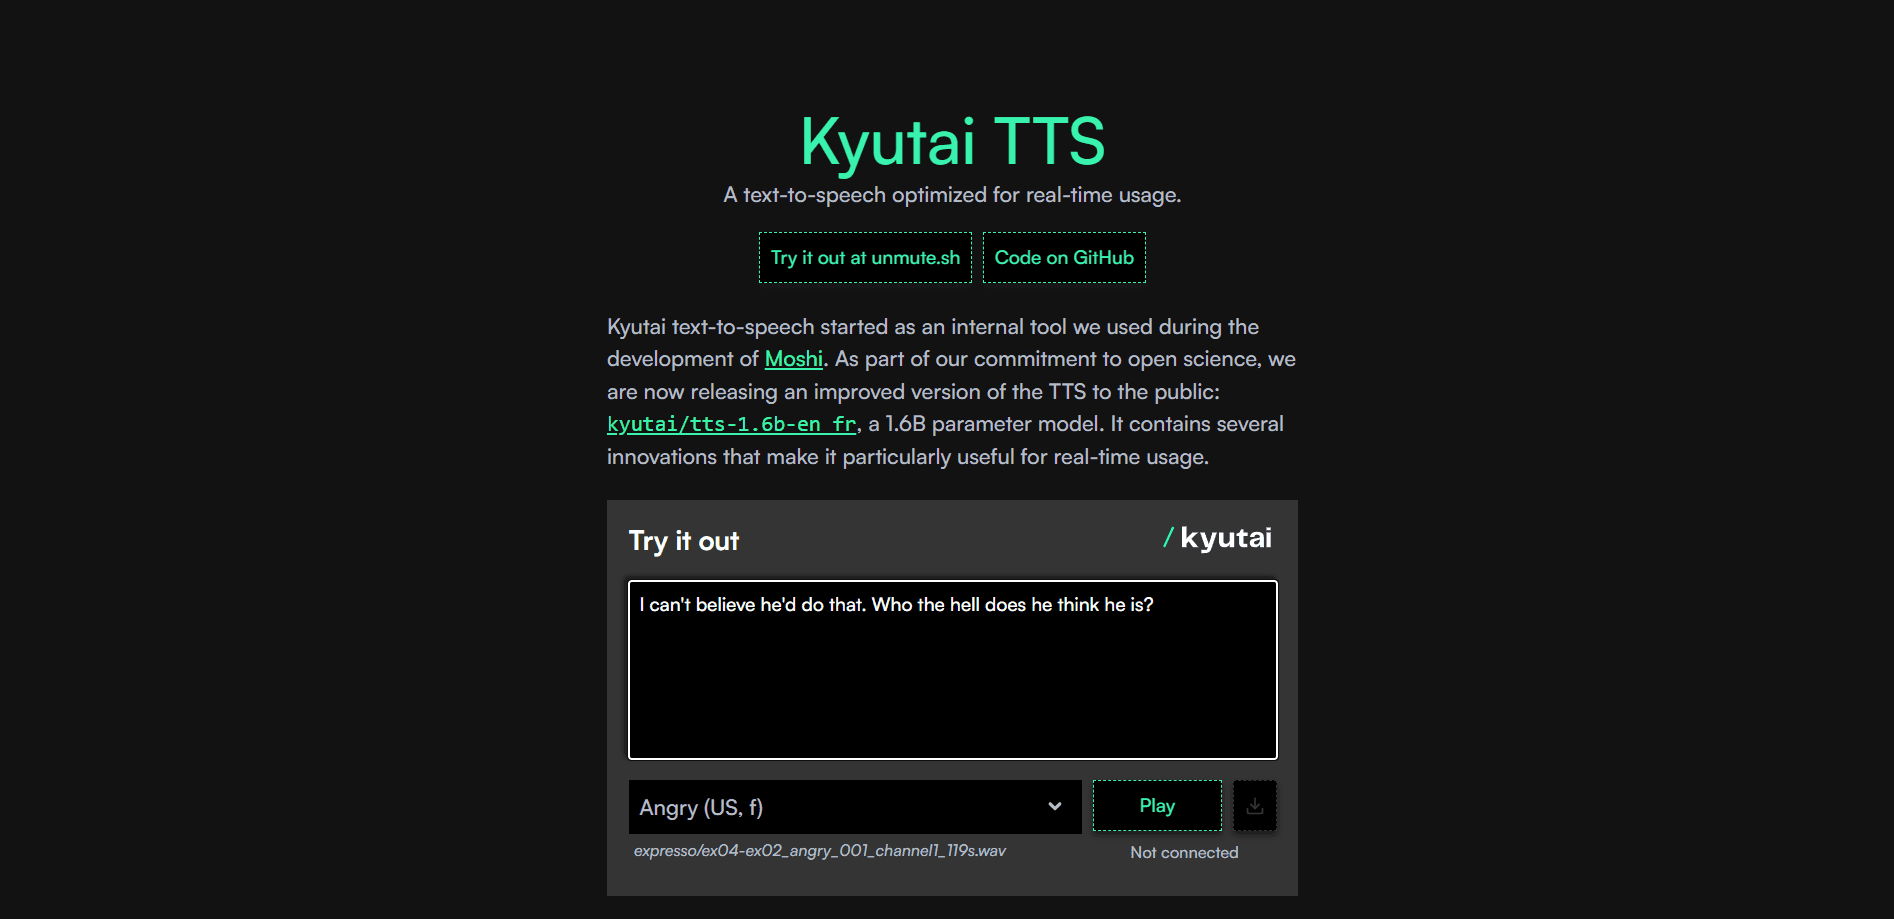
Kyutai TTS는 전체 텍스트가 준비되기 전에 오디오를 만들기 시작하는 오픈소스 TTS 모델이다. 스트리밍 음성 합성 모델로, 음성 비서와 실시간 앱의 지연을 낮게 유지한다.
Kyutai TTS 소개
About
Kyutai TTS란
Kyutai TTS는 스트리밍을 위해 만든 음성 합성 모델이다. 텍스트를 소리 내어 읽지만, 입력이 끝나기를 기다리지 않는다. 처음 몇 단어를 받는 순간 말하기 시작한다. 이 점이 문장 전체를 요구하는 오프라인 엔진과 갈린다.
Kyutai는 프랑스의 오픈 사이언스 연구소로, Iliad 그룹과 CMA CM 그룹, Schmidt Sciences가 자금을 댄다. 연구소는 음성 대화 시스템 Moshi를 만들면서 Kyutai TTS 1.6B를 개발했고, 이후 가중치를 공개했다. Kyutai 음성 모델 가운데 하나다. 이 버전은 저지연 음성 합성을 겨냥한다. 대부분 엔진은 전체 텍스트를 읽은 뒤에야 소리를 낸다. 말하는 비서를 만들거나, 내레이션을 생성하거나, 글자당 과금 없이 앱에 음성을 붙일 수 있다.
핵심은 이 속도를 어떻게 얻는가다. 250만 시간의 공개 오디오로 학습했고 GPU에서 가장 잘 돈다. 월 요금이 명확한 즉시 사용형 클라우드 서비스가 아니다. 가중치를 내려받아 환경을 갖추고 직접 실행한다. 버전은 두 가지다. 여기서 다루는 1.6B 스트리밍 모델과, 더 새로운 Pocket TTS다. 후자는 CPU 기기를 위한 소형 모델이다.
시작하기
- Hugging Face 무료 계정을 만들고 Kyutai TTS 페이지에서 모델 라이선스에 동의한다.
- pip로 파이썬 패키지 moshi를 설치한다. 운영 환경에서 제공하려면 crate moshi-server를 설치한다.
- 파이썬에서 체크포인트와 Mimi 오디오 코덱을 불러오고, 모델에 텍스트 프롬프트를 넘긴다.
- 스트리밍 재생을 위해 청크 단위로 오디오를 생성한다. 파일에 돌리면 오프라인 출력이 된다.
- tts-voices 저장소에서 완성된 음성을 고르거나, 직접 만든 음성 임베딩을 넣는다.
제품 정보
Kyutai TTS의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 음성 비서를 만드는 개발자
- 연구자와 학생
- 예산이 빠듯한 개인 개발자
작업
- 실시간 음성 응답
- 고정 캐릭터의 음성 복제
- 내레이션 일괄 생성
활용 상황
- 대화형 음성 에이전트 구동
- 앱에 접근성 더하기
- 다국어 제품 시험
주요 기능
오프라인 TTS를 앞서는 스트리밍 출력
Kyutai TTS는 프롬프트의 첫 몇 단어를 받자마자 말하기 시작한다. 오프라인 엔진은 전체 텍스트를 기다려 몇 초의 지연이 쌓인다. 음성 비서에서는 이 차이가 자연스러운 주고받기와 어색한 침묵을 가른다.
delayed streams modeling 기반
이 모델은 텍스트와 음성을 오가는 스트리밍 작업을 위한 Kyutai의 delayed streams modeling 연구에서 나왔다. Moshi와 같은 멀티스트림 구조를 써서 텍스트와 오디오 흐름이 맞물린다. 생성은 안정적이고 빠르다.
임베딩을 통한 음성 복제
tts-voices 저장소의 계산된 임베딩을 넘기면 특정 목소리를 줄 수 있다. Kyutai가 자유 복제 대신 이 길을 택한 데는 이유가 있다. 공개 모델에서는 워터마크를 떼기 쉽다고 봤기 때문이다. 복제를 저장된 임베딩으로 제한하는 편이 더 안전하다고 판단했다.
높은 처리량을 위한 일괄 처리
이 모델은 목소리를 하나씩 다루지 않고 요청을 묶어 처리한다. Kyutai는 연산 자원당 약 75배의 오디오를 생성한다고 밝힌다. CFG 증류로 학습해 유도할 때 배치를 두 배로 늘리지 않아도 된다.
영어와 프랑스어 음성
1.6B 모델은 영어와 프랑스어를 기본으로 지원한다. 상용 엔진에 비하면 범위는 좁다. 하지만 두 언어 제품에는 충분하고, 자체 호스팅이 가능한 크기로 유지된다.
여러 가지 배포 방식
돌리는 방법은 세 가지다. PyTorch 버전은 연구와 실험에 맞고, Rust 서버는 websocket으로 운영 트래픽을 감당하며, 양자화 버전은 일반 기기에서 돈다.
장단점
장점
- 관대한 라이선스로 가중치를 무료 공개해 글자당 과금이 없다.
- 스트리밍 설계 덕에 실시간 대화를 감당할 만큼 지연이 낮다.
- GPU 한 장에서 일괄 처리가 잘 돼 동시에 많은 이용자를 감당하는 비용을 낮춘다.
- 공개 논문과 Colab 노트북, 음성 저장소가 있어 맨바닥에서 시작하지 않아도 된다.
단점
- 호스팅 API가 없어 서버를 직접 세우고 관리해야 한다.
- GPU를 권장하므로 실시간 부하에서 값싼 호스팅은 선택지가 아니다.
- 영어와 프랑스어만 지원해 다른 언어에는 다른 모델이 필요하다.
- 음성 복제가 계산된 임베딩으로 제한돼 자유로운 모방은 막혀 있다.
자주 묻는 질문
무료다. 모델 가중치는 CC-BY 4.0으로 공개돼 내려받아 실행할 수 있다. 비용은 돌리는 장비 값만 나간다.
관련 콘텐츠
Kyutai TTS와 관련된 도구, 스킬, 아티클을 살펴보세요.
Kyutai TTS 대안

Prosp
Prosp · 글쓰기 · 음성 및 언어 · 마케팅Prosp는 에이전시와 영업팀을 위해 만들어진 AI LinkedIn 아웃리치 도구다. 잠재 고객마다 자신의 목소리로 메시지와 음성 메시지를 작성해, 상대가 실제로 답장하도록 만든다. 계정을 연결하고 리드를 찾고, AI가 개인화된 메시지를 대량으로 작성해 보내도록 맡긴다. 전부 하나의 받은편지함에서 처리한다. 대량으로 아웃바운드를 돌리는 사람을 위해 만들어졌다. 그게 이 제품의 전부다. 그래도 모든 접점은 인간처럼 느껴져야 한다.

Wordly AI Translation
Wordly · 음성 및 언어 · 생산성Wordly AI Translation은 회의, 콘퍼런스, 행사를 위해 만들어진 실시간 AI 번역 및 자막 플랫폼이다. 60개 이상 언어로 실시간 번역, 자막, 스크립트, 요약을 제공하며, 참가자는 전용 헤드셋 대신 QR 코드를 스캔하거나 링크를 열어 참여한다. Zoom, Microsoft Teams, Google Meet, Webex와 함께 작동하고, 세션마다 사람 통역사를 고용하지 않고도 다국어 접근을 원하는 조직을 겨냥한다. 그게 전부다.
Musicful
Musicful AI · 음성 및 언어 · 동영상Musicful은 텍스트를 몇 분 만에 음악으로 바꾸는 AI 음악 생성기이자 AI 뮤직비디오 제작 도구다. 텍스트 프롬프트, 가사 한 묶음, 또는 흥얼거린 멜로디를 주면 보컬과 악기가 들어간 완성 트랙을 돌려준다. AI 곡 생성기로도 쓰이고, 직접 만든 곡으로 뮤직비디오를 만들며, AI 커버 도구와 개발자용 API도 제공한다. 웹 브라우저와 Android 앱에서 실행되므로 데스크톱에서 곡을 시작하고 휴대폰에서 이어서 할 수 있다.