
LFM2
Liquid AI · 기타
LFM2는 기기 위에서 돌리는 것을 목표로 Liquid AI가 만든 온디바이스 AI 모델군이다. Liquid AI LFM2로 불리는 이 소형 언어 모델군에 속한 350M, 700M, 1.2B 체크포인트는 일반 CPU에서도 빠르게 돈다.
LFM2 소개
What Is LFM2
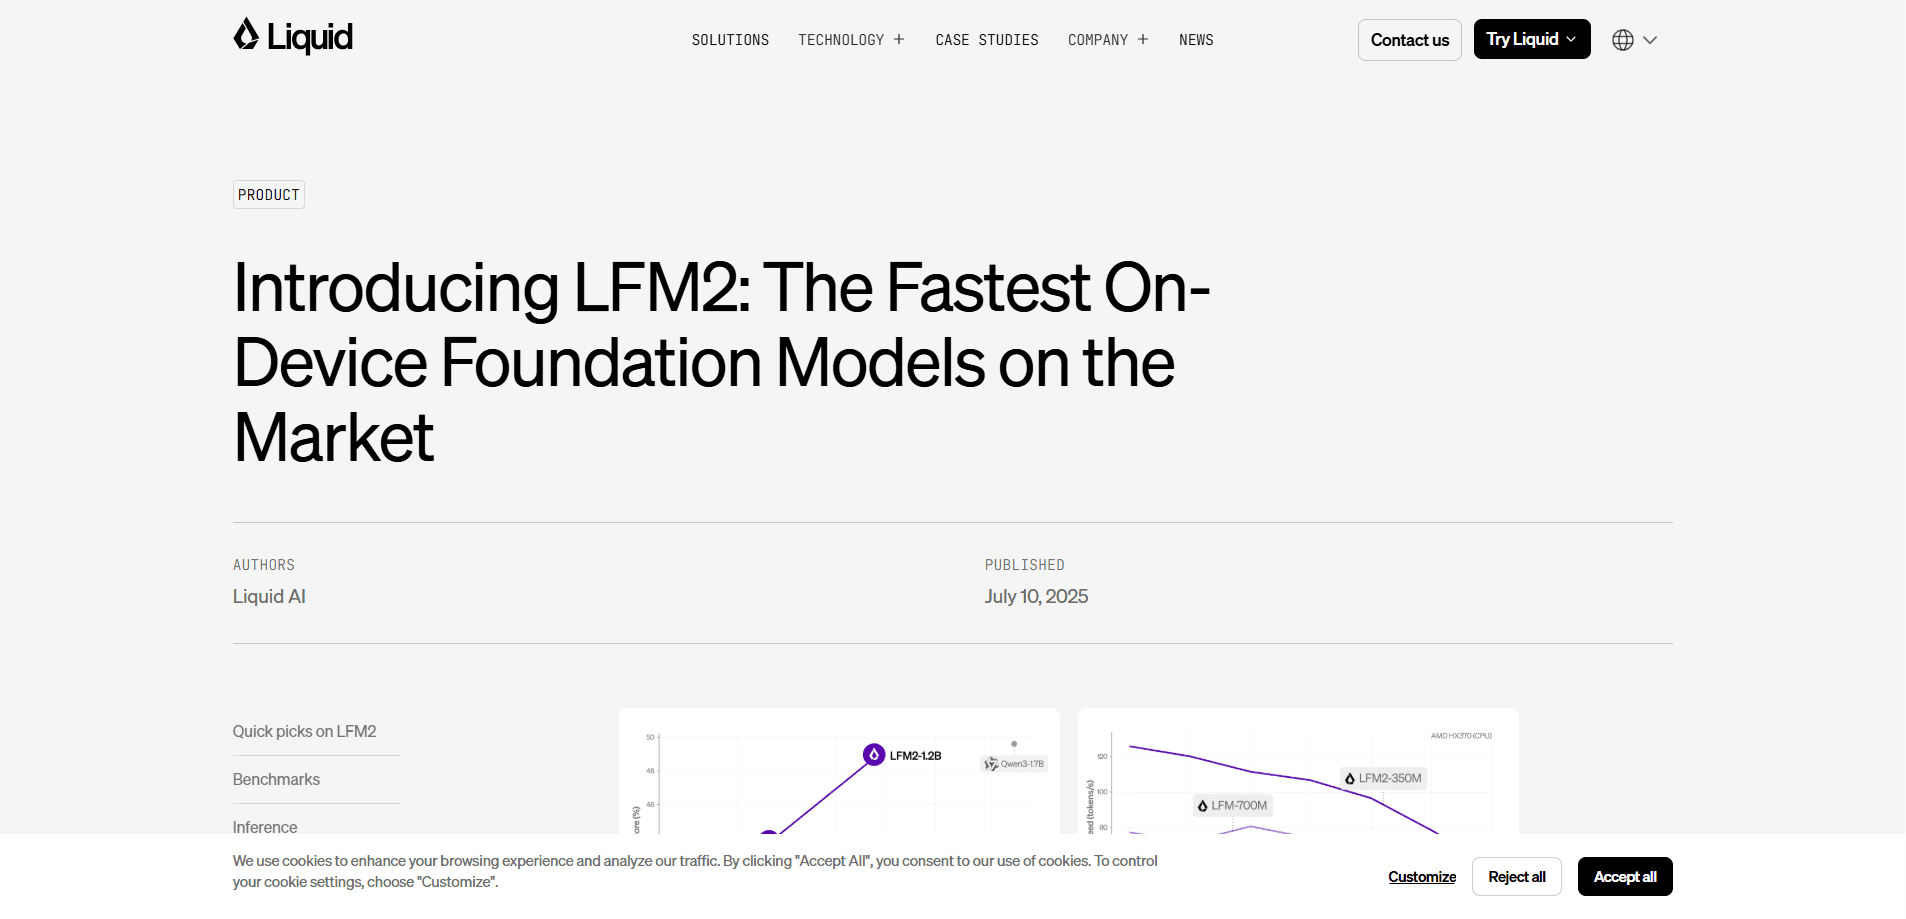
LFM2는 Liquid AI가 2025년 7월에 공개한 2세대 파운데이션 모델이다. 이 회사는 MIT의 CSAIL 연구소에서 나왔고, 크기를 속도와 메모리 효율로 바꾸는 모델을 만든다. LFM2는 350M, 700M, 1.2B 파라미터의 밀집 체크포인트 세 개로 나온다. 각각 데이터센터 없이 스마트폰, 노트북, 차량 시스템에서 돌 만큼 작다.
목표는 단순하다. 클라우드 모델은 강력하지만 대규모로 돌리면 느리고 비싸며, 데이터를 기기 밖으로 내보낸다. LFM2는 쓸 만한 AI를 기기 안에 남기려 한다. 응답은 몇 밀리초 만에 돌아오고, 아무것도 기계를 떠나지 않는다. Liquid AI에 따르면 이 모델들은 CPU에서 디코드와 프리필이 Qwen3보다 두 배 빠르고, 학습 파이프라인은 1세대 LFM보다 세 배 효율적이다.
약점은 작은 모델이 아는 게 적다는 점이다. Liquid AI는 데이터 추출, RAG, 멀티턴 대화 같은 좁은 작업에 LFM2를 미세 조정하라고 권하고, 깊은 추론이나 복잡한 코딩처럼 지식이 많이 필요한 작업에는 맞지 않는다고 경고한다. LFM2는 빠르고 사적인 부품이지, 모든 것을 아는 비서가 아니다.
Getting Started
- Hugging Face에서 하드웨어에 맞는 체크포인트를 고른다. 초소형 기기용 350M부터 노트북이나 단일 GPU용 1.2B까지 있다
- 웨이트를 내려받는다. 더 가볍게 쓰려면 llama.cpp용 GGUF 같은 양자화 포맷을 쓴다
- llama.cpp, ExecuTorch, 표준 Transformers 도구 등 지원하는 프레임워크로 로컬에서 실행한다
- 범용 체크포인트가 작업을 못 맞추면 TRL 같은 프레임워크로 직접 가진 데이터를 써서 미세 조정하고, 조정한 모델을 기기에 배포한다
제품 정보
LFM2의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 온디바이스 기능을 만드는 앱 개발자
- 프라이버시 제약이 있는 팀
- 취미 개발자와 실험가
- 매출 1,000만 달러 미만 스타트업
작업
- 에이전트 워크플로
- 데이터 추출
- 검색 증강 생성
- 멀티턴 대화
- 창작 보조
활용 상황
- 스마트폰 앱이 오프라인으로 답해야 한다
- 노트북 사용자가 로컬에서 초안을 쓰려 한다
- 기기 제조사가 저렴하게 AI를 얹으려 한다
- 규제를 받는 팀이 데이터를 사내에 둬야 한다
- 개발자가 차량 시스템에서 에이전트를 시험한다
주요 기능
합성곱과 어텐션의 하이브리드 구조
LFM2는 어텐션에만 기대지 않고 짧은 합성곱과 그룹 쿼리 어텐션을 섞는다. 각 모델은 16개 블록을 쌓는다. 이중 게이트 단거리 합성곱 블록이 10개, 그룹 쿼리 어텐션이 6개다. 국소 패턴을 값싸게 잡고 어텐션은 효과가 나는 곳에만 쓴다. 이 설계가 스마트폰과 노트북에 실제로 들어가는 하드웨어에서 지연과 메모리를 낮게 유지한다.
일반 CPU에서의 속도
내세우는 것은 원시 정확도가 아니라 처리량이다. Liquid AI에 따르면 LFM2는 CPU에서 디코드와 프리필이 Qwen3보다 두 배 빠르고, 더 작은 700M은 파라미터를 더 많이 지니고도 llama.cpp와 ExecuTorch 모두에서 Qwen 0.6B보다 빠르다. 이 차이는 믿을 칩이 CPU뿐인 스마트폰이나 얇은 노트북에서 크게 작용한다.
기기별 네 가지 크기
이 제품군은 파라미터 350M, 700M, 1.2B, 2.6B를 아우르므로 기기에 모델을 맞출 수 있다. 350M은 웨어러블과 빡빡한 임베디드 대상에 들어가고, 1.2B는 노트북이나 단일 GPU에서 돌며 훨씬 큰 모델과 겨룬다. 엣지용 언어 모델군인 만큼 하나의 구조로 여러 크기를 감당하니, 기능을 위아래로 옮길 때 다시 쓰지 않아도 된다.
작은 규모에서 경쟁력 있는 LFM2 벤치마크
Liquid AI에 따르면 LFM2-1.2B는 파라미터가 47% 더 많은 Qwen3-1.7B와 대등하게 맞서고, 점수는 몇 배 큰 모델에 근접한다. 700M은 Gemma 3 1B IT를 앞서고, 350M은 Qwen3-0.6B와 Llama 3.2 1B Instruct와 호각을 다툰다. 회사 자체 멀티턴 시험에서 평가자는 Llama 3.2 1B Instruct와 Gemma 3 1B IT보다 1.2B 모델을 더 선호했다.
오픈 웨이트와 유연한 라이선스
Liquid AI는 Apache 2.0을 바탕으로 한 오픈 라이선스로 웨이트를 Hugging Face에 공개한다. 학술 및 연구 용도는 무료이고, 매출 1,000만 달러 미만 기업은 무료로 상업적으로 쓸 수 있다. 그 선을 넘으면 상업 라이선스를 위해 Liquid AI에 연락한다. 작은 팀에는 조건이 간결하게 유지되고, 대기업과의 계약 여지도 남는다.
폭넓은 툴체인 지원
LFM2는 개발자가 이미 쓰는 프레임워크로 내보낸다. 로컬 추론은 llama.cpp, 모바일은 ExecuTorch를 거친 PyTorch, 학습은 표준 Transformers 도구로 돈다. TRL로 하는 미세 조정도 지원되는 경로이고, GGUF 버전을 쓰면 기존 추론 앱에 모델을 쉽게 넣을 수 있다.
32K 컨텍스트와 다국어 학습
모든 체크포인트는 32,768 토큰짜리 컨텍스트 창을 다룬다. 긴 문서와 긴 대화에 충분한 크기다. 학습에는 10조 토큰을 썼고, 대략 영어 75%, 다국어 20%, 코드 5%로 나누었으며 일본어, 아랍어, 한국어, 스페인어, 프랑스어, 독일어에 비중을 더 뒀다. 그래서 LFM2는 여러 언어를 다루는 앱에 무리 없이 어울린다.
장단점
장점
- 스마트폰, 노트북, 차량에 이미 있는 CPU에서 빠르게 돌아 GPU나 클라우드 서비스가 필요 없다
- 작은 체크포인트는 메모리 점유를 낮게 유지해 웨어러블과 빡빡한 임베디드 대상에 맞는다
- Qwen3-1.7B와 Gemma 3 1B IT 같은 큰 모델을 훨씬 작은 크기로 따라잡거나 앞선다
- 웨이트가 개방되어 있고 매출 1,000만 달러 미만이면 상업 라이선스가 무료라 초기 비용이 적다
- llama.cpp, ExecuTorch, TRL 같은 익숙한 도구로 돌아 도입에 재작성이 필요 없다
단점
- 작은 모델은 세계 지식이 적어 깊은 추론이나 복잡한 코딩 같은 지식 위주 작업은 감당 범위 밖이다
- Liquid AI는 좁은 용도에 맞춘 미세 조정을 권해, 최상의 결과를 보기 전에 설정 수고가 든다
- 회사 매출이 1,000만 달러를 넘으면 상업 라이선스에 유료 계약이 필요해 규모를 키우는 데 비용이 든다
- 더 새로운 LFM2.5 체크포인트와 더 큰 LFM2 변형이 이미 있어, 처음의 세 크기는 더 이상 최신 선택지가 아니다
자주 묻는 질문
LFM2는 온디바이스 AI를 위해 만들어졌고, 작은 모델이 클라우드가 아니라 기기 안에서 돈다. 대표 용도는 에이전트 워크플로, 데이터 추출, 검색 증강 생성, 멀티턴 대화, 창작 보조다. Liquid AI는 범용 추론보다 좁고 분명한 작업으로 개발자를 이끈다.
관련 콘텐츠
LFM2와 관련된 도구, 스킬, 아티클을 살펴보세요.
LFM2 대안

Odyssey 3
Odyssey · 기타Odyssey-3는 Odyssey의 기반 월드 모델이다. 물리 현상을 실시간으로 시뮬레이션하고, 프롬프트를 인터랙티브 환경으로 바꾸며, 로봇과 자동차, 게임에 적응한다.

JarvisCore
Prescott Data · 코딩 · 생산성 · 기타JarvisCore는 AI 에이전트가 대등한 피어로 메시를 이루고 공유 원장에서 작업을 가져가며 제로트러스트 브로커를 통해 외부 서비스를 호출하는 오픈소스 Python 런타임이다.
Clef
Cloudflare · 비즈니스 · 기타Clef는 Workers AI에서 도는 Cloudflare의 오픈소스 의사결정 모델이다. 생성된 문장 대신 정해진 질문에 확률을 돌려주므로, 에이전트가 빠르게 분류하고 라우팅하고 행동한다.