
StepFun
StepFun · 기타 · 중국 AI
Step 3.5 Flash는 StepFun의 오픈소스 기반 모델로, 토큰마다 196B 파라미터 가운데 11B만 활성화하는 희소 Mixture of Experts(MoE) 방식으로 만들어졌다. 이 설계는 추론 성능을 강하게 유지하면서 생성 속도를 초당 100~300토큰까지 끌어올린다. 느린 모델을 기다리고 싶은 사람이 있을까. 없다. AI 에이전트 모델로서 코딩 어시스턴트와 긴 컨텍스트 작업에 맞는다. 그런 작업에서는 속도가 그 도구를 실제로 쓸지를 결정하기 때문이다.
StepFun 소개
StepFun Step 3.5 Flash란 무엇인가
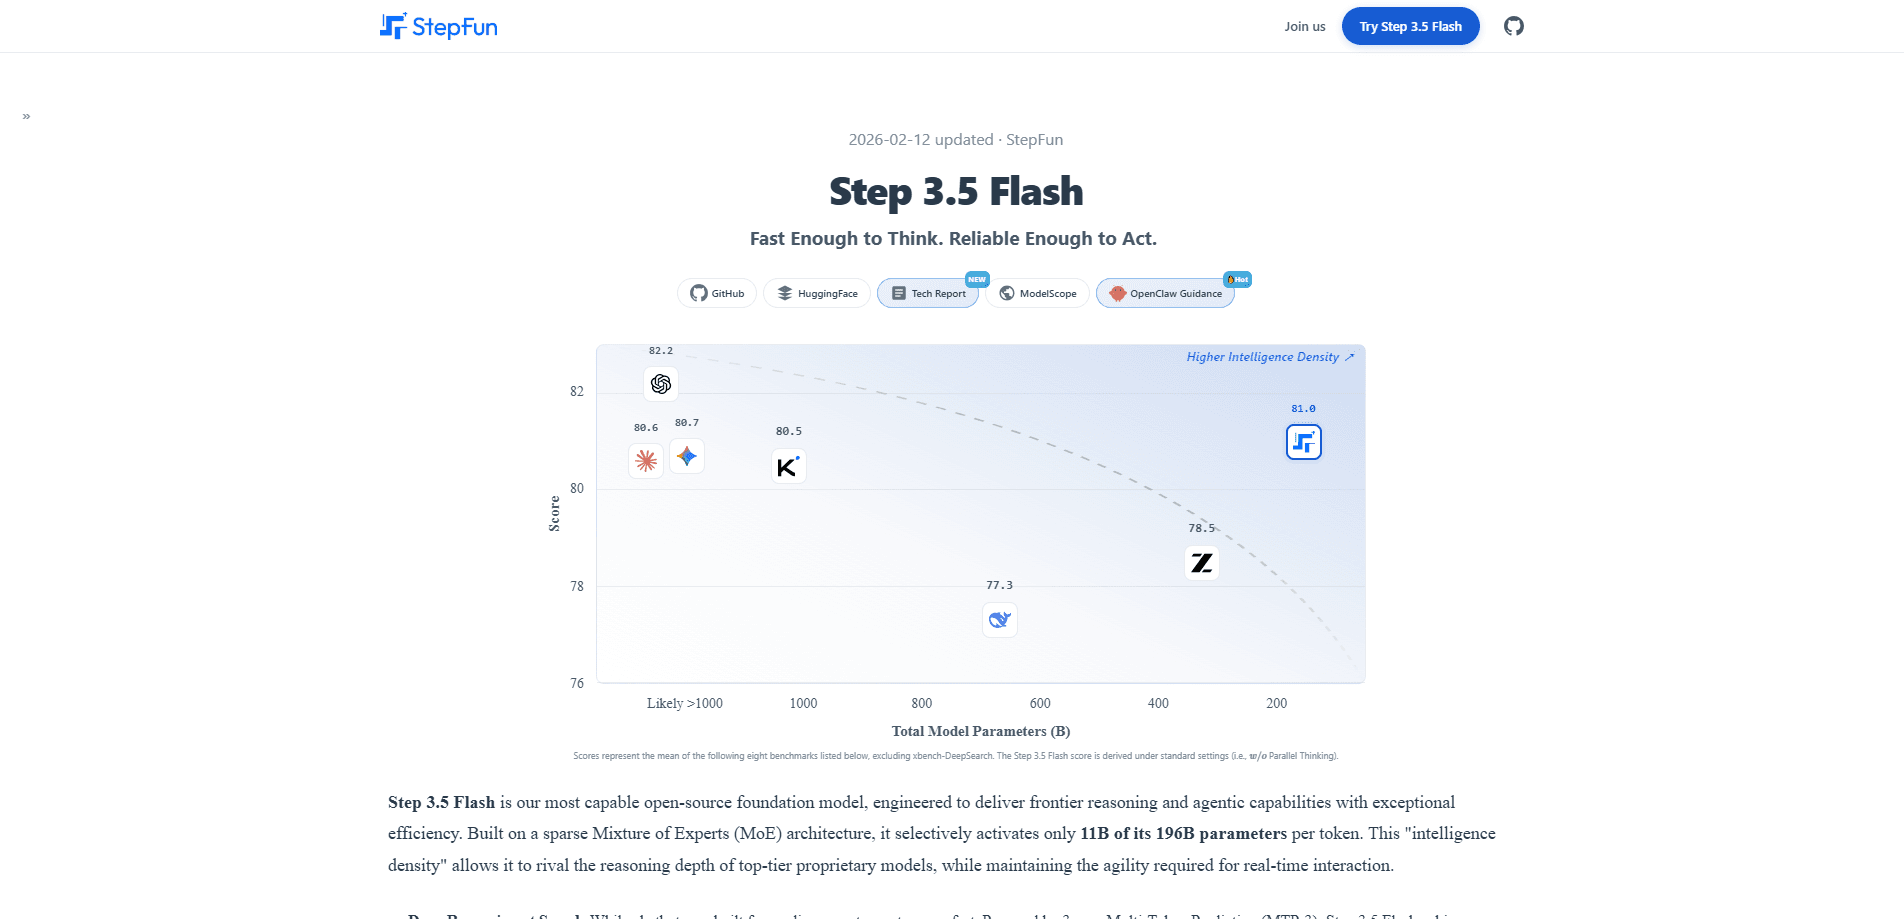
Step 3.5 Flash는 StepFun이 오픈웨이트로 공개한 텍스트 기반 AI 모델이다. 누구나 모델 파일을 내려받아 로컬에서 또는 클라우드 API를 통해 실행할 수 있다. 오픈소스 AI 모델로서 매력은 품질을 크게 떨어뜨리지 않으면서 효율을 얻는 데 있다. 모든 토큰마다 196B 파라미터를 전부 가동하는 대신, 라우팅 계층이 각 토큰에 실제로 필요한 전문가의 작은 일부를 골라낸다. StepFun은 이를 "지능 밀도"라고 부르며, 수치도 그 주장을 뒷받침한다. 8개 벤치마크에서 평균 81.0점을 기록해 같은 비교에서 몇 배 더 큰 모델들을 앞섰다.
에이전트를 만드는 사람에게는 아키텍처 슬라이드보다 실용적인 부분이 더 중요하다. 256K 컨텍스트 윈도우를 다루므로 긴 코드베이스나 문서 묶음을 한 번에 담을 수 있다. StepFun에 따르면 SWE-bench Verified에서 74.4%, Terminal-Bench 2.0에서 51.0%를 기록한다. 모델이 여러 단계에 걸쳐 계획을 세우고 흐트러지지 않고 도구를 호출해야 할 때 원하는 결과다.
한계도 분명히 밝힐 가치가 있다. 공개된 벤치마크 수치는 StepFun 자체에서 나온 것이다. 독립적인 테스트가 확인하기 전까지는 벤더의 주장으로 다뤄야 한다. 또한 이 버전에는 이미지 이해가 내장돼 있지 않아 시각과 관련된 작업은 별도 모델이 맡아야 한다. 그리고 고성능 소비자용 하드웨어에서 돌아간다고 해도 그 "고성능"은 진짜다. Mac Studio M4 Max나 NVIDIA DGX Spark여야 하며, 일반 노트북은 아니다.
시작하기
- 접근 경로를 고른다. 가장 빠르게 시작하려면 StepFun의 호스팅 API를 쓰고, 자기 기기에서 돌리려면 GitHub나 ModelScope에서 오픈웨이트를 받는다.
- StepFun 플랫폼 콘솔에서 API 키를 받아 클라이언트를 OpenAI 호환 엔드포인트(기본 URL https://api.stepfun.com/v1)로 향하게 하고 모델을 step-3.5-flash로 지정한다.
- 아무 OpenAI 방식 SDK로 첫 요청을 보낸다. 먼저 짧은 프롬프트로 연결이 되는지 확인한다.
- 에이전트나 코딩 작업이라면 모델을 도구 루프에 연결하고 여러 턴에 걸쳐 함수를 호출하거나 코드를 실행하게 한다.
- 규모를 키운다. 긴 입력에는 컨텍스트 윈도우를 넓히고, 데이터 프라이버시가 우선이면 로컬 배포로 옮긴다.
제품 정보
StepFun의 요금, 지원 플랫폼, 성능을 한눈에 확인해 보세요.
추천 대상
이 도구가 가장 잘 맞는 사용자, 작업, 상황입니다.
사용자
- 에이전트를 만드는 개발자
- 프라이버시가 중요한 엔지니어
- 연구자와 실험을 즐기는 사람
작업
- 에이전트형 코딩
- 긴 컨텍스트 분석
- 높은 처리량의 자동화
활용 상황
- 코딩 에이전트를 밤새 돌리기
- 대량 문서 묶음 분석
- 개인용 어시스턴트 만들기
주요 기능
11B 활성 파라미터를 갖춘 희소 MoE 아키텍처
Step 3.5 Flash는 196B 파라미터 풀을 유지하지만 토큰마다 약 11B만 활성화한다. 작은 조각, 큰 모델. 그 결과 작은 모델의 속도에 가까워지면서 큰 모델의 추론 깊이를 상당 부분 유지한다. 에이전트 작업 부하가 필요로 하는 바로 그 절충이다.
MTP-3를 통한 고속 생성
3방향 다중 토큰 예측을 사용해 일반 사용에서 초당 100~300토큰을 생성하고, 단일 스트림 코딩 작업에서는 초당 350토큰 부근까지 치솟는다. 긴 추론 사슬을 기다리는 사람에게 그 속도는 "쓰는 도구"와 "피하는 도구"를 가르는 차이다.
하이브리드 어텐션을 갖춘 256K 컨텍스트
모델은 슬라이딩 윈도우 어텐션과 전체 어텐션을 3:1 비율로 결합한다. 대부분의 층은 국소 윈도우를 보고, 몇 개의 층이 전체 시퀀스를 덮는다. 이 방식은 긴 입력에서 성능을 안정적으로 유지하면서 큰 컨텍스트 윈도우에 보통 따르는 연산량을 줄인다.
뛰어난 코딩 및 에이전트 벤치마크
StepFun에 따르면 모델은 SWE-bench Verified에서 74.4%, Terminal-Bench 2.0에서 51.0%를 기록한다. 이는 모델이 단순한 상식 문제에 답하는지를 넘어 실제 엔지니어링 작업을 정말 끝내는지를 추적하는 테스트다.
오픈웨이트와 로컬 배포
모델 파일은 GitHub와 ModelScope에 공개돼 있고, Mac Studio M4 Max, NVIDIA DGX Spark, AMD AI Max+ 395 같은 하드웨어에서 돌아간다. 직접 실행하면 데이터가 로컬에 남고 토큰당 요금을 완전히 피할 수 있다.
OpenAI 호환 API
StepFun의 호스팅 엔드포인트는 OpenAI API 형식을 사용하므로 기존 SDK와 클라이언트가 기본 URL만 바꾸면 작동한다. OpenRouter에는 무료 등급도 있어 유료 사용을 결정하기 전에 에이전트 구성을 시험할 수 있다.
장단점
장점
- 빠른 생성(초당 100~300토큰, 코딩에서는 최대 350)이 에이전트와 대화형 도구에 맞는다.
- 256K 컨텍스트 윈도우가 큰 코드베이스와 문서 묶음을 한 번의 요청으로 처리한다.
- 오픈웨이트 덕분에 로컬에서 돌리고 데이터를 비공개로 유지할 수 있다.
- 코딩과 터미널 벤치마크에서 공개된 성적이 뛰어나다.
- OpenAI 호환 API 덕분에 다른 제공자에서의 이전이 간단하다.
단점
- 벤치마크 수치는 StepFun에서 나온 것이라 독립적 검증은 아직 부족하다.
- 로컬 배포에는 고성능 하드웨어가 필요하고, 일반 노트북으로는 안 된다.
- 이 버전에는 이미지나 멀티모달 이해가 내장돼 있지 않다.
자주 묻는 질문
빠른 추론과 도구 사용이 필요한 작업을 위해 만들어졌다. 코딩 에이전트, 자동화 워크플로, 긴 컨텍스트 분석 등이다. 속도와 컨텍스트 윈도우 덕분에 많은 요청이 연속으로 실행되는 파이프라인에 맞는다.
관련 콘텐츠
StepFun와 관련된 도구, 스킬, 아티클을 살펴보세요.
StepFun 대안

Odyssey 3
Odyssey · 기타Odyssey-3는 Odyssey의 기반 월드 모델이다. 물리 현상을 실시간으로 시뮬레이션하고, 프롬프트를 인터랙티브 환경으로 바꾸며, 로봇과 자동차, 게임에 적응한다.

JarvisCore
Prescott Data · 코딩 · 생산성 · 기타JarvisCore는 AI 에이전트가 대등한 피어로 메시를 이루고 공유 원장에서 작업을 가져가며 제로트러스트 브로커를 통해 외부 서비스를 호출하는 오픈소스 Python 런타임이다.
Clef
Cloudflare · 비즈니스 · 기타Clef는 Workers AI에서 도는 Cloudflare의 오픈소스 의사결정 모델이다. 생성된 문장 대신 정해진 질문에 확률을 돌려주므로, 에이전트가 빠르게 분류하고 라우팅하고 행동한다.