O GPT-6 Sol custa US$ 2 por milhão de tokens na entrada; o Luna sai por US$ 0,10. São 20 vezes de diferença no preço, mas o desempenho em programação e automações não segue a mesma proporção. Entenda onde a diferença aparece de verdade.
O que separa os dois na prática
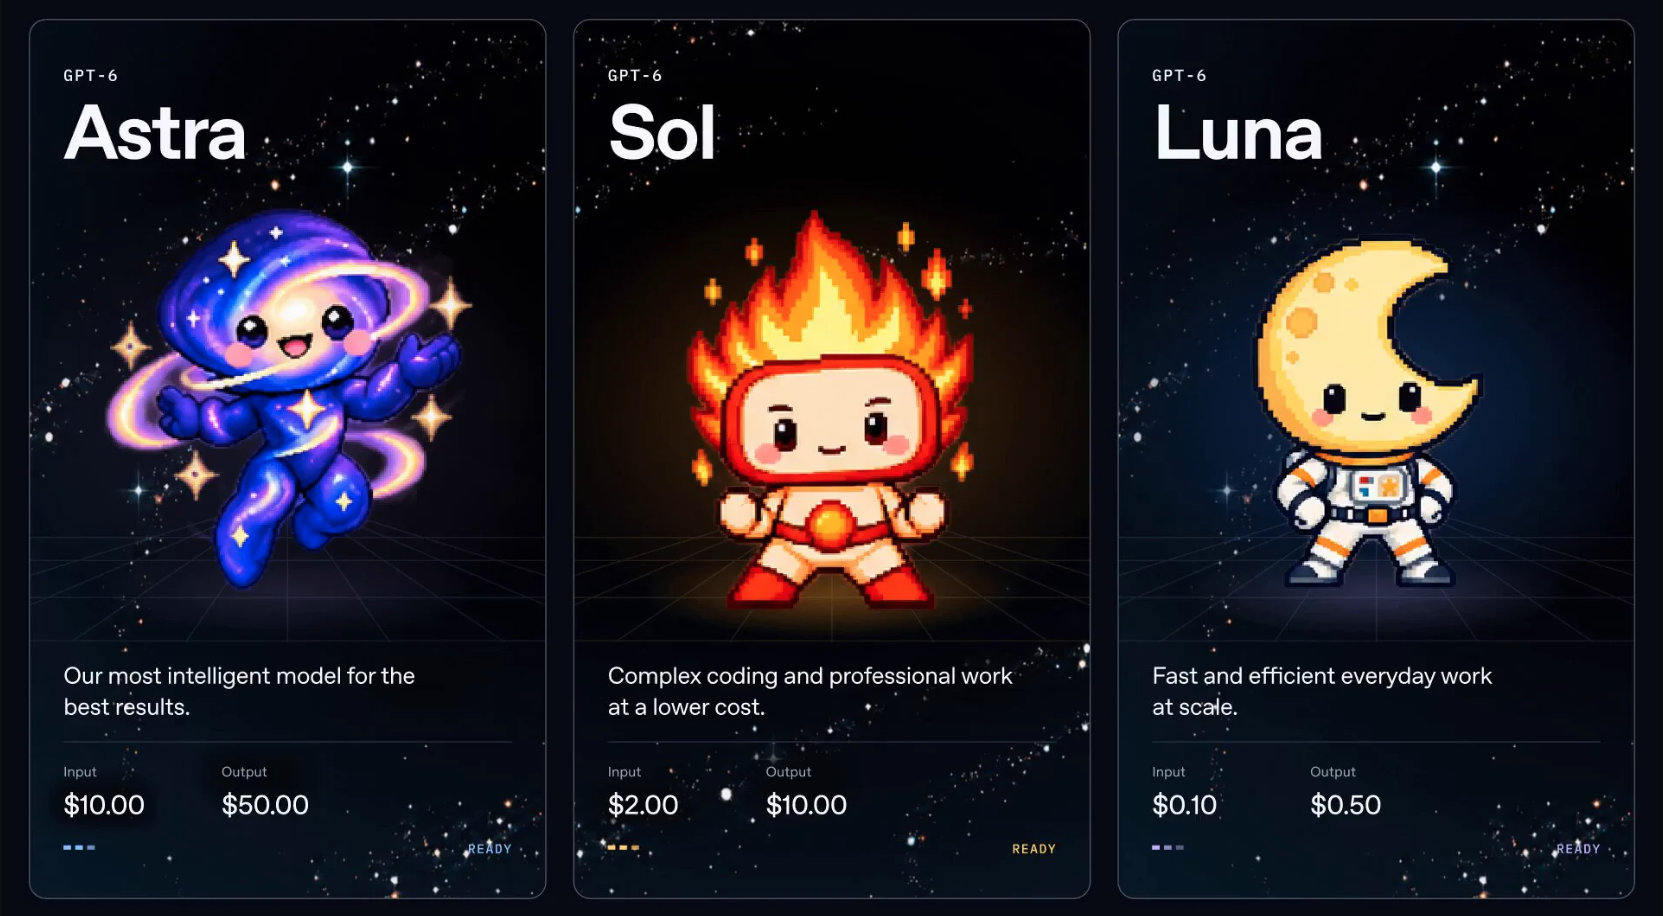
Sol e Luna saíram no mesmo dia e fazem parte da mesma geração, mas não foram feitos para as mesmas pessoas. O Sol é o modelo de trabalho profissional e programação, para quem precisa de agentes que rodem tarefas longas e verificem o próprio código. O Luna é o modelo de entrada, voltado a tarefas menores e a produtos que fazem muitas chamadas de API.
A OpenAI posicionou os dois abaixo do Astra, que continua sendo o topo da linha. A pergunta que importa é outra: se o Luna entrega quase o mesmo resultado em programação por um vigésimo do preço, o que sobra para o Sol justificar a diferença?
A conta do preço
A primeira diferença é direta e não depende de benchmark:
Modelo | Entrada (por milhão de tokens) | Saída (por milhão de tokens) |
|---|---|---|
GPT-6 Sol | US$ 2 (R$ 10,24) | US$ 10 (R$ 51,20) |
GPT-6 Luna | US$ 0,10 (R$ 0,51) | US$ 0,50 (R$ 2,56) |
Na saída, a proporção é a mesma: 20 vezes. Quem roda poucas tarefas por dia dificilmente sente essa diferença no orçamento. Quem roda milhares, sente.
Segundo a OpenAI, o Luna tem algo a mais a seu favor: em níveis de esforço mais altos, ele se iguala ao GPT-5.6 Sol gastando cerca de um centésimo do valor. É um dado da própria empresa, sem verificação independente até agora.
Onde o Sol abre vantagem
O Sol aparece na frente quando a tarefa envolve vários aplicativos e etapas de decisão. No AutomationBench, que testa agentes em fluxos de vendas, marketing, operações, suporte, finanças e recursos humanos, o Sol com esforço máximo marcou 33,2% por US$ 0,27 por tarefa, de acordo com a OpenAI. No mesmo teste, o Luna com esforço alto subiu 5,4 pontos percentuais em relação ao antecessor, com 58% menos custo por tarefa.
No DeepSWE v1.1, que mede engenharia de software em bases de código reais, a distância entre os dois é pequena. O Sol chegou a 68,8% com esforço máximo e o Luna a 66,6%, também com esforço máximo. Dois pontos percentuais de diferença para um preço 20 vezes maior é um número que vale pensar duas vezes.
Vale lembrar que todos esses resultados vêm da OpenAI. Testes independentes ainda não compararam os dois lado a lado.
Onde o Luna fecha a conta
O argumento do Luna fica mais forte quando se olha o custo por tarefa em vez do preço por token. A OpenAI afirma que, no DeepSWE v1.1, o Luna custa 93% menos por tarefa que o Claude Opus 5 e 96% menos que o Claude Fable 5, com desempenho comparável aos dois em esforço médio.
Isso muda a conversa. Não se trata de um modelo fraco e barato, mas de um modelo que fica perto dos rivais de topo gastando uma fração do valor. Para quem precisa de volume, essa é a diferença que decide o orçamento no fim do mês.
Como escolher sem errar
A escolha entre Sol e Luna depende menos de qual é melhor e mais do formato da sua tarefa. Tarefas curtas, repetitivas e em grande quantidade combinam com o Luna. Fluxos longos, com várias ferramentas encadeadas e exigência de precisão em cada etapa, puxam para o Sol.
Um caminho prático é começar pelo Luna e só subir para o Sol quando o resultado não fechar. Como o Luna custa 20 vezes menos por token, o custo de testar é baixo. O contrário, começar pelo Sol e descer, tende a sair mais caro.
Onde o Sol se destaca
- Fluxos com vários aplicativos encadeados
- 33,2% no AutomationBench com esforço máximo
- Verificação de código em tarefas longas
- Custo por tarefa estimado em US$ 0,27
Onde o Luna compensa
- Tarefas curtas e em grande volume
- 66,6% no DeepSWE v1.1, perto do Sol
- Custo por tarefa até 58% menor que o antecessor
- 93% a 96% mais barato por tarefa que rivais de topo
O que olhar daqui para frente
Os dois modelos já estão no ChatGPT Work, no Codex e no GitHub Copilot, com diferenças de plano entre eles. O que ainda falta é medição independente, porque os números que sustentam a comparação são todos da OpenAI.
Para quem paga a conta, o critério não é a pontuação no benchmark, e sim quanto custa concluir a tarefa que aparece no dia a dia. Meça o seu caso: rode a mesma tarefa nos dois modelos e compare o resultado com o gasto. A diferença de 20 vezes no preço por token só importa depois que você sabe quantos tokens cada um consome para chegar ao fim.