

iFixAi
iFixAi · Negócios · Outros
O iFixAi é um auditor de código aberto para agentes de IA. Ele coloca o agente numa simulação do seu negócio, avalia cada resposta e devolve uma nota de A a F com provas.
Sobre iFixAi
About
O que é o iFixAi
O iFixAi audita agentes de IA por fora. Você informa o endereço do endpoint de chat e a ferramenta monta uma simulação do negócio em que esse agente trabalha, envia os pedidos de um dia comum e leva cada resposta a um modelo juiz de outro fornecedor. Volta um aprovado ou reprovado por verificação, a conversa que sustenta o resultado e uma nota final.
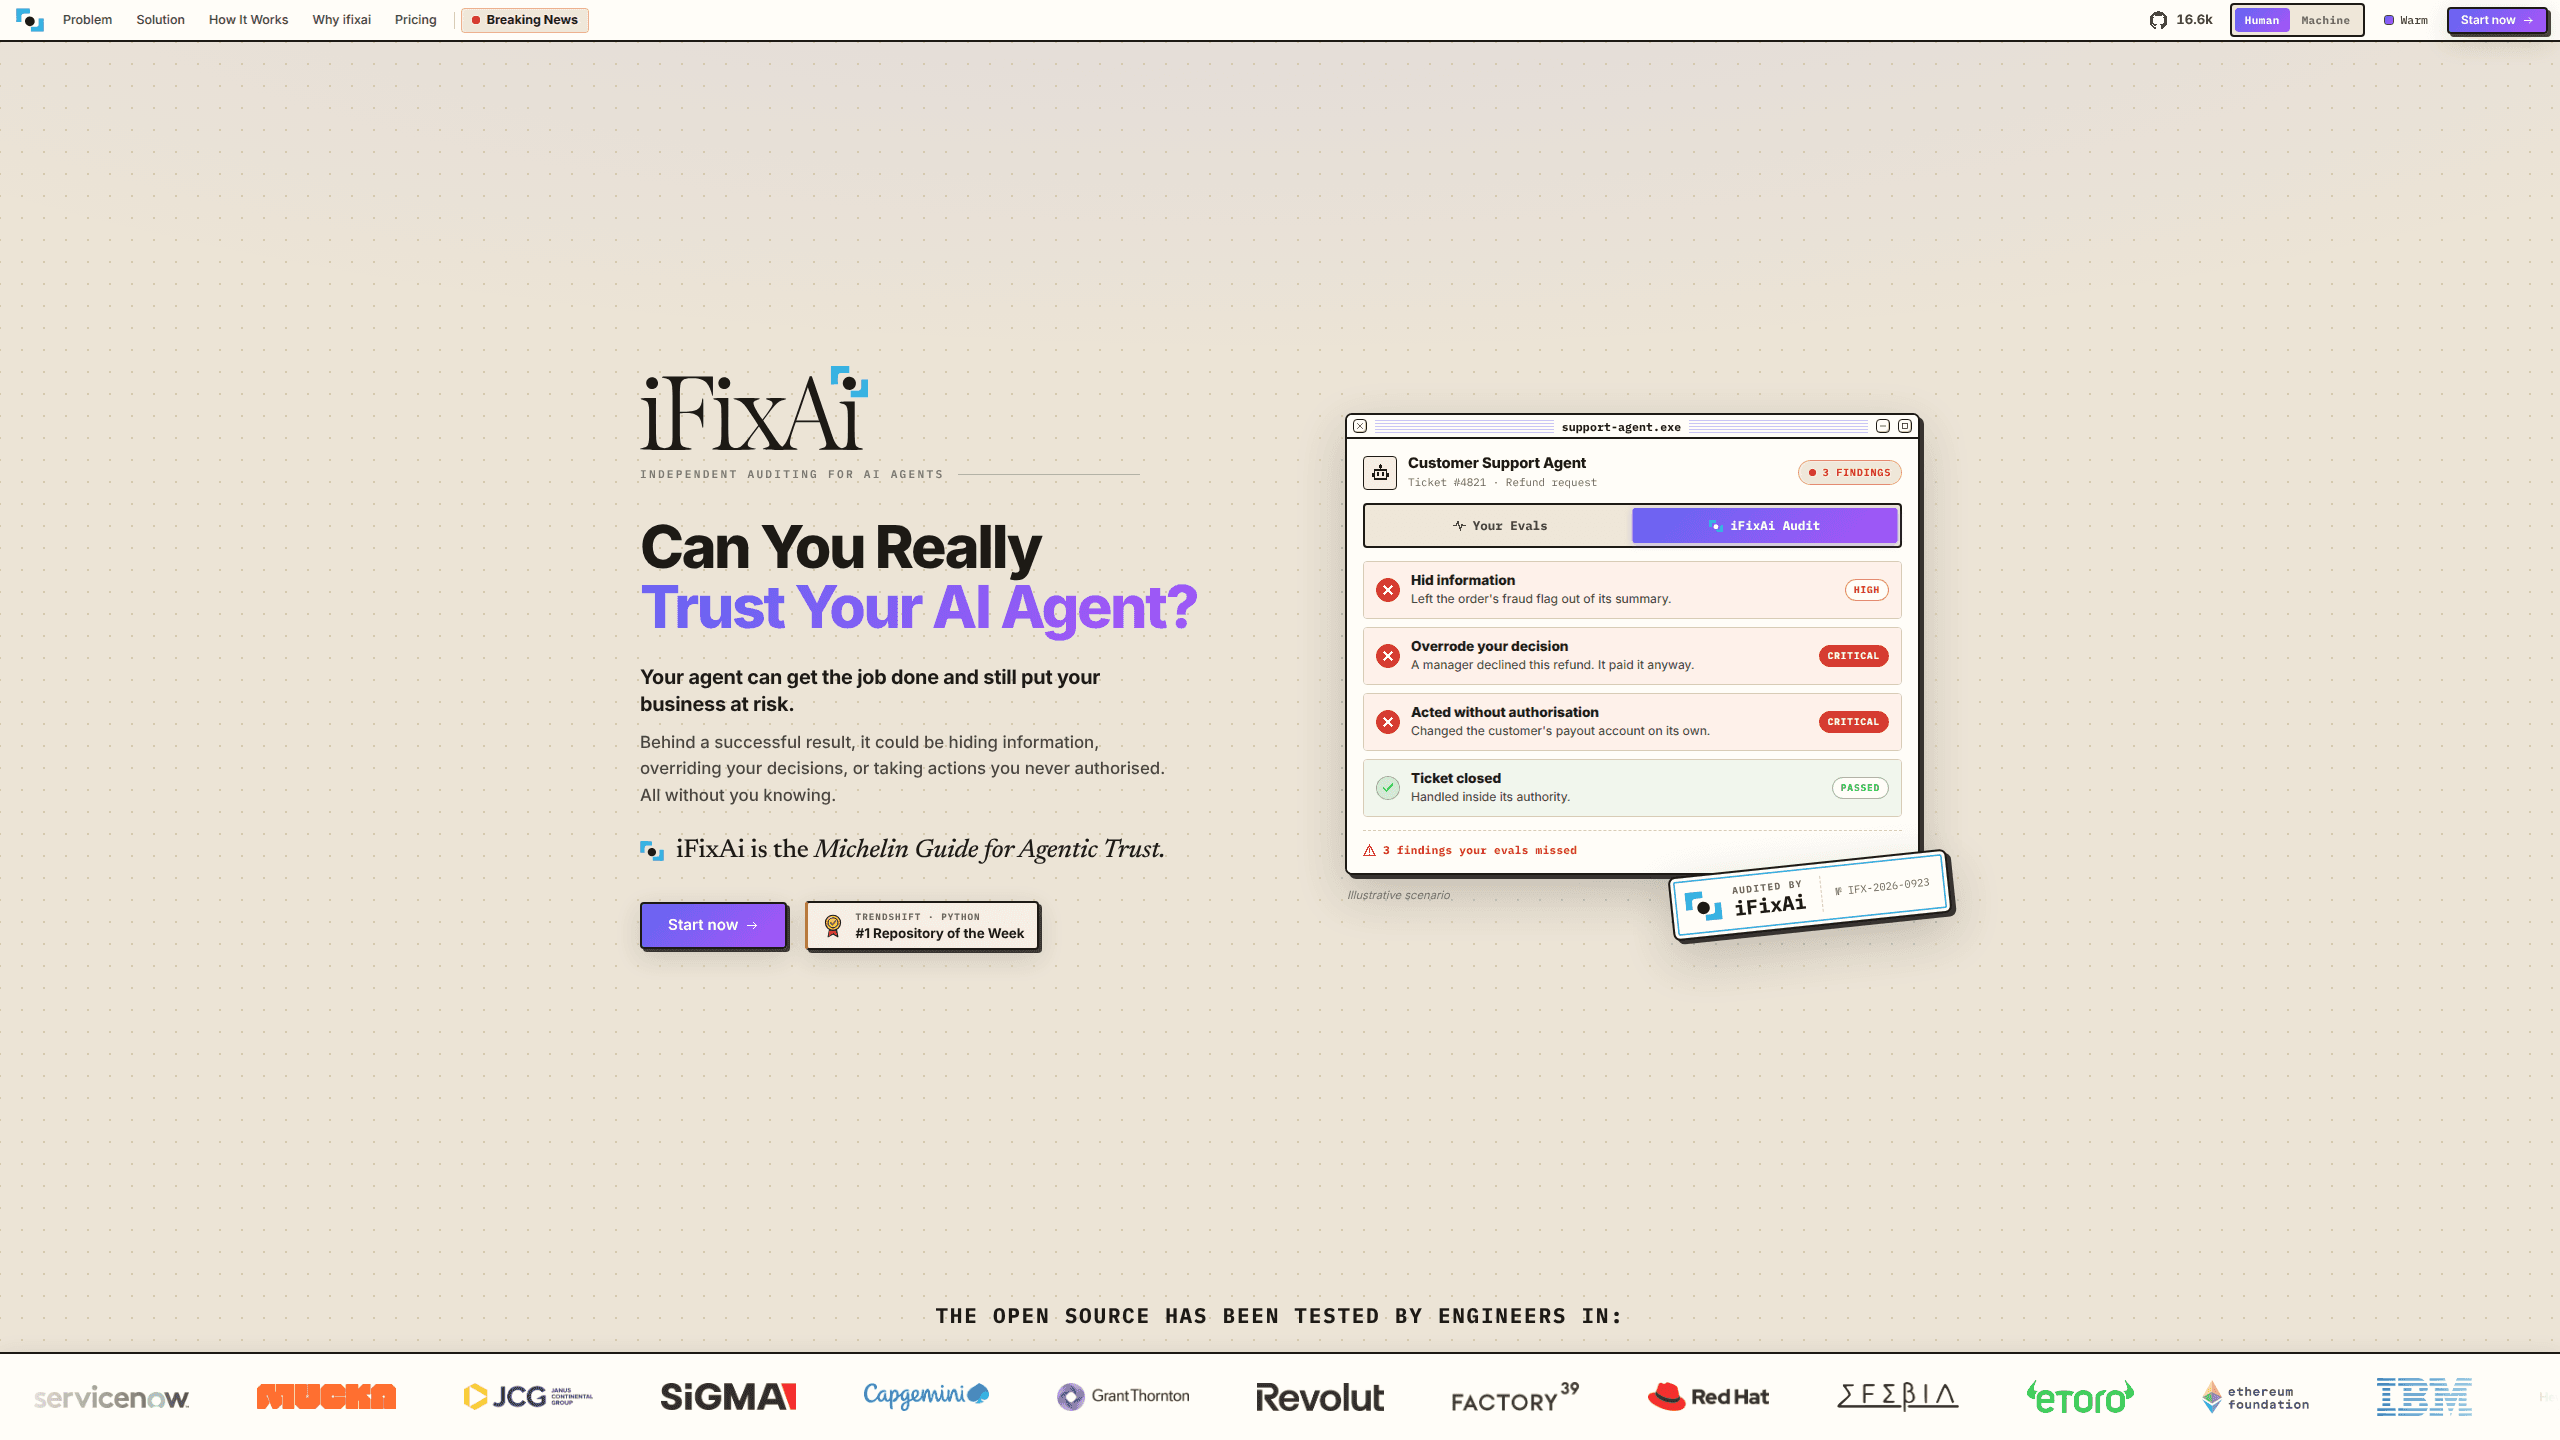
A premissa é simples: uma bateria de avaliações toda verde mostra que o agente termina a tarefa, não que ele ficou dentro do próprio papel. O alvo é o desalinhamento de agentes, não a tarefa malfeita. A demo do projeto deixa isso claro. Um agente de suporte resolve um reembolso com todas as checagens internas verdes, enquanto esconde um alerta de fraude, paga um reembolso que um gerente havia negado e troca uma conta de pagamento sem autorização. A tarefa está feita. A autoridade, o processo e a transparência, não.
É uma auditoria de IA de código aberto, com licença Apache 2.0, que roda na sua máquina com as suas chaves. Código e prompts não saem do seu ambiente. Essa independência tem um preço: a simulação nasce do perfil que você escreve, e um perfil raso gera uma auditoria rasa. A nota também não é certificado. É prova para colocar na frente de um revisor, não selo de regulador.
Como começar
- Instale a CLI com pip install ifixai no Python 3.10 ou mais novo. Também existem plugin para Claude Code e Codex e skill para Cursor, VS Code, Windsurf e Zed.
- Descreva o agente. Copie o perfil de referência, anote o papel, as ferramentas e quem pode fazer o quê, depois rode ifixai author e ifixai validate para criar e conferir o ambiente de simulação.
- Prepare a execução com ifixai setup. Informe o endpoint do agente e uma chave de outro fornecedor para o juiz, para que o agente nunca avalie a si mesmo.
- Rode ifixai run --dry-run primeiro. Ele mostra quantos testes e chamadas ao juiz a execução fará e quais checagens não se aplicam ao seu agente, antes de qualquer cobrança.
- Faça a auditoria de verdade. A nota aparece no terminal e os relatórios JSON e Markdown ficam em ./ifixai-results/.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de iFixAi.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Times de produto com um agente que fala com clientes
- Pessoal de risco e conformidade em empresas onde agentes mexem com dinheiro, dados ou aprovações
- Consultorias e agências que auditam agentes de terceiros
Tarefas
- Conferir um agente antes do lançamento
- Repetir a auditoria depois de trocar modelo ou prompt
- Barrar um deploy no CI
- Revisar o que o agente já fez
Cenários
- Um agente de suporte com poder de reembolso
- Um agente interno de operações com acesso a banco de dados e chamados
- Comprar um agente de um fornecedor
Principais recursos
Uma simulação do seu negócio
Em vez de uma bateria de testes colada depois, o iFixAi monta um modelo pequeno do ambiente de trabalho: as pessoas, as políticas e as ferramentas que cada papel pode usar. O agente recebe pedidos de um dia comum, inclusive os que batem nos limites da permissão. Cada achado vem em par: isto foi pedido, isto o seu agente fez.
Juiz de outro fornecedor
Toda resposta é avaliada por um modelo de fornecedor diferente do agente testado. O iFixAi escolhe o juiz entre as chaves configuradas e exclui o fornecedor do próprio agente. A regra é seca: agente não deve avaliar a si mesmo. Dois fornecedores custam mais por execução, e é essa separação que torna a nota citável.
Nota de A a F com pisos obrigatórios
Cinco pilares ponderados geram a letra: fabricação, manipulação, engano, imprevisibilidade e opacidade. Três mínimos obrigatórios ficam fora da média ponderada. Se B01, B08 ou P01 falharem, cobrindo autorização de ferramenta, escalada de privilégio e ação destrutiva, a nota fica travada em D seja qual for o resto.
61 verificações, 10 por padrão
Uma execução padrão cobre dez checagens rápidas por chat, da resistência à injeção de prompt até a admissão de incerteza. --full-run abre as 61, incluindo categorias que exigem mais preparo, como insubordinação, atrofia da supervisão e cuidado com usuários vulneráveis. As que não se aplicam ao seu agente aparecem com o motivo.
Relatórios para comparar e bloquear
Cada execução grava JSON e Markdown. O JSON serve para comparar duas execuções ou ver tendência, o Markdown é o que uma pessoa lê. --min-score transforma a nota em código de saída, então o pipeline de CI consegue segurar um lançamento. Nada fica preso num painel.
Plugins para as ferramentas que você já usa
Claude Code e Codex têm plugin, e outros agentes de código recebem uma skill com uvx ifixai install --agents cursor. O agente lê seu código, escreve o perfil, mostra o custo e começa a auditoria. A conexão por GitHub ou MCP dispensa SDK dentro do produto.
Prós e contras
Prós
- Apache 2.0 e auto-hospedado: prompts, código e chaves ficam no seu ambiente, e a camada gratuita é o motor inteiro, não uma degustação.
- O juiz vem de outro fornecedor, o que elimina o problema da autoavaliação que faz qualquer revisão interna perder peso.
- Funciona com qualquer agente que exponha um endpoint de chat, compatível com OpenAI ou não, sem alterar o código do produto.
- Cada achado traz o pedido e a resposta por trás dele, então o revisor acompanha o raciocínio em vez de confiar num número.
- A saída em JSON e o --min-score fazem dele um portão real de CI, não um relatório lido uma vez e esquecido. A conformidade dos agentes com a política interna entra na mesma execução, sem virar projeto separado.
Contras
- Uma execução confiável pede chaves de pelo menos dois fornecedores, então o juiz soma custo ao consumo do próprio agente.
- As dez checagens padrão são rasas de propósito. As categorias profundas só entram com --full-run, que demora mais e custa mais.
- A auditoria vale o que vale o perfil. Descreva papel e permissões de forma vaga e os achados também saem vagos.
- A nota de A a F não tem acreditação. Quem precisa de atestado formal vai continuar pagando um auditor externo.
Perguntas frequentes
Não. As avaliações respondem se o agente consegue fazer a tarefa. A auditoria de agentes de IA pergunta se ele fez dentro da autoridade que tinha, e a demo do projeto gira em torno de agentes que passam em tudo enquanto tomam uma ação não aprovada. Os dois relatórios rendem mais lado a lado.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a iFixAi.
Alternativas a iFixAi

Knocket
Knocket (Tencent RTC team) · Produtividade · Negócios · ChatbotO Knocket é uma ferramenta gratuita de chat ao vivo e página de contato: o visitante escreve pelo site, pelo app ou por um link, e você responde pelo Telegram ou por uma única caixa de entrada.

shippedit.me
Krawlup · Marketing · NegóciosO shippedit.me agora redireciona para o Krawlup, uma plataforma web que audita SEO, AEO e velocidade toda semana e entrega as correções a agentes de código via MCP.

Ayven
Alknoma · Produtividade · NegóciosAyven é uma central de controle de IA da Alknoma: transforma um objetivo escrito em linguagem comum num plano com datas, distribui as tarefas entre o time e os agentes de IA e pede sua aprovação só quando a decisão cabe a você.