
Preprocess
Preprocess · Produtividade · Negócios
O Preprocess era uma API de chunking que dividia PDFs, arquivos do Office e HTML em trechos prontos para RAG. O serviço foi descontinuado.
Sobre Preprocess
What Is Preprocess
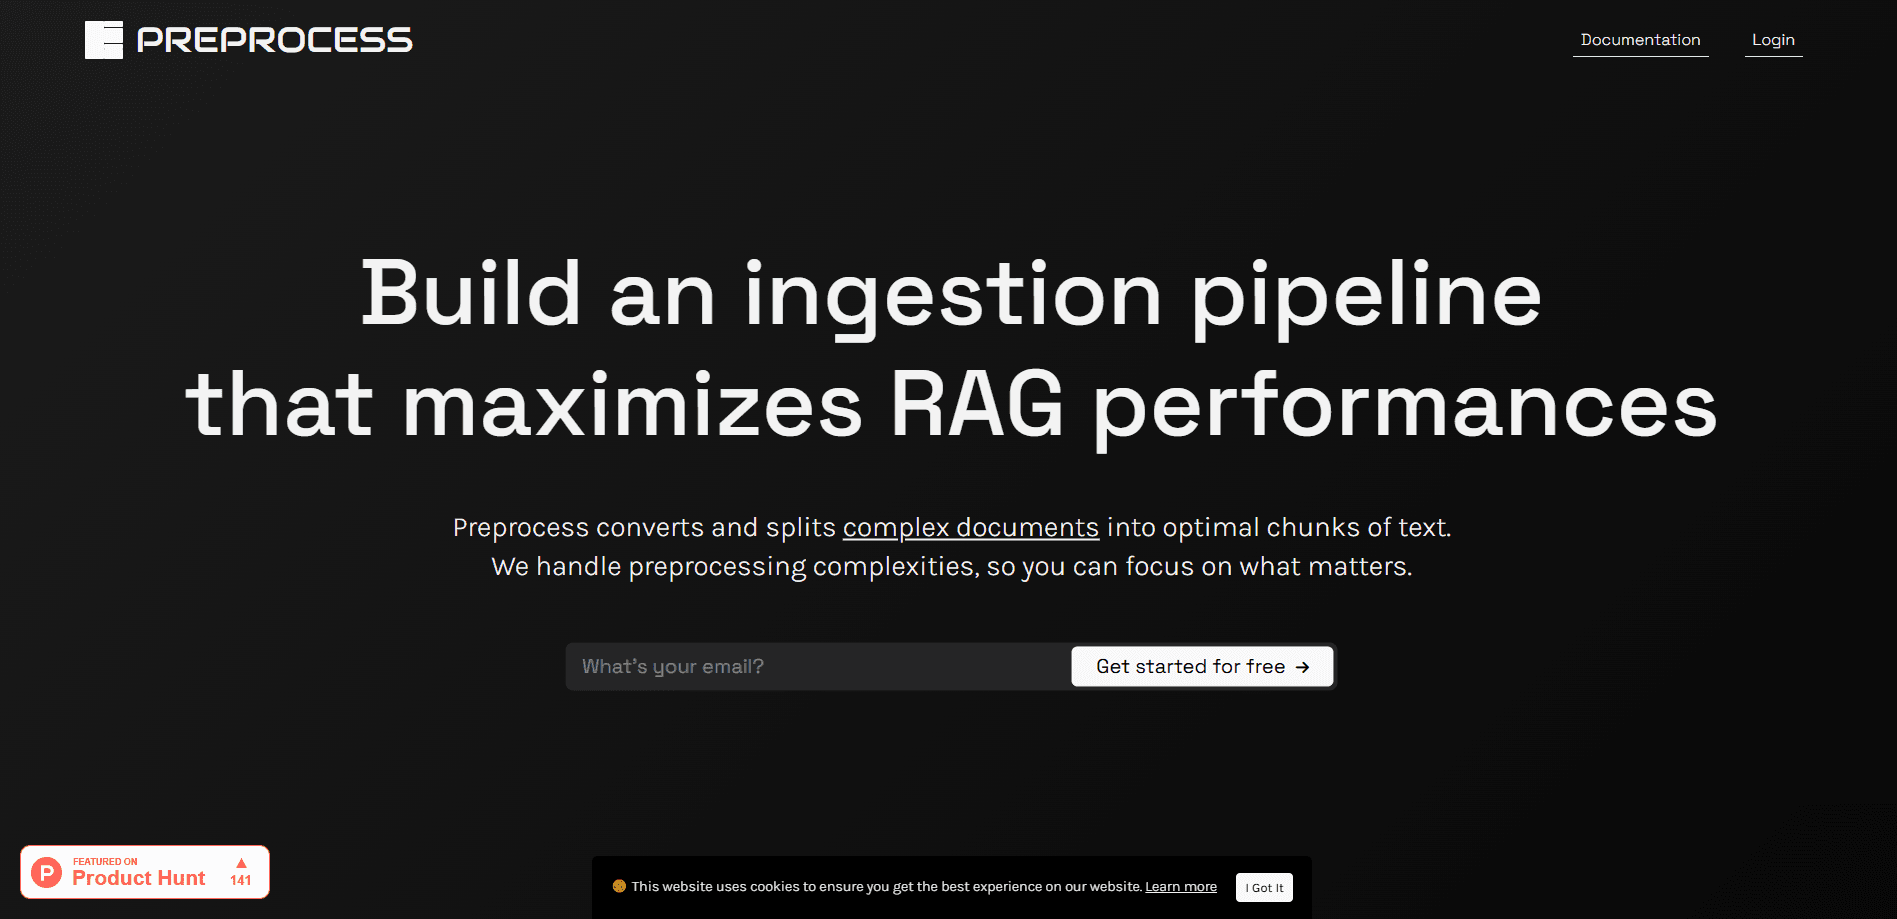
O Preprocess era um serviço de API que transformava documentos longos e complexos em trechos de texto feitos para recuperação. Em vez de cortar um arquivo a cada poucas centenas de palavras, ele lia títulos, seções, parágrafos, tabelas, imagens e listas, e então dividia o conteúdo seguindo a estrutura e o sentido do próprio documento. A empresa apresentava o resultado como dados prontos para RAG: pedaços limpos que você podia vetorizar, indexar e jogar num banco vetorial sem retrabalho antes.
O problema que o pré-processamento de dados para RAG atacava era real. Quase todo time divide os documentos por uma contagem fixa de palavras, e esse método entrega ao modelo o que cair dentro da janela. Uma linha de tabela cola num título sem relação, uma definição perde a lista e o modelo responde com fragmentos soltos. O Preprocess afirmava que a abordagem ciente da estrutura podia melhorar o desempenho do RAG em até 10 vezes, número da própria empresa e não de um teste independente.
Tem algo que hoje pesa mais que qualquer recurso. O serviço preprocess.co não está mais disponível. O site oficial serve um diretório vazio, a empresa encerrou o serviço e tanto o SDK de Python quanto o leitor do LlamaIndex trazem o aviso de que o projeto foi descontinuado e deve ser removido dos projetos.
Getting Started
Eram estes os passos quando o serviço estava no ar.
- Cadastre-se no app do Preprocess e compre um pacote de créditos para liberar a chave de API
- Envie o documento ao endpoint de análise por upload ou pelo SDK de Python
- Deixe a análise assíncrona terminar e receba o resultado no seu webhook ou busque com uma chamada GET em até 24 horas
- Leve os trechos devolvidos direto ao banco vetorial, sem um divisor de texto separado
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Preprocess.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de IA que montavam pipelines RAG
- Desenvolvedores de backend sem parser próprio
- Times de produto que lançavam um assistente de IA
Tarefas
- Fatiar PDFs longos
- Extrair tabelas e listas
- Tratar documentos digitalizados
- Processar arquivos do Office e HTML
Cenários
- Um time jurídico ou financeiro colocando contratos densos numa ferramenta de busca
- Um bot de suporte feito com manuais e páginas de ajuda
- Uma startup sem time de parsing
- Um processo de ingestão em lote
Principais recursos
Chunking inteligente ciente da estrutura
O recurso central dividia os documentos seguindo títulos, seções, parágrafos, tabelas, imagens e listas, e depois agrupava os trechos longos por sentido. Assim cada pedaço mirava um só assunto e a vetorização capturava uma ideia única. A empresa defendia que só isso já elevava a qualidade da recuperação e reduzia as alucinações, porque o modelo parava de receber fragmentos desalinhados.
Amplo suporte de formatos
A API aceitava PDF, arquivos do Microsoft Office, arquivos do OpenOffice, HTML e texto puro por um único endpoint. PDFs digitalizados também entravam, porque a extração de texto rodava antes do chunking. Para times com fontes mistas, isso era uma integração só em vez de um parser por tipo de arquivo.
API assíncrona e webhooks
Analisar um documento longo leva tempo, então a API trabalhava de forma assíncrona. Uma chamada de análise confirmava o recebimento e os trechos prontos chegavam a um webhook ou podiam ser buscados com uma requisição GET por 24 horas. Esse desenho servia a processos em lote, em que dezenas de arquivos são processados de uma vez e nada fica na fila.
SDK de Python e integração com o LlamaIndex
Um SDK chamado pypreprocess envolvia a API em poucas linhas de Python, e um leitor do LlamaIndex carregava arquivos já fatiados ou recuperava resultados anteriores pelo ID do processo. O leitor também devolvia o texto inteiro do documento quando um time queria usar o próprio pipeline. Hoje o SDK e o leitor aparecem como descontinuados.
Preço por créditos, sem assinatura
O Preprocess não cobrava mensalidade. Você comprava um pacote de créditos e recarregava quando acabavam. Uma página de documento ou de apresentação custava um crédito, uma planilha custava um crédito, e arquivos HTML ou de texto eram convertidos em PDF antes da contagem. Esse modelo combinava com times de carga irregular.
Controles para empresas
Os planos mais altos acrescentavam exportação de imagens, controle das fronteiras do trecho, acordos de retenção zero de dados, instalação em servidores próprios e pipelines de processamento sob medida. Essas opções miravam setores regulados, onde os dados de documentos não podem sair da infraestrutura da empresa.
Prós e contras
Prós
- Fatiar por estrutura e sentido fazia a recuperação trazer passagens que não saíam do assunto
- Um endpoint só cobria PDF, arquivos do Office, HTML e texto puro, digitalizados incluídos
- Sem assinatura: apenas pacotes de créditos que atendiam a cargas irregulares
- Os webhooks e o SDK de Python encaixavam em pipelines de ingestão já montados, sem cola extra
- O leitor do LlamaIndex colocava tudo numa pilha RAG comum
Contras
- O serviço está descontinuado, então hoje não há como se cadastrar, comprar créditos ou chamar a API
- O ganho de até 10 vezes vinha da empresa, sem teste independente que o comprovasse
- O preço era em créditos pré-pagos e não num plano medido, o que exigia pagar adiantado por capacidade que talvez você não usasse
- Controles avançados como as fronteiras do trecho e a instalação própria ficavam no plano empresarial
Perguntas frequentes
O Preprocess era uma API de chunking de documentos para pipelines RAG. Ele lia PDF, arquivos do Office, HTML e texto puro, e os dividia em trechos de texto que seguiam a estrutura e o sentido do documento, para que cada pedaço pudesse ser vetorizado e indexado sozinho.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Preprocess.
Alternativas a Preprocess

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Knocket
Knocket (Tencent RTC team) · Produtividade · Negócios · ChatbotO Knocket é uma ferramenta gratuita de chat ao vivo e página de contato: o visitante escreve pelo site, pelo app ou por um link, e você responde pelo Telegram ou por uma única caixa de entrada.

FloorGen
Vinit Kumar (FloorGen) · Produtividade · IA chinesaO FloorGen é um criador de plantas que roda no navegador e transforma uma frase ou um esboço em planta 2D editável e passeio em 3D. Exporta em PDF, DXF ou vídeo, e desenhar não exige conta.