

Query Memory
Query Memory · Produtividade · Aprendizado
O Query Memory é uma plataforma de espaço de trabalho unificada para analisar documentos, gerenciar dados e implantar agentes de IA por meio de uma única pilha baseada em API. Ele reúne análise de documentos, indexação de conhecimento, endpoints de agentes e análise da web atrás de uma só chave de API, então as equipes podem enviar PDFs, planilhas, contratos e e-mails para seus aplicativos sem conectar dezenas de ferramentas separadas. O público-alvo são desenvolvedores e equipes que querem uma camada de memória central para seus produtos de IA, não apenas mais um chatbot.
Sobre Query Memory
O que é o Query Memory
O Query Memory é uma plataforma baseada em API que dá aos aplicativos de IA uma camada de memória. Em vez de juntar serviços de OCR, bancos de dados vetoriais e ambientes de agentes separados, você conecta um SDK e alcança todas as capacidades a partir do mesmo cliente. A proposta no próprio site é direta: analisar documentos, consultar bancos de dados e extrair dados da web por meio de uma API unificada.
O problema que ele resolve é a fragmentação. Um recurso de IA típico precisa de ingestão de arquivos, divisão em blocos, recuperação e uma resposta com base documental. Cada uma dessas etapas costuma significar um fornecedor diferente e uma relação de cobrança diferente. Isso se acumula rápido. O Query Memory junta tudo em um espaço de trabalho com rastreamento de uso, chaves de API e endpoints compartilhados entre serviços.
A limitação mais clara é a escala e o preço. O plano gratuito é pequeno, com limite de 25 análises de documentos e 100 solicitações de API por mês, e o tráfego real de produção empurra você para o plano Pro de US$ 99/mês ou para um acordo Enterprise sob medida. Também é uma plataforma para desenvolvedores, então, se você não escreve código, ainda não há muito aqui para você.
Primeiros passos
- Crie uma conta no Query Memory pela página de cadastro e abra o painel.
- Gere uma chave de API e inicialize o SDK com sua URL base e sua chave.
- Envie documentos para uma base de conhecimento ou mande-os para o endpoint de análise para obter saída estruturada.
- Consulte seu conhecimento indexado, chame um endpoint de agente ou faça uma solicitação de análise da web a partir do mesmo cliente.
- Acompanhe uso, armazenamento e tráfego de endpoints pelo painel da conta conforme o volume cresce.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de Query Memory.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Desenvolvedores de backend e de IA que precisam de ingestão e recuperação de documentos sem montar vários fornecedores.
- Equipes de produto que criam assistentes com base documental capazes de citar os documentos de origem.
- Equipes de dados e operações que querem contratos, relatórios e registros pesquisáveis em um só hub com permissões.
Tarefas
- Analisar PDFs, arquivos DOCX, planilhas, HTML e imagens e transformá-los em elementos estruturados limpos.
- Indexar uma coleção de documentos em uma base de conhecimento e consultá-la com linguagem natural.
- Implantar endpoints de agentes com base documental que respondem com fontes vinculadas.
- Executar extração da web limitada por domínio para trazer contexto externo ao vivo para um aplicativo.
Cenários
- Uma equipe de fintech que quer fazer perguntas sobre contratos de locação e arquivos de subscrição.
- Um produto de suporte que precisa resumir sinistros e documentos de contrato sob demanda.
- Um fluxo de pesquisa que mistura artigos enviados com páginas da web ao vivo em uma única consulta.
Principais recursos
API e SDK unificados
Um só cliente cobre conhecimento, agentes e análise da web, então você inicializa o SDK uma vez e reutiliza a mesma chave de API em todos os lugares. A própria visão da empresa é que isso substitui uma pilha de ferramentas fragmentadas por um único endpoint. Isso importa mais para equipes que, de outra forma, manteriam três integrações e três conjuntos de credenciais. Menos peças móveis. Menos chaves para rotacionar.
Análise de documentos
O Query Memory analisa PDF, DOCX, planilhas, HTML, imagens e texto simples e os transforma em elementos estruturados. O site afirma que seus modelos multimodais especializados atingem mais de 98% de precisão em layouts complexos, superando o OCR tradicional e os LLMs genéricos. Trate esse número como uma afirmação do fornecedor até testá-lo com seus próprios documentos.
Indexação de conhecimento
Os arquivos se conectam a bases de conhecimento pesquisáveis que suportam recuperação semântica rápida. As consultas retornam trechos classificados e o contexto ao redor, então você pode alimentar um modelo com material embasado em vez de despejar texto bruto, e cada hub mantém permissões para que documentos sensíveis fiquem restritos aos usuários certos.
Endpoints de agentes
Você pode implantar agentes de IA com base documental com controles de modelo, prompts e respostas cientes das fontes. As consultas dos agentes passam pela mesma superfície do SDK. Isso mantém a integração rasa. Para equipes que lançam assistentes, elimina a necessidade de hospedar e escalar um ambiente de agentes separado.
Análise da web
A análise da web executa extração limitada por domínio e recuperação classificada para trazer contexto externo ao vivo. Ela usa os mesmos formatos de saída do lado dos documentos. Uma página da web e um PDF chegam com o mesmo formato. Essa consistência é o ganho prático quando você combina fontes internas e externas.
Conectores e integrações
A plataforma lista conectores para Microsoft SharePoint, Google Drive, Snowflake, Databricks, Oracle Cloud Infrastructure e Dropbox, além de afirmar que há mais 400. Essa cobertura deixa as equipes indexarem os dados onde eles já estão, em vez de migrar tudo antes. Vale verificar a profundidade de cada conector por fonte antes de se comprometer.
Uso e visibilidade operacional
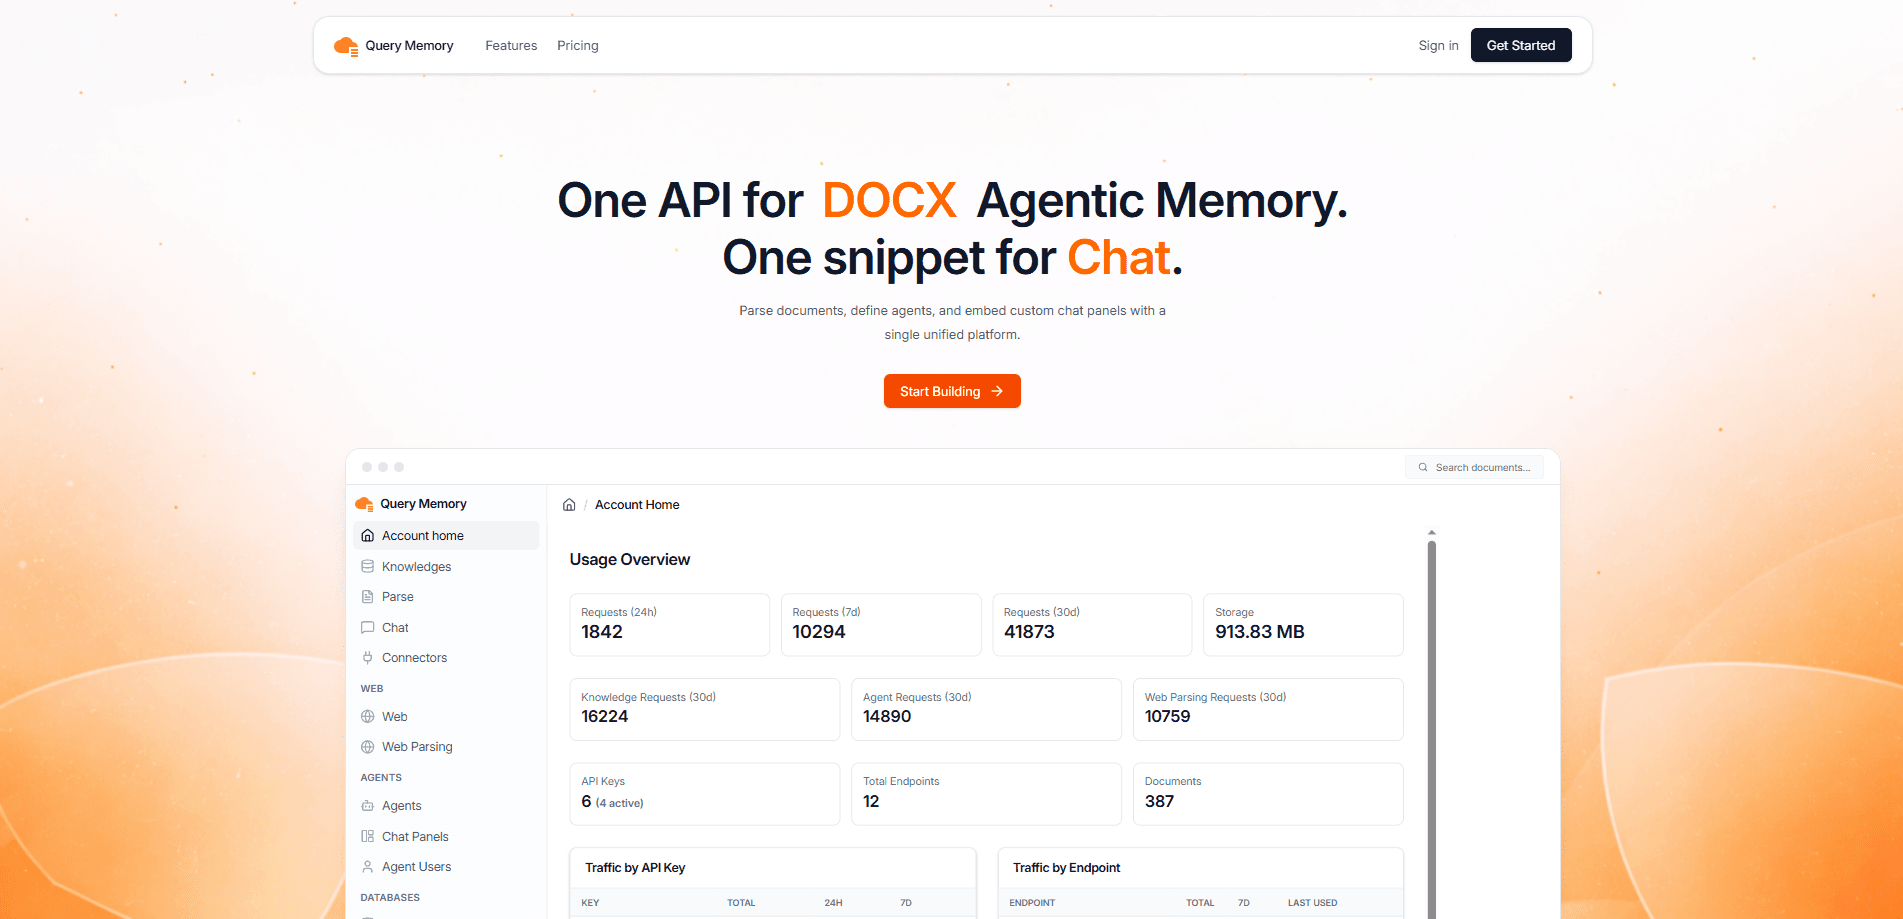
O painel mostra solicitações em 24 horas, 7 dias e 30 dias, armazenamento usado, tráfego dividido por chave de API e endpoint, e atividade recente do serviço. Para equipes que rodam isso em produção, essa visibilidade responde a uma pergunta simples. Qual endpoint está disparando, e qual chave está fazendo isso? Não é uma suíte completa de observabilidade. Ainda assim, cobre o básico que você precisa para ver qual serviço está realmente custando dinheiro.
Prós e contras
Prós
- Uma única chave de API e um único SDK cobrem análise, conhecimento, agentes e consultas na web, o que reduz o trabalho de integração.
- A saída estruturada se mantém consistente entre tipos de documentos e páginas da web.
- O plano gratuito deixa você avaliar a API de análise de documentos e a API de base de conhecimento antes de pagar.
- Os hubs de conhecimento com permissões mantêm registros sensíveis restritos.
- Os conectores com SharePoint, Drive, Snowflake e fontes semelhantes reduzem a migração de dados.
Contras
- O plano gratuito é apertado, com 25 análises e 100 solicitações de API por mês, e não aguenta testes reais.
- O Pro salta para US$ 99/mês, e os excedentes são cobrados conforme o uso, então os custos crescem com uso pesado.
- É uma plataforma para desenvolvedores sem um caminho no-code relevante, então usuários não técnicos ficam de fora.
- As afirmações de preço e precisão vêm do fornecedor, e não há benchmarks independentes publicados.
Perguntas frequentes
É uma camada de memória para aplicativos de IA. Você envia documentos, bancos de dados e fontes da web, e ele devolve dados estruturados, conhecimento pesquisável e respostas de agentes com base documental por meio de uma única API.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a Query Memory.
Alternativas a Query Memory

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Knocket
Knocket (Tencent RTC team) · Produtividade · Negócios · ChatbotO Knocket é uma ferramenta gratuita de chat ao vivo e página de contato: o visitante escreve pelo site, pelo app ou por um link, e você responde pelo Telegram ou por uma única caixa de entrada.

FloorGen
Vinit Kumar (FloorGen) · Produtividade · IA chinesaO FloorGen é um criador de plantas que roda no navegador e transforma uma frase ou um esboço em planta 2D editável e passeio em 3D. Exporta em PDF, DXF ou vídeo, e desenhar não exige conta.