
UbiOps
UbiOps · Produtividade · Marketing · Aprendizado · Outros
O UbiOps é uma plataforma de serving de modelos de IA e MLOps que transforma seu código Python ou um LLM em uma API escalável na sua nuvem, no seu hardware ou nos dois ao mesmo tempo.
Sobre UbiOps
About
O que é o UbiOps
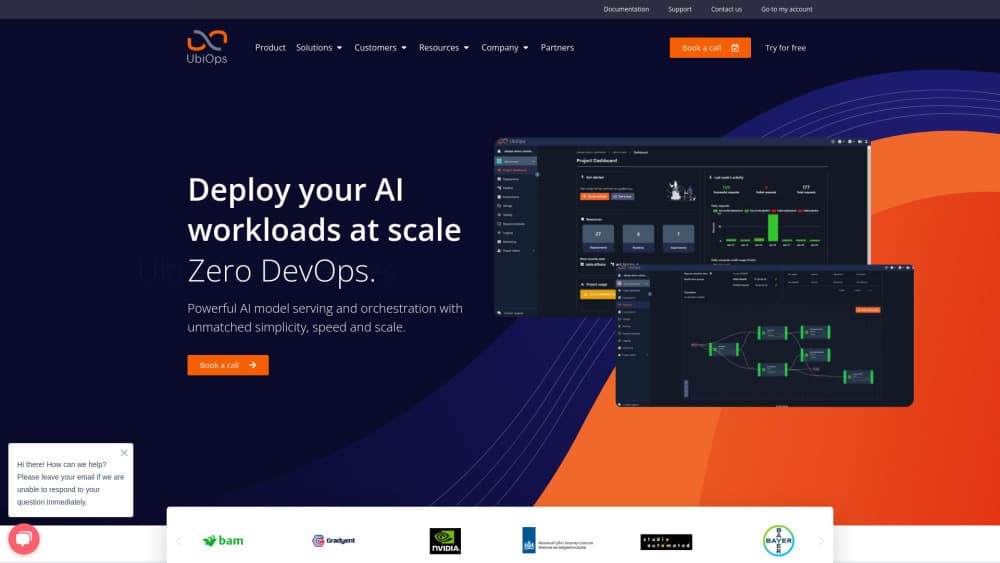
O UbiOps é uma plataforma holandesa para equipes que precisam colocar IA em produção sem construir a própria camada de serving de modelos em GPU e CPU. Você entrega o código do modelo ou uma imagem de contêiner. O UbiOps cuida do build do contêiner, publica o endpoint, administra a fila de requisições, o balanceamento, o autoescalonamento e os logs e métricas que vêm junto.
A proposta central é liberdade de infraestrutura. Um plano de controle fica acima dos seus ambientes de computação e os trata como um único pool, então uma carga pode rodar hoje numa GPU local e amanhã explodir para uma região de nuvem pública. É isso que se chama de IA em nuvem híbrida, e é o motivo pelo qual hospitais, concessionárias de energia e órgãos públicos com regras de residência de dados escolhem a plataforma: eles não podem entregar informação a um fornecedor de API de modelos.
Vale dizer os limites logo de cara. Não existe construtor visual de modelos nem catálogo de aplicações prontas. Você precisa de código funcionando, de alguma familiaridade com Docker e de clareza sobre o que seu endpoint deve receber. Quem procura um criador de chatbots sem programação está no produto errado.
Primeiros passos
- Crie uma conta na web do UbiOps e instale o cliente Python ou a CLI se o trabalho for por script.
- Defina um ambiente com suas dependências ou envie sua própria imagem Docker quando os runtimes Python padrão não servirem.
- Crie um deployment, suba o código e declare o esquema de entrada e saída da API.
- Escolha um tipo de instância, defina o mínimo e o máximo de instâncias e ligue o escalonamento a zero se o tráfego vier em picos.
- Envie uma requisição para o endpoint para testar e, quando precisar de um fluxo completo, encadeie vários deployments em um pipeline.
Informações do produto
Uma visão rápida dos preços, das plataformas compatíveis e do desempenho de UbiOps.
Ideal para
Os usuários, tarefas e cenários em que esta ferramenta se encaixa melhor.
Usuários
- Engenheiros de machine learning
- Equipes de ciência de dados em setores regulados
- Engenheiros de plataforma e de MLOps
Tarefas
- Servir um modelo como endpoint REST
- Rodar inferência de modelos de linguagem nas suas GPUs
- Encadear pré-processamento, modelo e pós-processamento
- Trabalhos de treino com picos de demanda
Cenários
- Um serviço de visão computacional com picos imprevisíveis
- Uma prova de conceito que precisa virar produto
- Uma saída de um único fornecedor de nuvem
Principais recursos
Deployments com endpoint de API gerenciado
Cada deployment ganha endpoint HTTP versionado, fila de requisições e validação de entrada próprios. Você envia o código em um runtime compatível ou seu próprio contêiner, e o UbiOps compila, inicia e expõe o serviço. Versões novas podem ser promovidas ou revertidas sem apagar a anterior, então um lançamento ruim se resolve em dois cliques.
Autoescalonamento com escala a zero
A plataforma acompanha o volume de requisições e adiciona ou remove instâncias sozinha. Com a escala a zero, deployments ociosos desligam por completo, e um modelo que recebe poucas chamadas por dia não paga 24 horas de GPU parada. Os grupos de tipos de instância permitem que um deployment prefira suas GPUs locais e recorra à nuvem quando elas estiverem ocupadas.
Pipelines e operadores de fluxo
A orquestração de IA é a parte que quase todo time subestima, e aqui a plataforma se paga. Pipelines conectam vários deployments em um serviço que responde a uma única chamada, e cada objeto dentro deles escala de forma independente. Os operadores incluídos cuidam de dividir, remontar, filtrar e encaminhar dados conforme condições, o que cobre boa parte da fiação que normalmente se escreve na mão. Um pipeline pode ser importado, exportado e compartilhado com o time.
Experimentos e execuções de treinamento
Além de servir, o UbiOps executa jobs de treino na mesma infraestrutura. Um experimento fixa ambiente, código e hardware; as execuções rodam sobre ele, e você compara resultados entre execuções na interface web. Os artefatos ficam em um armazenamento que você controla, então o modelo treinado está a um passo de virar deployment.
Serviços próprios e sua própria imagem Docker
Serviços expõem servidores HTTP de longa duração dentro de um deployment. É assim que equipes rodam servidores GenAI de alta vazão que não cabem no formato de requisição padrão. Junto com imagens Docker próprias, esse caminho atende pilhas de inferência no estilo vLLM, aplicativos com vários endpoints e qualquer coisa que espere HTTP puro.
Monitoramento, versionamento e controle de acesso
Logs, métricas de uso e alertas vêm com a plataforma, então um deployment com problema aparece antes de um usuário reclamar. Acesso por papéis, trilhas de auditoria e criptografia cobrem a parte de conformidade, e as configurações de tratamento de dados deixam você decidir se os payloads são armazenados.
Prós e contras
Prós
- Roda no seu hardware, em nuvem pública ou nos dois, algo que poucos serviços gerenciados de inferência permitem.
- O autoescalonamento inclui escala a zero, então modelos usados em picos ou raramente não estouram o orçamento.
- Pipelines com operadores incluídos cortam o código de cola em fluxos de IA com várias etapas.
- Versionamento e reversão deixam cada troca de modelo menos arriscada em times sem processo de release próprio.
- A mesma plataforma serve modelos e roda treinos, o que evita um segundo fornecedor de computação.
Contras
- Não existe tabela de preços pública. Você fala com o time comercial antes de estimar a fatura mensal, e isso atrasa o planejamento.
- É preciso escrever código de deployment e entender contêineres. Analistas e usuários de negócio não vão longe sozinhos.
- A interface parte do princípio de que você conhece o vocabulário de MLOps (ambientes, tipos de instância, requisições), então a primeira semana pede leitura de verdade.
- Aqui ninguém treina nem ajusta um modelo de base por você. A plataforma roda o seu código, então o trabalho de modelagem continua do seu lado.
Perguntas frequentes
Ele pega seu código de modelo ou de processamento de dados e o executa como uma API de produção. A plataforma monta o contêiner, inicia o serviço, distribui requisições entre instâncias e ajusta a capacidade conforme o tráfego.
Conteúdo relacionado
Explore ferramentas, skills e artigos relacionados a UbiOps.
Alternativas a UbiOps

Base Code
Base44 (Wix) · Programação · ProdutividadeO Base Code é um ambiente de desenvolvimento em nuvem compartilhado da Base44. O time descreve mudanças em um repositório do GitHub pelo chat, confere tudo na prévia e envia o resultado como pull request.

Knocket
Knocket (Tencent RTC team) · Produtividade · Negócios · ChatbotO Knocket é uma ferramenta gratuita de chat ao vivo e página de contato: o visitante escreve pelo site, pelo app ou por um link, e você responde pelo Telegram ou por uma única caixa de entrada.

FloorGen
Vinit Kumar (FloorGen) · Produtividade · IA chinesaO FloorGen é um criador de plantas que roda no navegador e transforma uma frase ou um esboço em planta 2D editável e passeio em 3D. Exporta em PDF, DXF ou vídeo, e desenhar não exige conta.