
Agentic Document Extraction
LandingAI · 生產力
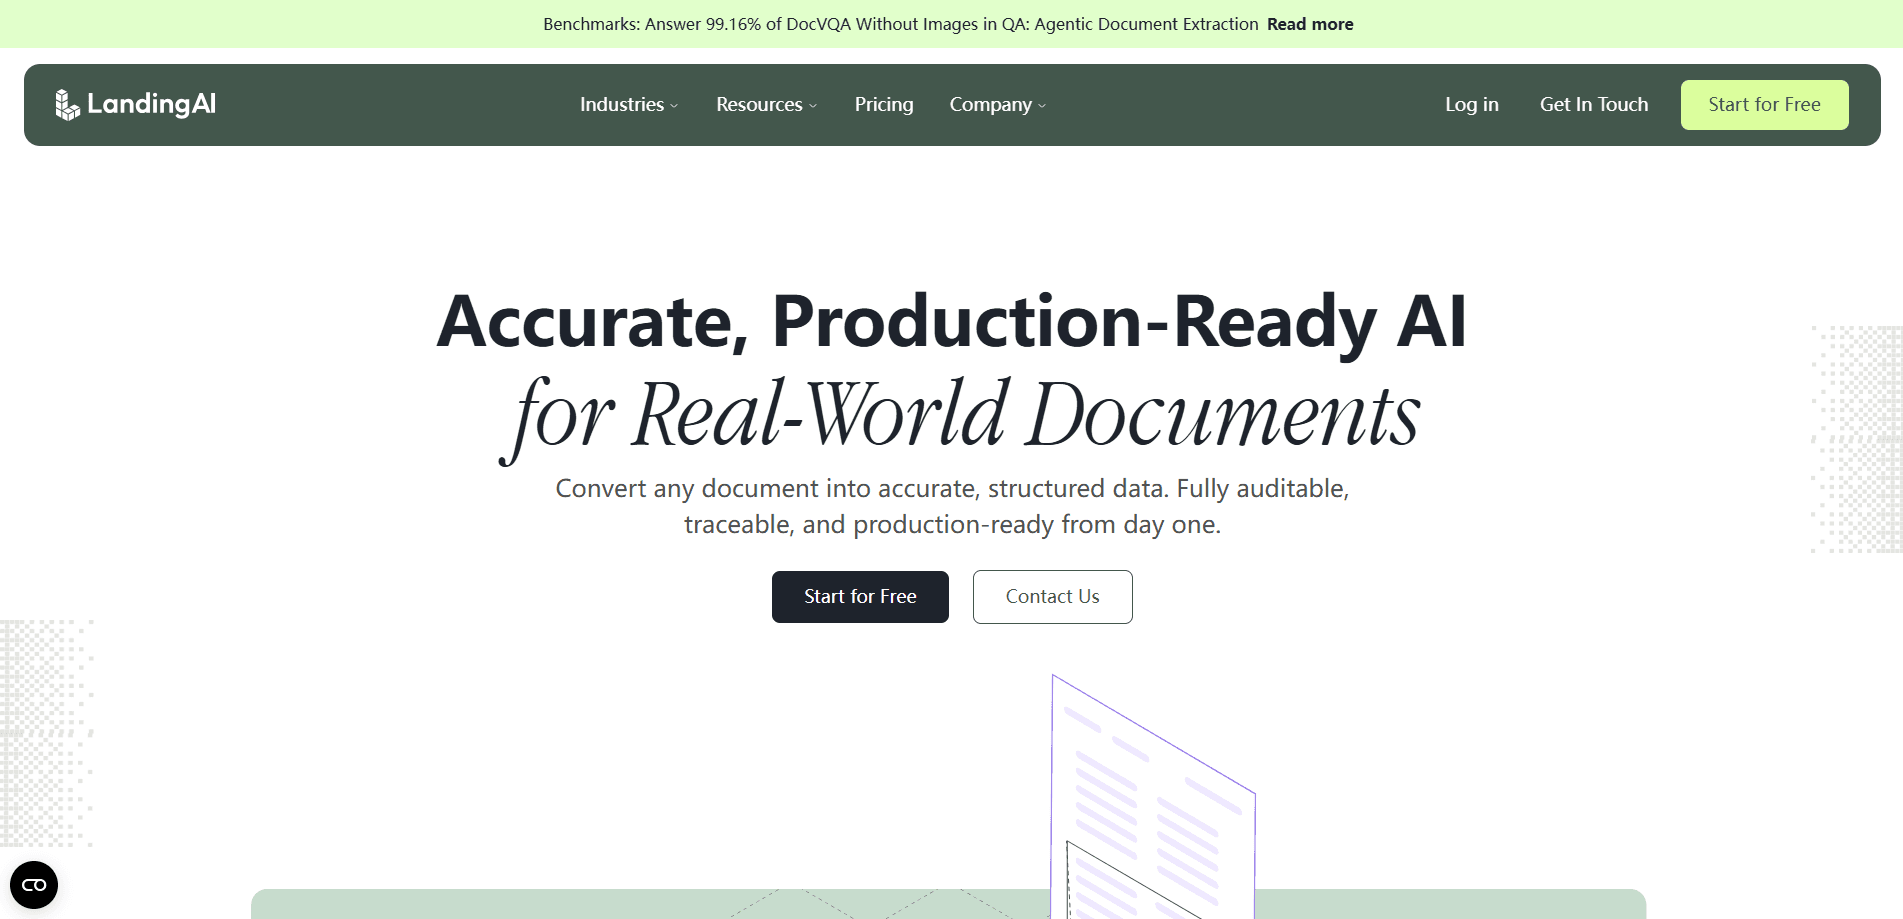
Agentic Document Extraction(ADE)是 LandingAI 的文件 AI 平台,能把複雜的 PDF、掃描檔與圖片轉成結構化 JSON 與可直接餵給 LLM 的 Markdown。它是為那些不滿足於純文字輸出的團隊打造的。每個擷取出來的區塊都附帶頁碼、精確座標,以及可供稽核的信心分數。如果你的流程跑的是發票、貸款文件或法規報告,ADE 正是衝著這類工作而來。把它想成帶有完整軌跡的 PDF 轉 JSON。
關於 Agentic Document Extraction
什麼是 Agentic Document Extraction
Agentic Document Extraction 是 LandingAI 推出的視覺優先文件擷取 API。它不把文件當純文字來讀,而是像人一樣看頁面,再回傳附帶每個欄位位置的結構化資料。輸出是階層化錨定的 JSON 或 Markdown,可直接餵進資料庫、搜尋索引或 RAG 流程。不必重新解析。
它吸引人之處在於可追溯性。拿通用大型語言模型處理 PDF 的團隊,常得對抗幻覺與來源標註缺失。ADE 把每筆擷取內容綁回頁碼與邊界框,審閱者能直接跳到來源核對。
要注意的是,這是開發者工具,不是桌機應用程式。ADE 以 REST API 加上 Python 與 TypeScript 函式庫的形式販售,所以你需要有人熟悉怎麼接整合。這筆建置成本值得嗎?對大量文件的工作來說,通常值得。計價走的是點數制,不是固定月費。這讓小規模測試很便宜,但成本會隨處理量成長。
開始使用
- 到 ade.landing.ai 註冊帳號,領取 Explore 方案附贈的免費點數。
- 產生 API 金鑰,設定給 Python 或 TypeScript 函式庫,或直接呼叫 REST API。
- 把文件送到 Parse API,取得閱讀順序的 Markdown 與每個區塊的座標。
- 想抽出特定欄位成結構化 JSON 時,加上帶 schema 的 Extract API。
- 準備上線後,把同一份工作移到標準層級,點數用量約可省下一半。
產品資訊
快速了解 Agentic Document Extraction 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 後端與資料工程師:ADE 以 API 為優先,若你熟悉呼叫 REST 端點,或安裝用戶端函式庫並處理 JSON 回應,最能發揮它的價值。
- 營運與法遵團隊:座標與信心中介資料讓人工審閱變得可行,因為你可以把低信心的欄位轉給真人,而不是信任一個不透明的結果。
- 打造 RAG 流程的資料科學團隊:帶錨定位置的語意切塊,比按字元數切開原始文字,能給檢索系統更乾淨的上下文。切塊更好,答案就更好。
任務
- 把發票與對帳單轉成結構化紀錄:Extract API 會把總額、日期、帳號等具名欄位抽成可直接存放的 JSON。
- 大規模 PDF 轉 JSON:送出一批檔案,拿回可預期的結構,而不是自由文字。
- 從密集表格與多頁報告擷取結構化資料:在文字層擷取通常會壞掉的版面上,視覺優先的解析依然撐得住。
- 稽核文件解析結果:信心分數會標出值得再看一眼的區塊,審閱時間就能花在真正有風險的地方。
情境
- 貸款與信用審核:從混雜的文件包中抓出關鍵數字與風險指標,不必逐筆人工輸入。
- 認識客戶(KYC)查核:把身分證件與表單裡的識別資料抽成一致的結構。
- 法規申報:把封存文件轉成可查詢的資料集,供法遵審查使用。
主要功能
視覺優先解析
ADE 透過自家的視覺模型讀文件,而不是依賴內嵌的文字層。這在掃描檔、密集表格與多頁版面上很重要,因為一般的 PDF 文字擷取在這些情況下常會遺漏或打亂內容。純文字擷取在這裡行不通。結果是閱讀順序的 Markdown,外加一棵可用程式走訪的結構化區塊樹。
錨定座標與信心分數
每個區塊都回傳頁碼、座標與信心分數。這正是把 ADE 與通用擷取腳本區分開來的地方。你可以向審閱者指出某個數值確切來自何處,也能過濾掉低於品質門檻的結果。對受監管的工作來說,這就是可用流程與沒人敢信流程之間的差別。
以 Schema 驅動的欄位擷取
Extract API 接受你定義的 schema,並回傳相符欄位成結構化 JSON。要抽什麼由你決定,無論是發票總額、合約條款或明細清單。因為 schema 驅動輸出,下游系統拿到的是可預期的形狀。不會有意外。這勝過之後還得重新解析的自由文字。
模組化 API 與 SDK
ADE 把工作拆成解析、分割與擷取等 API,你可以挑流程需要的部分。你能透過 REST 呼叫,或用 Python 與 TypeScript 函式庫,而且同一份工作在 Playground、API 或 SDK 上執行的費用都一樣。
你掌控的服務層級
每份工作跑在標準或優先層級上。標準是 API 呼叫的預設值,點數用量約為優先層級的一半,而 Playground 一律跑優先層級。這給你一個簡單的槓桿。先用優先層級快速做原型,再把正式流量移到標準層級,看著每頁成本下降。
點數制計價
一切都以單一點數單位運作,一點等於一美分。點數在 ADE 所有服務間可通用,所以你只要追一個餘額,而不是一張按功能計費的價目表。你能用卡片自助購買,或走年度企業合約,兩者消耗的費率相同。
優缺點
優點
- 輸出包含頁碼、座標與信心分數,結果可稽核,而不是黑箱。
- 視覺優先解析能處理掃描文件、複雜表格與多頁版面,這些正是文字層工具會卡住的地方。
- 模組化的解析、分割與擷取 API 讓你只採用流程真正需要的部分。
- 標準層級的成本約為優先層級的一半,提供控制每頁支出的明確槓桿。
- Explore 方案慷慨的免費點數,讓你投入前能便宜地測試真實工作量。
缺點
- 只有 API、沒有終端使用者應用程式,導入需要工程時間來建置與維護整合。
- 點數成本隨文件量與複雜度成長,重度使用需要持續追蹤預算,而不是固定月費。
- 企業方案採報價制,不聯絡業務就難以估算大規模成本。
常見問題
它把複雜的 PDF 與圖片轉成結構化 JSON 與 Markdown,供後續流程使用。常見用途包括從發票抽出欄位、建立檢索資料集,以及把文件封存轉成可查詢的資料。
相關內容
探索與 Agentic Document Extraction 相關的工具、技能與文章。
Agentic Document Extraction 替代方案

Base Code
Base44 (Wix) · 程式設計 · 生產力Base Code 是 Base44 推出的共享雲端開發環境。團隊在對話中描述對既有 GitHub 儲存庫的修改,看著預覽確認結果,再以 Pull Request 交回工程團隊。

Knocket
Knocket (Tencent RTC team) · 生產力 · 商業 · 聊天機器人Knocket 是免費的線上客服與聯絡頁面工具,訪客可從網站、App 或一條分享連結傳訊息,你在 Telegram 或單一收件匣就能回覆。

FloorGen
Vinit Kumar (FloorGen) · 生產力 · 中國 AIFloorGen 是瀏覽器上的平面圖製作工具,能把一句描述或一張草圖變成可編輯的 2D 平面圖與 3D 導覽。可匯出 PDF、DXF 或影片,不註冊也能開始畫。