
Avaturn Live
Avaturn · 圖片 · 語音與語言
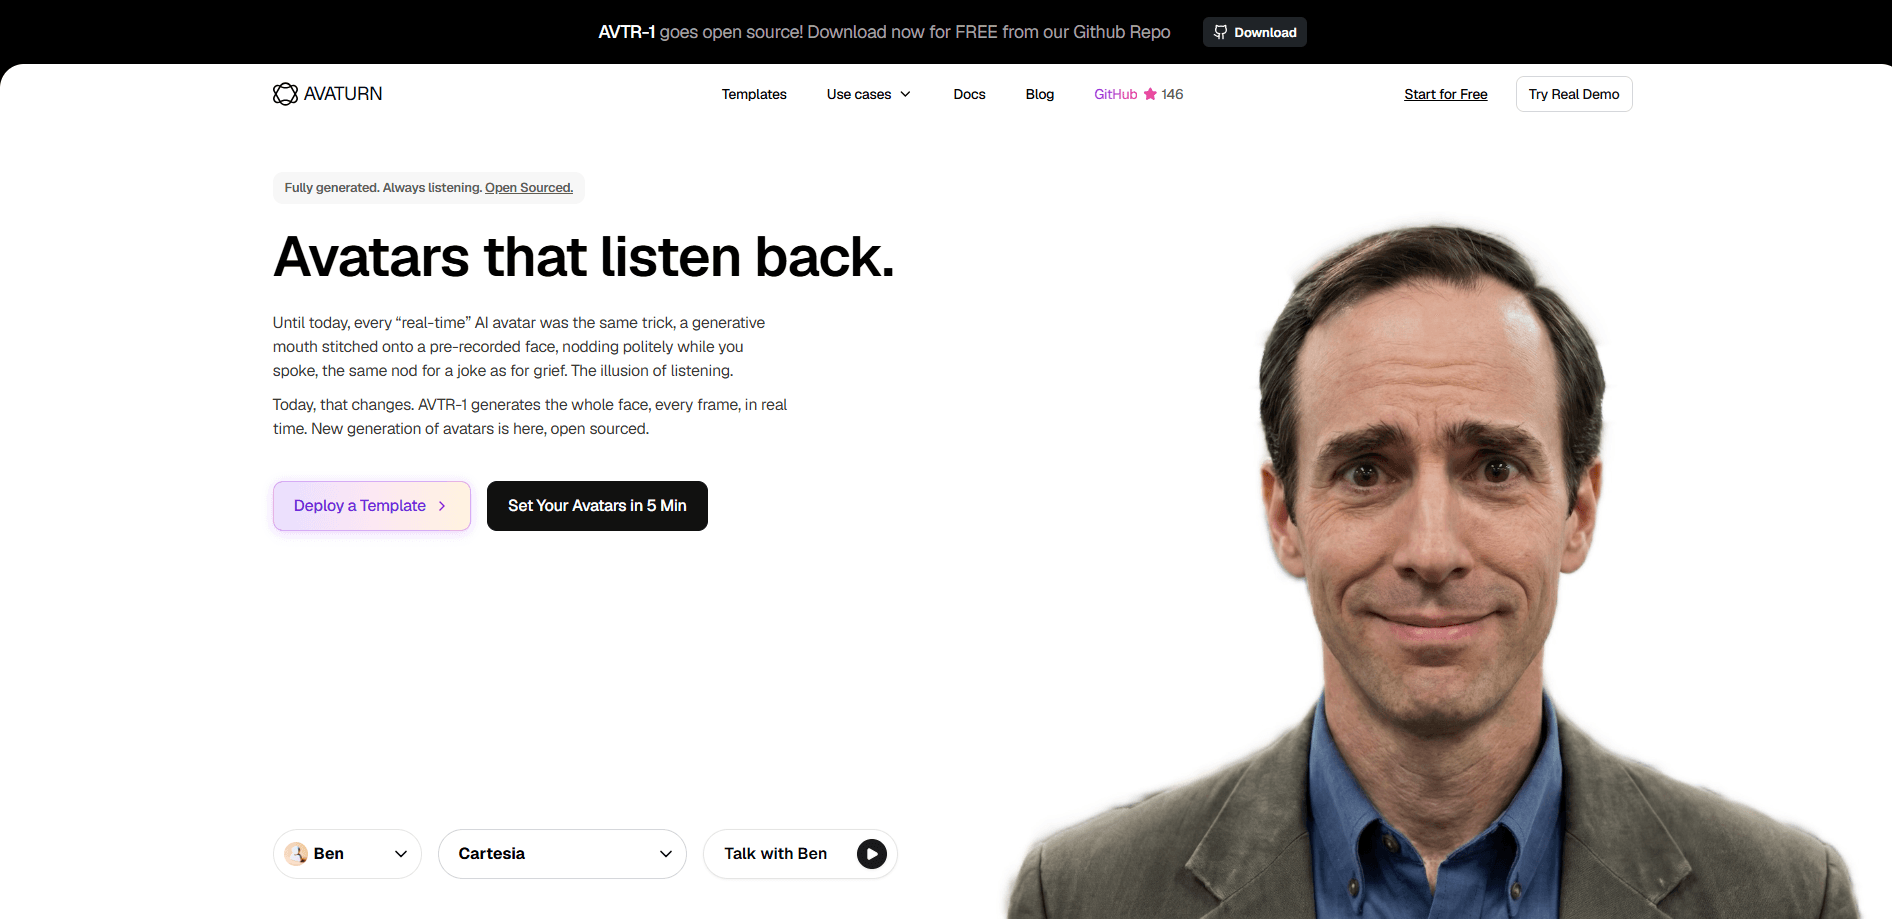
Avaturn Live 是一套即時 AI 虛擬人平台,能把單一張人像照片變成完整動起來的臉,用於即時對話。那為什麼它看起來比一般的說話虛擬人生成器還不詭異?因為它算的是臉的每一個畫格,不是只有嘴巴。角色在別人說話時會眨眼、反應、表現情緒。你還可以拿到現成的示範、範本,以及一套 SDK/API,幾分鐘內就能把對話式 AI 虛擬人放進語音應用。
關於 Avaturn Live
Avaturn Live 是什麼
Avaturn Live 是一套打造擬真 AI 虛擬人的平台,讓它們在即時語音對話中撐得住場面。核心模型 AVTR-1 在單一張 GPU 上以每秒 25 個畫格輸出同步的臉,而且它做的不只是動嘴巴。整張臉會逐格動起來,這也是公司說這些虛擬人是「聽回來」而不只是「說話」的原因。
它解決的問題,是每個做語音代理的人遲早都會碰到的。合成語音的聊天機器人聽起來沒問題,直到你給它一張臉,然後那張臉就出賣了它。傳統的說話頭像工具只把音訊對應到嘴唇,所以使用者一說話,虛擬人就呆滯地盯著。Avaturn Live 讓角色在對話的另一半時間持續反應,這在家教、業務演練與客服上都重要,因為在那裡沉默看起來就像困惑。
主要限制在硬體。自己跑模型需要一張夠好的 NVIDIA GPU、CUDA 12.x 與 TensorRT 10.x,所以自架不是一台筆電就能搞定的週末專案。對多數團隊來說,代管 API 或現成範本才是實際的起點。寫這篇時,我在網站上找不到公開的 API 費率,所以在直接向廠商確認之前,任何成本估計都請當作未經查證。
開始使用
- 打開儀表板,透過公司自家的上傳流程,大約五分鐘就能設定好一個虛擬人。
- 挑一個範本或從示範開始,這樣你就不必從零打造工作階段的邏輯。
- 選一張人像照片或自行上傳,接著接上你的說話與聆聽音訊串流。
- 在瀏覽器裡測試即時工作階段。檢查唇形同步,以及在你連線上的反應時機。
- 要上正式環境,就透過 SDK 或 API 連線,或複製 AVTR-1 的程式庫,在自己的 GPU 上自架。
產品資訊
快速了解 Avaturn Live 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 打造語音代理的開發者:他們需要一張在使用者說話時會反應的臉,而逐格算圖恰好就處理了這一點。
- 業務與客服團隊:他們用虛擬人做角色扮演與異議處理訓練,而一個呆滯的眼神很快就會戳破假象。
- 教育者與語言家教:即時反應能讓學生在課程的停頓中持續投入。
任務
- 業務電話的即時角色扮演:虛擬人面對異議會反應而不是凍住,所以練習起來更接近真實對話。
- 搭配發音回饋的語言練習:臉部更新很快,讓糾正感覺是即時的,而不是慢半拍。
- 客服代理:一個看得見、正在聆聽的虛擬人,能在機器人找答案時緩和等待感。
情境
- 一個下午就做出 AI 產品原型:範本與示範讓你還不必定下技術堆疊,就能先交出可運作的虛擬人工作階段。
- 自架私有模型:有資料規範的團隊可以複製 AVTR-1,全都在自己的硬體上跑。
- 給客戶看的瀏覽器示範:代管流程跑在網頁瀏覽器裡,所以想展示給誰看都不必安裝任何東西。
主要功能
逐格臉部動畫
大多數虛擬人工具只動嘴唇,這就是它們看起來詭異的原因。Avaturn Live 每一格都算整張臉,所以虛擬人會眨眼、改變表情,並對說話的人反應。這就是說話頭像與一個彷彿就在現場的角色之間的差別。
主動聆聽與情緒反應
模型接收雙軌音訊,一軌是說話,一軌是對方。然後它對兩者都反應。對方說話時它不會只是安靜下來。在家教、業務或客服場合,這種反應能讓對話不至於像在對著暫停的影片說話。
單張 GPU 上每秒 25 個畫格
AVTR-1 以每五格為一批、每秒 25 格產生動作。換算下來每批是 200 毫秒的輸出。任何快到能壓在這條線以下的 GPU 都能即時運作。根據 Avaturn 公布的數字,L40 處理一批要 84 毫秒,RTX 4060 Ti 要 166 毫秒,L4 則剛好壓線在 202。超出你顯卡的上限就意味著掉格,但不會當掉。
開源模型與自架能力
AVTR-1 是開源,權重、推論程式碼與 TensorRT 加速的版本都在 GitHub 上。有嚴格資料規範的團隊可以拉下模型,在自己的防火牆後跑。代價是設定工夫:CUDA 12.x、TensorRT 10.x,以及每台機器各自編譯的引擎。
範本與現成示範
平台附上可運作的範例,包括業務角色扮演代理、語言家教,以及資料分析師人格。每一個都以即時示範與可部署範本的形式提供。對小團隊來說,這是從「我們想要虛擬人」到「主管能點得下去的東西」最快的一條路。
SDK 與 API 整合
你可以透過虛擬人 SDK 或 API,把虛擬人加進現有的語音應用,或改用完全自架的後端。不必自己打造算圖流程。即時工作階段後端會處理串流。你的應用只要送出音訊、顯示視訊。
優缺點
優點
- 每一格都算整張臉,所以虛擬人在停頓期間會反應,而不是凍成靜止畫面。
- 在單張 GPU 上達到每秒 25 格,並公布 L40、RTX 4060 Ti 等常見顯卡的延遲數字。
- AVTR-1 模型開源,所以躲在防火牆後自架是真實可行的選項。
- 範本與示範縮短了從想法到可點擊原型的時間。
缺點
- 自架需要 NVIDIA GPU,還要 CUDA 12.x 與 TensorRT 10.x,而且引擎得在每台機器上重新編譯。這就排除了用筆電快速架設的可能。
- 網站上沒有公布價格,所以你無法只從 API 頁面編預算,必須去問廠商。
- 像 L4 這種較小的 GPU 剛好卡在即時線上,所以更吃重場景的餘裕很薄。
常見問題
它是一套即時 AI 虛擬人平台,在即時語音對話中讓整張臉動起來,而不只是唇形同步。它的 AVTR-1 模型同時驅動代管產品與自架版本。
相關內容
探索與 Avaturn Live 相關的工具、技能與文章。
Avaturn Live 替代方案

Google EmbeddingGemma 2
Google DeepMind · 寫作 · 圖片 · 程式設計Google EmbeddingGemma 2 是 7.4 億參數的開源模型,能把文字、程式碼、圖片、音訊與影片畫面轉成同一個 768 維空間裡的向量,在手機與筆電上就能執行。

Tractionwave
TractionWave · 圖片 · 行銷TractionWave 是針對靜態廣告的 AI 注意力熱圖工具。上傳 PNG 或 JPG,就能取得預測注意力、排序後的熱點與修正建議,不必等預算花完才知道問題在哪。

Imejis.io
Imejis.io · 圖片 · 行銷Imejis.io 是給代理與行銷團隊使用的 AI 設計工作室。你用日常說法描述一張圖,它會寫好文案、排出版面、自動調整成各種尺寸,最後匯出完成檔。