
Hierarchical Reasoning Model
Sapient Intelligence · 商業 · 其他
Hierarchical Reasoning Model(HRM)是 Sapient Intelligence 推出的類腦 AI 架構。它在單次前向傳遞中完成推理,不需要思維鏈,只靠 2700 萬參數就能解開高難度謎題。
關於 Hierarchical Reasoning Model
What Is Hierarchical Reasoning Model
Hierarchical Reasoning Model 是一種遞迴神經網路架構,由 Sapient Intelligence 在 2025 年 6 月發表。它的靈感來自人腦如何把工作分派給速度不同的區域。高階模組負責緩慢、抽象的規劃,低階模組處理快速、細部的運算。兩者來回交接控制權,直到模型收斂出答案。
它瞄準的是當前大型語言模型的弱點。多數模型依賴思維鏈(CoT),把每個推理步驟寫成文字。這種做法只要一步想錯就整條推理崩掉,還需要大量標註資料,而且因為模型得生成很多字,速度很慢。HRM 直接跳過書寫步驟,在潛空間裡完成推理,單次前向傳遞就給出結果。
但有個前提:適用範圍有限。HRM 不是能跟你閒聊的通用助理。它針對單一任務類型從頭訓練,練好後就專門解那類題目,一個為數獨調過的模型只會玩數獨。Sapient 後來用 HRM-Text 把這套架構延伸到文字,做成約 10 億參數的生成模型,但最初的版本是一台範圍狹窄的推理引擎,不是聊天機器人的直接替代品。
Getting Started
- 前往 Sapient Intelligence 官網或 GitHub 上的 sapientinc/HRM 儲存庫,閱讀論文與架構說明
- 複製儲存庫,安裝 requirements.txt 裡列出的 Python 相依套件
- 準備符合格式的任務資料集,例如數獨題目或迷宮格線
- 執行 pretrain.py 從頭訓練模型,再用 evaluate.py 或 ARC 筆記本量測結果
產品資訊
快速了解 Hierarchical Reasoning Model 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- AI 研究者:研究推理架構的人,想要一個可重現的模型來測試計算深度與潛空間解碼,手上有公開程式碼與論文
- 機器學習工程師:需要小型模型解決固定符號任務的開發者,可拿自己的資料從頭訓練
- 研究生與學術團隊:需要便宜基準對象來上課或做論文比較的團隊,整套東西在一般硬體上就能跑
- 謎題與基準愛好者:想在自家機器重現 ARC-AGI 與數獨公布成績的玩家
任務
- 解限制型謎題:數獨或迷宮這類格線與搜尋問題,模型學的是規則,不是語言的描述
- 研究推理深度:比較遞迴模型靠增加運算能多拿多少分,對照更大的 Transformer
- 鑽研潛空間推理:測試模型能不能不寫出中間步驟就得到答案
- 對照 CoT 模型:並排實測,看思維鏈在符號任務上哪裡失手
- 重現公布結果:重新跑公開權重與訓練程式,核對論文寫的分數
情境
- GPU 預算不多的小實驗室:HRM 用約 1000 個樣本訓練單一任務,一張卡就能撐完整個實驗
- 比較架構想法:測試分層遞迴在同樣的謎題上,是否勝過規模相近的普通 Transformer
- 課堂上的推理模型單元:學生在一堂課裡跑完整套訓練與評估流程
- 早期研究衝刺:論文需要推理模型當基準,先快速跑出一個版本再放大
- ARC-AGI 實驗:觀察一個從頭訓練的迷你模型,在防記憶設計的基準上能走多遠
主要功能
受大腦啟發的分層架構
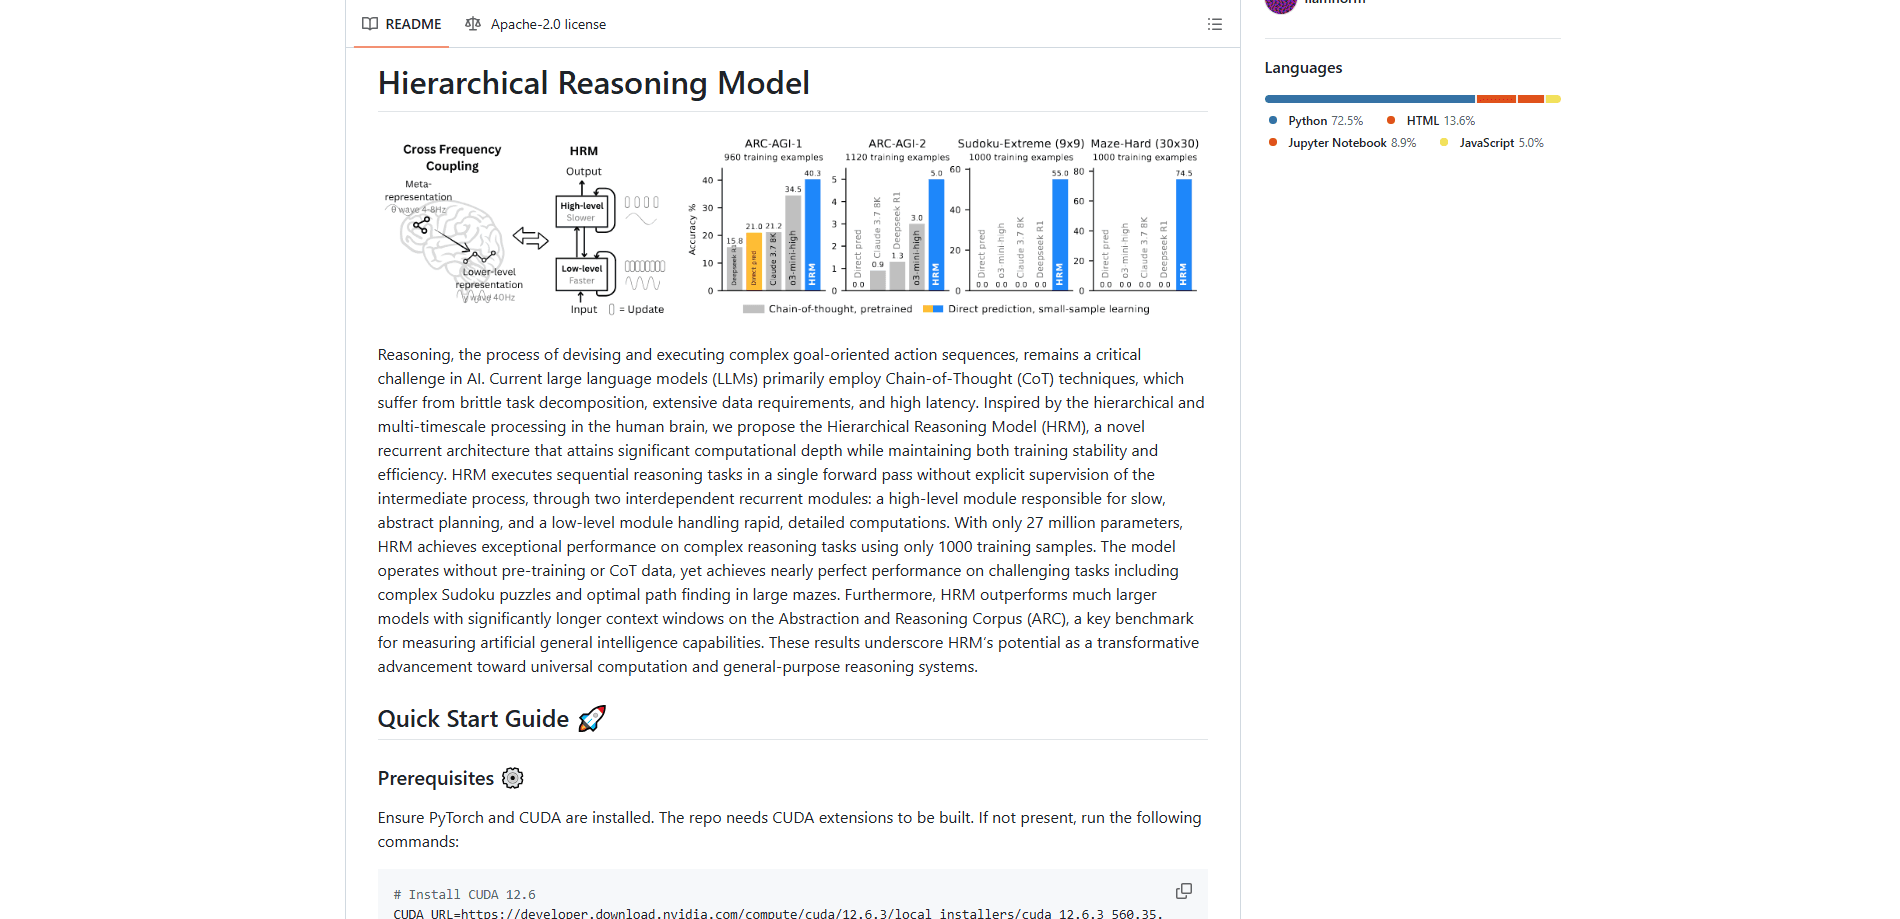
分層推理在這裡變得具體:這個 2700 萬參數模型身為遞迴推理模型,把工作拆給兩個互相耦合的遞迴模組。高階模組慢慢規劃、定出方向;低階模組快速運算、補上細節。這對應人腦皮質的多時間尺度處理,高階區域花更長時間整合資訊,低階區域即時反應。這樣的設計讓模型累積出真正的計算深度,不必堆疊數十層 Transformer。
單次前向傳遞、不用思維鏈
模型一次前向傳遞就得出答案,中間步驟沒有任何人監督。沒有思維鏈文字,也沒有逐步提示。論文的說法是,語言是溝通的工具,不是思考的載體,所以 HRM 在潛空間裡推理,只吐出最後結果。這砍掉了拖慢 CoT 模型的延遲與資料成本。
極端的參數與資料效率
這個 2700 萬參數的模型用約 1000 個樣本訓練,而且不需要任何標註的推理軌跡。它不靠預訓練,也不需要 CoT 資料,實驗室可以自己從頭練。根據 Sapient Intelligence,這樣的規模在極難數獨與大型迷宮尋路上仍拿到近乎滿分的成績,而思維鏈模型在這些任務上是零分。對研究用途來說,體積小正是最大賣點。
推論時的自適應運算
HRM 自己判斷一道題需要想多久。高階模組更新後,讓低階模組收斂,再重複這個循環,並由學到的停止訊號決定何時收手。簡單題目花少一點循環,難題花多一點,運算量隨難度伸縮,而不是固定跑幾步。這種推論時的動態擴充,讓迷你模型能在一道題上鑽得很深。
ARC-AGI 基準的亮眼成績
Abstraction and Reasoning Corpus(ARC-AGI)是為了測驗通用推理、而非背誦知識而設計的基準。根據作者,HRM 在 ARC-AGI-1 上擊敗了參數更大、上下文視窗更長的模型,包括 o3-mini-high 與 Claude 3.7,而且從隨機權重出發、完全不用思維鏈。ARC Prize 團隊後來在隱藏資料集上重測,重現的分數落在三十幾個百分點,對這麼小的模型依然很高,但低於論文原本的數字。
公開程式碼與可重現權重
Sapient Intelligence 在 GitHub 公開了程式碼與權重,任何人都能重跑實驗。儲存庫涵蓋訓練、評估、謎題資料集與 ARC 筆記本,幾週內就累積數千顆星與熱絡的討論。開放釋出在這裡格外重要,因為結果實在不尋常,其他研究者會想親自驗證。
朝通用模型延伸
同一套架構如今支撐著 HRM-Text,一個約 10 億參數的文字生成模型,Sapient 未做後訓練、也沒用 RLHF,直接從頭訓練。報導指出它的成績為 MATH 56.2、GSM8K 84.5、ARC-Challenge 81.9、DROP 82.2,在 16 張 H100 上訓練不到兩天。這是獨立於原版 HRM 的另一個釋出,但看得出架構要往哪裡走。
優缺點
優點
- 只靠約 2700 萬參數就能進行深度推理,一般硬體就能跑
- 用約 1000 個樣本從頭訓練,資料與運算成本都壓得很低
- 單次前向傳遞完成推理,沒有思維鏈文字,延遲更短
- 程式碼與權重公開,研究者能重現並檢視公布的結果
- 自適應運算讓模型在難題上多花循環,不必重新訓練
缺點
- 它是範圍狹窄的解題器,不是通用聊天機器人,每種新任務都得重新訓練一次
- ARC-AGI 的亮眼數字受到檢視,獨立重測的結果低於論文所報
- 公開材料幾乎都寫給研究受眾,非技術使用者難以入手
- 沒有託管的 API,也沒有現成 App,訓練與評估得自己架
常見問題
Hierarchical Reasoning Model(HRM)是 Sapient Intelligence 推出的類腦神經網路架構。它用兩個互相耦合的遞迴模組,一個負責緩慢抽象的規劃,一個負責快速細部的運算,在單次前向傳遞中就完成困難問題的推理,完全不需要思維鏈步驟。
相關內容
探索與 Hierarchical Reasoning Model 相關的工具、技能與文章。
Hierarchical Reasoning Model 替代方案

Claude for Google Workspace
Anthropic · 寫作 · 生產力 · 商業Claude for Google Workspace 把 Claude 側邊欄送進 Google 文件、試算表與簡報,讓它讀取你開啟中的檔案,直接在原地完成編輯。

KloudMate 2.0
KloudMate · 程式設計 · 商業KloudMate 2.0 是結合 AI 的可觀測性平台,把日誌、指標、追蹤與事件放在同一處,並由 KloudMate Assistant 調查告警、提出修正建議。
Cekura Bench
Cekura · 語音與語言 · 商業Cekura Bench 是公開的評測計畫,讓語音對語音模型與已上線的語音代理跑完 82 通模擬電話,每種情境各三次,再公布通過率、延遲與每分鐘成本。