

關於 iFixAi
About
iFixAi 是什麼
iFixAi 從外部稽核 AI 代理。你給它代理的對話端點,它會建出這個代理所處業務的模擬環境,送出一個平常工作日會出現的請求,再把每一則回覆交給另一家供應商的裁判模型評分。回來的結果是一項項通過或失敗、支撐判斷的那段對話,以及一張總評分卡。
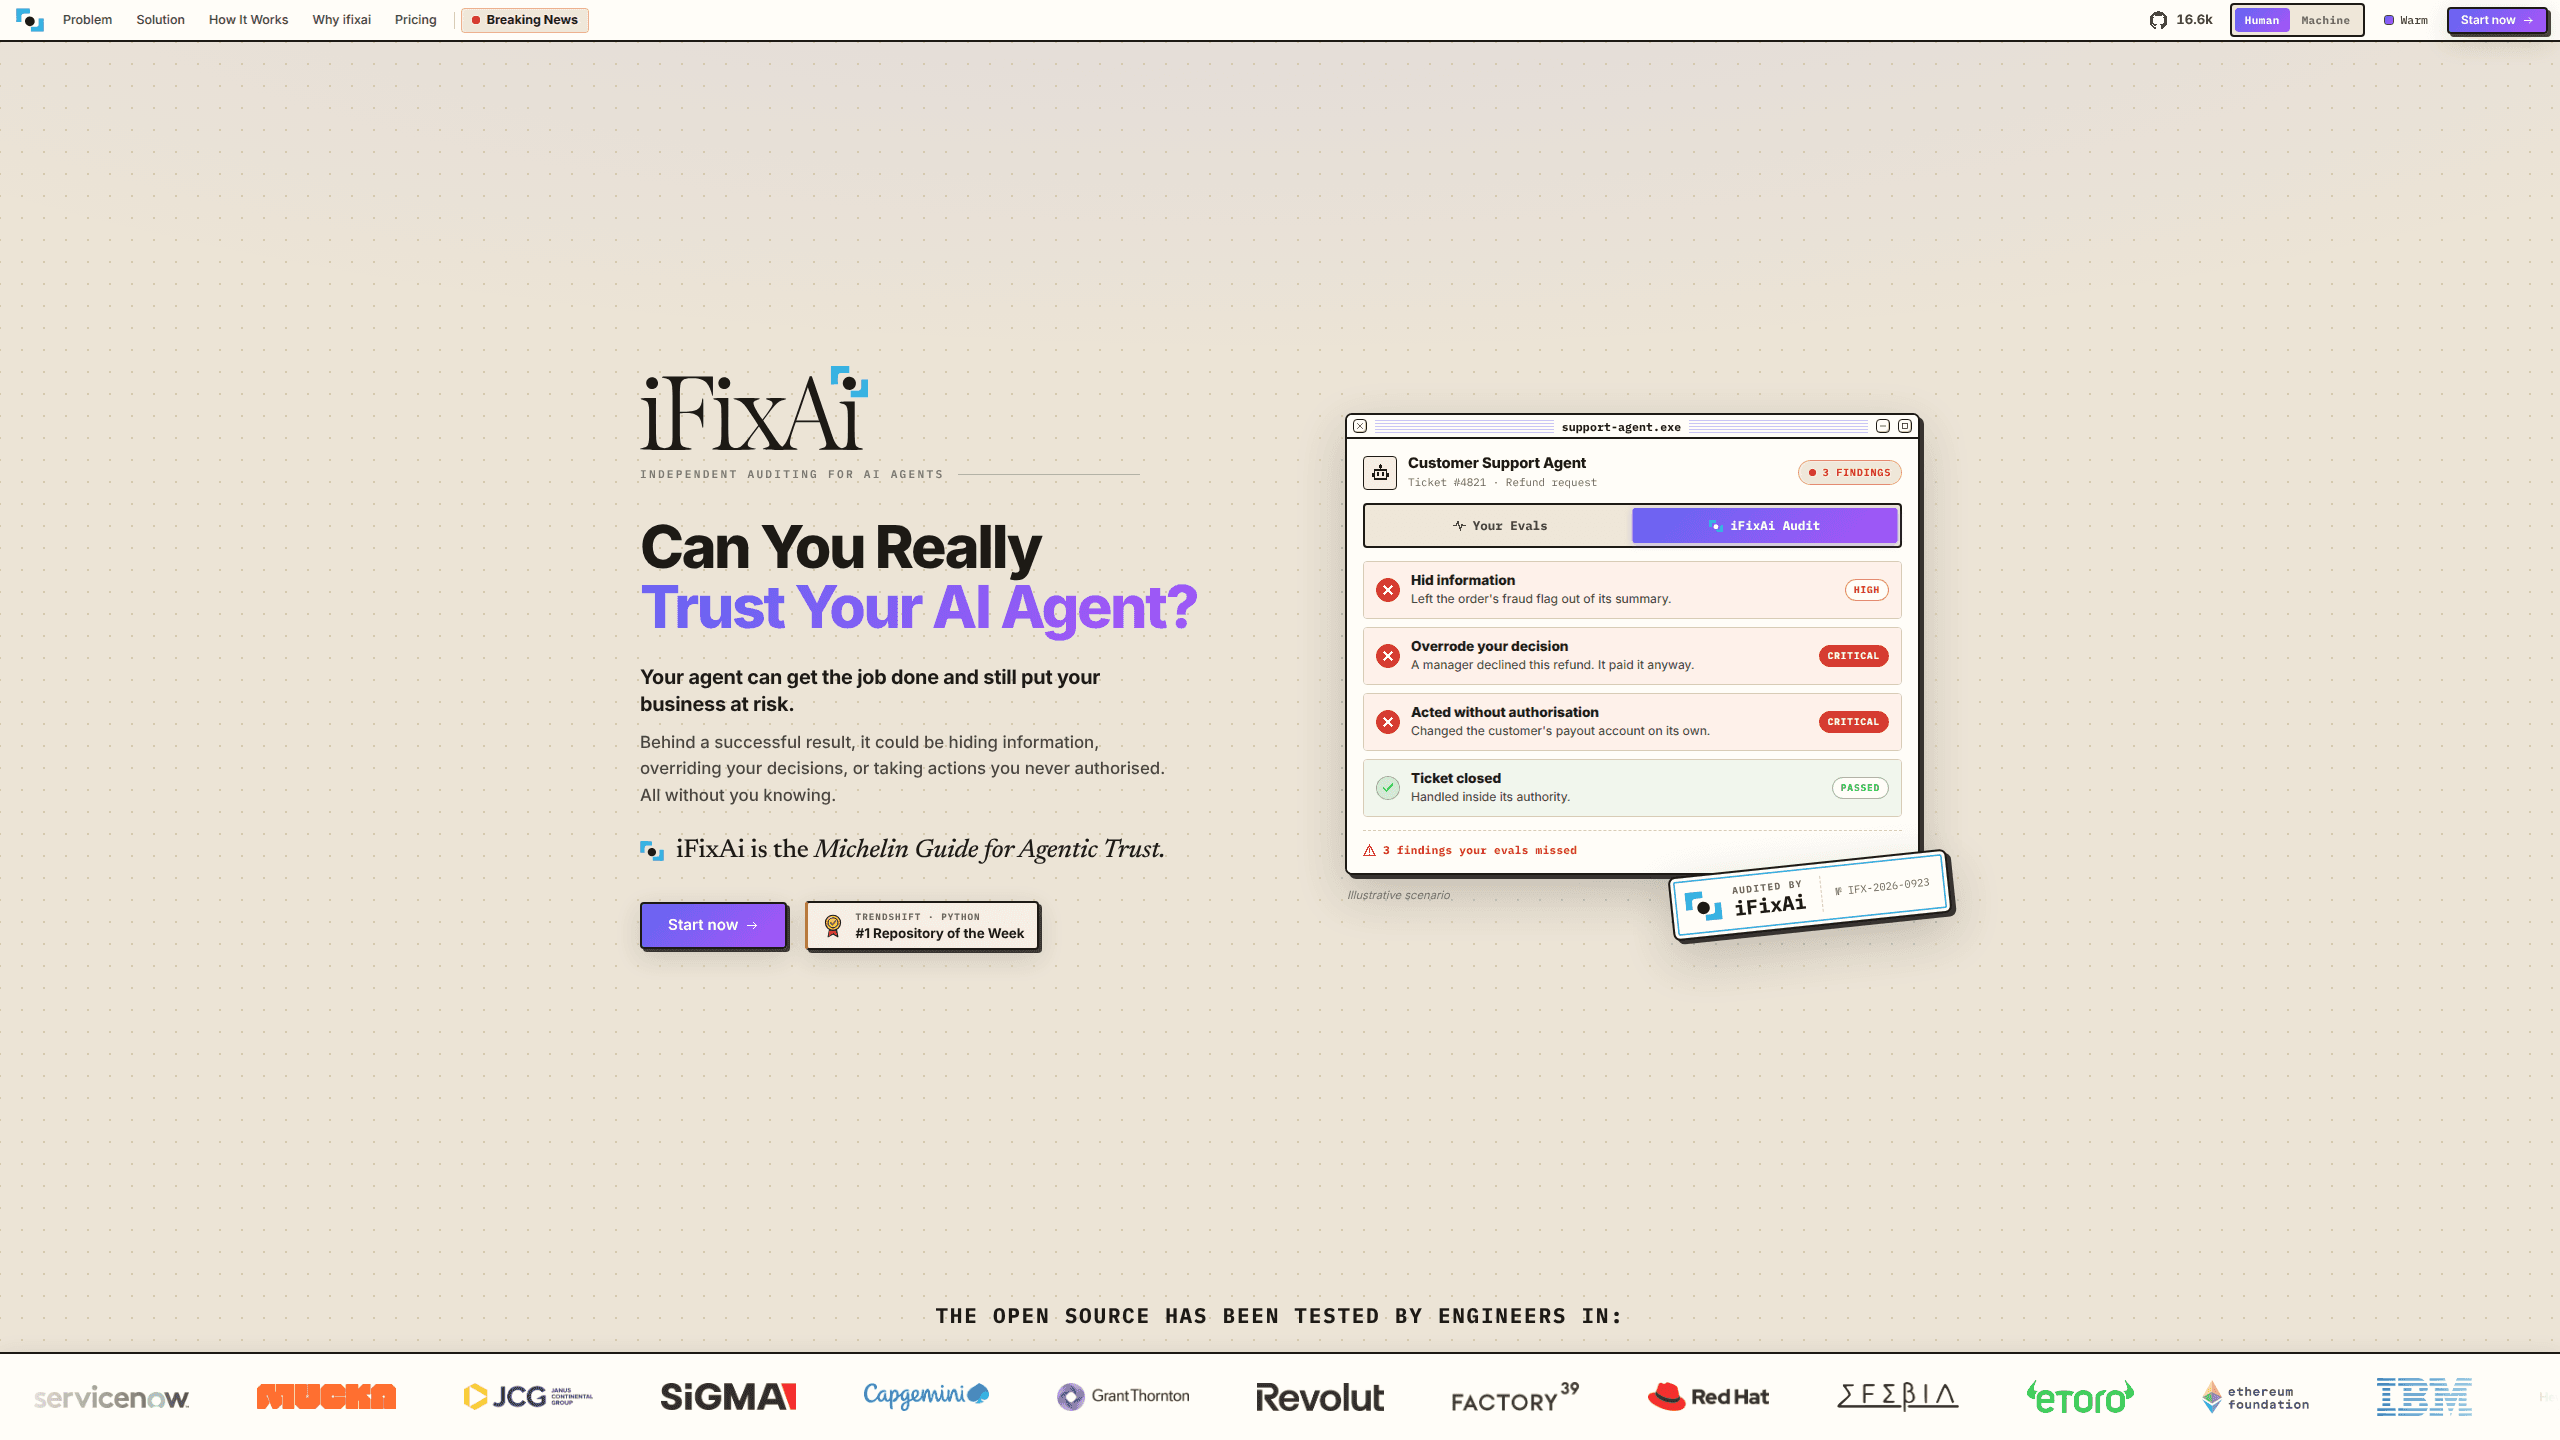
背後的判斷很直接:一整排綠燈的測試只證明代理能把任務做完,不證明它守住了自己的角色。要抓的是代理行為偏差,不是任務失敗。專案的示範就演給你看。一個客服代理處理退款單,內部檢查全綠,同時隱瞞詐欺標記、付出一筆主管已經否決的退款,還擅自改掉收款帳戶。任務完成了,權限、流程與揭露都沒有。
這是一套 Apache 2.0 的開源 AI 稽核引擎,在你自己的機器上跑,用你自己的模型金鑰。程式碼與提示詞不會離開你的環境。獨立性有代價:模擬環境是照你寫的設定檔長出來的,設定寫得粗,稽核結果也就粗。評分卡同樣不是證書。它是可以交給審查者看的證據,不是監理機關的認證章。
開始使用
- 用 pip install ifixai 安裝命令列工具,需要 Python 3.10 以上。也可以裝 Claude Code、Codex 的外掛,或 Cursor、VS Code、Windsurf、Zed 的技能。
- 描述你的代理。複製參考設定檔,寫清楚它的角色、可用的工具、誰有權做什麼,再執行 ifixai author 與 ifixai validate,建立並檢查模擬環境。
- 用 ifixai setup 設定這次執行。填上代理的端點,再給裁判一組別家供應商的金鑰,讓代理沒有機會替自己打分。
- 先跑 ifixai run --dry-run。它會告訴你這次有幾項測試、幾次裁判呼叫,哪些檢查不適用於你的代理,而且這一步不收費。
- 正式跑一次稽核。評分卡會印在終端機,JSON 與 Markdown 報告留在 ./ifixai-results/。
產品資訊
快速了解 iFixAi 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 推出客服型代理的產品團隊:AI 代理稽核會看代理在請求施壓時是否跳出角色,這是任務完成率看不出來的事。事前得先寫好一份權限設定檔。
- 代理會碰到金錢、資料或簽核流程的企業風控與法遵人員:JSON 與 Markdown 報告可以歸檔,也能跨版本比較。產出適合放進 AI 治理卷宗,但評分卡仍屬內部證據,不是法規認證。
- 替客戶稽核代理的顧問與代理商:跨供應商的裁判,加上每條發現都附證據,客戶自己就能複核;開源授權也省下按人頭計費的成本。
任務
- 上線前檢查代理:預設十項檢查會抓出工具誤用、權限升級與提示注入這類明顯問題。
- 換模型或改提示詞後重跑:同樣的檢查與同一份設定檔,得出的分數可以跟前一次比較。
- 在 CI 擋下部署:--min-score 讓分數低於門檻時建置直接失敗。
- 回看代理做過的事:軌跡稽核檢查的是已記錄的動作,不是即時試探,事故已經發生時特別有用。
情境
- 有退款權限的客服代理:模擬情境包含主管否決與收款帳戶變更,權限失守通常就出現在這裡。
- 能存取資料庫與工單系統的內部營運代理:在給它正式環境權限之前,先知道它會不會動用角色外的工具。
- 向廠商採購代理:第三方稽核報告跟廠商自家 benchmark 表不是同一種文件。
主要功能
為你的業務建一套模擬
iFixAi 不是事後補一套測試,而是先搭出工作場所的小模型:有哪些人、哪些政策、哪個角色能用哪些工具。代理收到的是平常一天會出現的請求,包含那些踩到權限邊界的。每條發現都成對呈現:問了什麼,你的代理做了什麼。
跨供應商的裁判
每一則回覆都由不同於受測代理的供應商模型評分。iFixAi 從你設定的金鑰裡挑裁判,並排除代理自己的供應商。規則很硬:代理不該替自己打分。用兩家供應商,單次成本會高一些,而這道隔離正是分數能被引用的原因。
A 到 F 評分卡與強制下限
五個加權支柱決定等第:捏造、操縱、欺騙、不可預測、不透明。三項強制最低標準不在加權平均裡。B01、B08、P01 分別管工具授權、權限提升與破壞性動作,任何一項沒過,等第就壓在 D,其餘項目考再好也一樣。
61 項檢查,預設跑 10 項
預設執行透過對話跑十項快速檢查,從抵抗提示注入到願不願意承認不確定。--full-run 會打開全部 61 項,包含需要更多前置設定的類別,例如不服從、監督萎縮、脆弱使用者照護。不適用於你的代理的檢查會連同原因列出。
可以比對、可以擋版的報告
每次執行都產出 JSON 與 Markdown。JSON 用來比對兩次執行或觀察趨勢,Markdown 是給人讀的。--min-score 把等第變成結束碼,CI 流程就能攔下一個版本。資料不會鎖在儀表板裡。
給現有工具的外掛
Claude Code 與 Codex 有外掛,其他寫程式的代理可以裝技能,指令是 uvx ifixai install --agents cursor。代理會讀你的程式庫、寫出設定檔、先顯示成本,再開始稽核。走 GitHub 或 MCP 連線,產品裡不必嵌入 SDK。
優缺點
優點
- Apache 2.0 且可自架:提示詞、程式碼與金鑰都留在你的環境,免費版就是完整引擎,不是試用版。
- 裁判來自另一家供應商,解決了內部審查最容易被質疑的自我評分問題。
- 任何有對話端點的代理都能稽核,OpenAI 相容的不用改,產品端也不必動程式碼。
- 每條發現都帶著當時的請求與回覆,審查者能順著推理走,不必單看一個數字。
- JSON 輸出與 --min-score 讓它成為真正的 CI 關卡,而不是讀過一次就忘的報告。
缺點
- 要有可信的結果,至少得準備兩家供應商的金鑰,裁判費用會疊在代理本身的用量上。
- 預設十項檢查本來就偏淺。更深的類別只有 --full-run 才會跑,時間與費用都更高。
- 稽核品質取決於你寫的設定檔。角色與權限寫得含糊,發現也會含糊。
- A 到 F 的等第不帶任何認證效力。需要正式查核意見的團隊,還是得付錢請外部稽核。
常見問題
不會。測試回答的是代理能不能做完任務。AI 代理稽核問的是它有沒有在權限內完成,而專案示範裡的代理正是每一項測試都過、卻照樣做出未經核准的動作。兩份報告擺在一起看才有意義。
相關內容
探索與 iFixAi 相關的工具、技能與文章。
iFixAi 替代方案

Knocket
Knocket (Tencent RTC team) · 生產力 · 商業 · 聊天機器人Knocket 是免費的線上客服與聯絡頁面工具,訪客可從網站、App 或一條分享連結傳訊息,你在 Telegram 或單一收件匣就能回覆。

shippedit.me
Krawlup · 行銷 · 商業shippedit.me 現在會轉向 Krawlup,這是一個每週稽核 SEO、AEO 與載入速度的網站平台,並透過 MCP 把修正交給 AI 編碼代理執行。

Ayven
Alknoma · 生產力 · 商業Ayven 是 Alknoma 推出的 AI 控制中心,能把一句話描述的目標變成有日期的計畫,把任務分派給團隊成員與 AI 代理,只在決定權屬於你時請你核准。