
Ollama
Ollama · 圖片 · 其他
Ollama 是一套本機 AI 執行環境,讓你在自己的電腦上跑大型語言模型。它會下載 Gemma 4、Qwen、gpt-oss 等開源模型,模型太大時也能改用雲端。
關於 Ollama
What Is Ollama
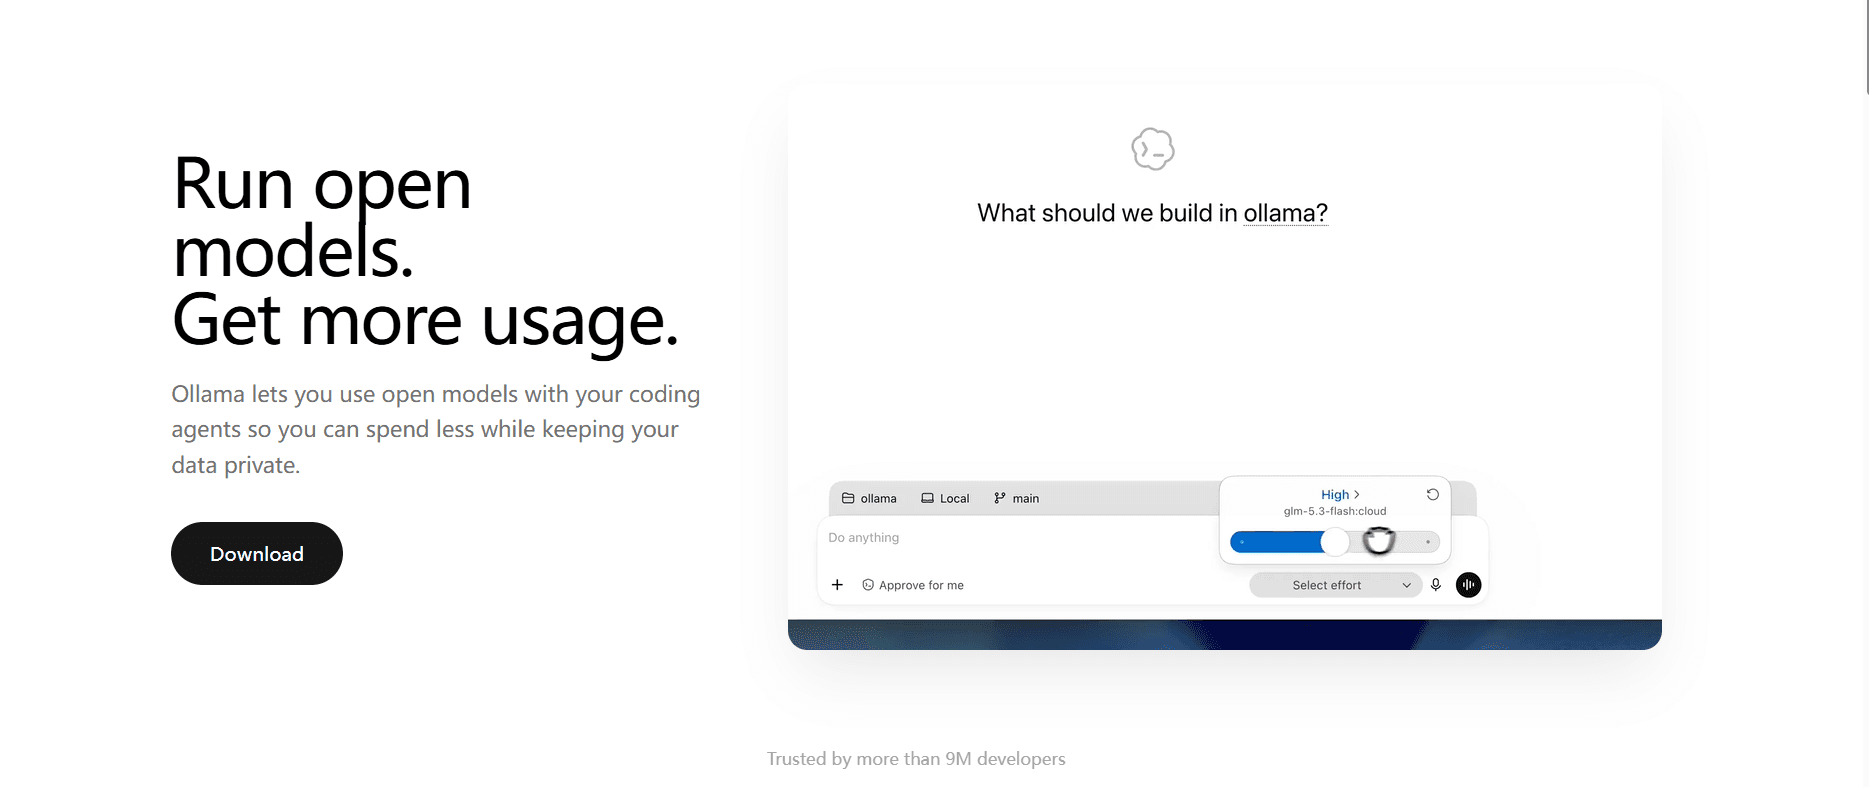
Ollama 是一套開源執行環境,把你的電腦變成大型語言模型的執行平台。你不必透過 API 租用模型,只要下載一次權重,之後就能離線對話。一行指令就會抓取模型並啟動,應用程式則處理麻煩的部分:量化格式、GPU 或 Apple Silicon 的記憶體調度、記憶體上限,以及負責回應請求的伺服器程序。
這個專案在 2023 年 7 月起步,成長很快,如今每月安裝量超過 900 萬次,模型下載量也突破 10 億次。2026 年,公司從 Benchmark、Y Combinator 等投資人募得 8,800 萬美元,並針對放不進筆電的模型新增了雲端方案。
雲端方案是最需要理解的取捨。在本機執行模型永遠免費且沒有限量,但上限取決於硬體:7B 模型在普通筆電上就能跑,200B 模型則需要真正配有 GPU 的機器。雲端模型移除了這道天花板,改以權杖計費,所以 Ollama 現在同時是免費的本機工具與用多少付多少的服務,端看你選哪一種模型。
Getting Started
- 下載 macOS、Windows 或 Linux 版的 Ollama,或使用官方 Docker 映像,然後開啟應用程式。
- 用
ollama pull gemma4:e2b抓取模型(下載約 7.2 GB),不想註冊帳號的話,設定時選 Local 即可。 - 執行
ollama run gemma4:e2b在終端機開始對話,或用ollama launch claude啟動程式開發代理。 - 要整合進自己的應用,就把請求送到本機 11434 埠的 REST API,或讓 OpenAI、Anthropic 用戶端指向 Ollama 的相容端點。
- 需要使用雲端模型時再登入並建立金鑰,把負擔較重的請求留在別人的硬體上。
產品資訊
快速了解 Ollama 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 想測試開源模型又不想付雲端費用的開發者:抓一個模型、透過本機 HTTP 伺服器呼叫,實驗成本就只剩電費。
- 在意隱私、常處理敏感文字的使用者:請求和回應都留在你的機器上,Ollama 也表明這些資料不會被記錄或用於訓練。
- 要部署程式開發代理的團隊:`ollama launch` 能把 Claude Code、Codex、OpenCode 等代理接到本機或雲端模型。
- 想比較各家模型的開發者:用一行下載指令就能在 Gemma、Qwen、gpt-oss、DeepSeek、Kimi 之間切換。
任務
- 離線執行對話模型:桌面應用與終端機都能和下載好的權重對話,抓取完成後就不再需要網路。
- 把 AI 功能做進應用程式:REST API 與官方 Python、JavaScript 函式庫提供對話、嵌入與結構化輸出。
- 用 Modelfile 調整對話行為:系統提示、溫度與參數設定一次,之後把定義分享給整個團隊。
- 接上代理與編輯器:整合範圍涵蓋 Claude Code、Codex、Copilot CLI、Cline、Continue、Zed 與 Obsidian。
- 從模型取得結構化資料:傳入 JSON 結構描述與 format 參數,就能拿回有型別的物件,而不是自由文字。
情境
- 飛機上的筆電:已下載的 7B 模型在完全沒有網路時依然能回答問題。
- 資料規範嚴格的公司:自架 AI 讓模型留在辦公室網路內,請求永遠不會離開這棟大樓。
- 在簽下雲端帳單前的快速原型:本機模型先驗證想法,流量進來後再由雲端模型接手擴充。
- 用本機代理寫程式:Claude Code 指向 Ollama,直接對專案動手,不必把程式碼送到第三方。
主要功能
一行指令跑本機模型
核心承諾就是一行:ollama pull 抓權重,ollama run 開對話。Ollama 在背後處理量化、記憶體調度與模型伺服器,讓你省去 CUDA 版本與 Python 環境的來回折腾。模型來自內建資料庫,涵蓋 Gemma、Qwen、gpt-oss、DeepSeek、Kimi、MiniMax、GLM、Mistral 與 Nemotron。
以權杖計價的雲端模型
並非每個模型都塞得進筆電,所以 Ollama 新增雲端方案,在 NVIDIA 雲端供應商的硬體上執行較大的開源模型。費用按每百萬權杖計算,平日非尖峰時段的費率大約只要一半。免費帳號會拿到起始額度,付費方案則內含每月額度。
REST API 與 OpenAI 相容
每個本機模型都提供 11434 埠的 HTTP 伺服器,任何程式語言都能呼叫。Ollama 同時支援 OpenAI 的 Chat Completions、Responses 格式與 Anthropic 的 Messages 格式,也就是說為這些 API 打造的工具只要改一下基底網址就能用,通常不必動到程式碼。
Apple Silicon 上的 MLX 引擎
在 Mac 上,Ollama 讓支援的模型走 Apple 的 MLX 框架,而不是經過轉譯的執行環境。這項改變在 2026 年帶來明顯的速度提升,其中包括多權杖預測,官方測得在程式開發代理上最多快 90%。記憶體用量也下降,這對採統一記憶體的 Mac 特別重要,因為記憶體正是它的硬限制。
代理與桌面整合
ollama launch claude、ollama launch codex 等指令能把程式開發代理接到你的模型上。桌面端方面,Claude 與 ChatGPT(Desktop)都能指向 Ollama,讓 Muse Glimmer、Nemotron 這類模型出現在你原本就在用的工具裡。
Modelfile 與自訂模型
Modelfile 是一份簡短的配方,用來定義自訂模型:基礎權重、系統提示、參數與範本。用 ollama create 建好之後,定義會跟著模型走,團隊共用的指示因此能保持一致,而不是散落在各处的筆記裡。
嵌入與結構化輸出
Ollama 能執行 EmbeddingGemma 這類嵌入模型,輸出可用於搜尋或分群的向量。format 參數接受 JSON 結構描述,讓模型直接以有型別的物件回答,把自由文字變成程式能直接讀取、不必猜格式的資料。
決策模型
較新的版本加入決策模型,回傳的是選項、分數與機率,而不是文章。它們採用 TypeSafe 的 Jev API,適合處理工單分流、內容分類這類工作,Ollama 會在專屬端點執行,與一般對話模型並行。
優缺點
優點
- 本機模型免費且無限量,不需要帳號、金鑰或網路連線。
- 安裝只要一行指令,內建模型庫讓你省下環境設定的功夫。
- REST API 與相容 OpenAI、Anthropic 的端點,讓現有用戶端改個網址就能轉過來。
- 透過 MLX 支援 Apple Silicon,為 Mac 使用者帶來大幅速度提升。
- 雲端模型讓你不用擁有 GPU 也能執行大型開源模型。
缺點
- 本機效能受硬體限制,大模型需要足夠的顯示記憶體,筆電跑起來會吃力。
- 雲端價格隨模型與時段變動,月費較難事先估算。
- 部分進階雲端功能,例如同時執行多個模型,在免費方案會受並行上限限制。
- 模型庫雖然廣,仍比 Hugging Face 或大型雲端供應商的完整陣容小。
常見問題
Ollama 是一套執行環境,讓你在自己的電腦或雲端跑開源的大型語言模型。它負責下載模型、啟動本機伺服器,並提供命令列、桌面應用與 API 讓你操作。
相關內容
探索與 Ollama 相關的工具、技能與文章。
Ollama 替代方案

Google EmbeddingGemma 2
Google DeepMind · 寫作 · 圖片 · 程式設計Google EmbeddingGemma 2 是 7.4 億參數的開源模型,能把文字、程式碼、圖片、音訊與影片畫面轉成同一個 768 維空間裡的向量,在手機與筆電上就能執行。

Tractionwave
TractionWave · 圖片 · 行銷TractionWave 是針對靜態廣告的 AI 注意力熱圖工具。上傳 PNG 或 JPG,就能取得預測注意力、排序後的熱點與修正建議,不必等預算花完才知道問題在哪。

Imejis.io
Imejis.io · 圖片 · 行銷Imejis.io 是給代理與行銷團隊使用的 AI 設計工作室。你用日常說法描述一張圖,它會寫好文案、排出版面、自動調整成各種尺寸,最後匯出完成檔。