
Aeneas
Google DeepMind, with the University of Nottingham, Warwick and Oxford · Sonstiges
Aeneas ist das Open-Source-KI-Modell von DeepMind, das beschädigte lateinische Inschriften wiederherstellt und Datierung, Herkunft und nächste Textparallelen vorhersagt.
Über Aeneas
What Is Aeneas
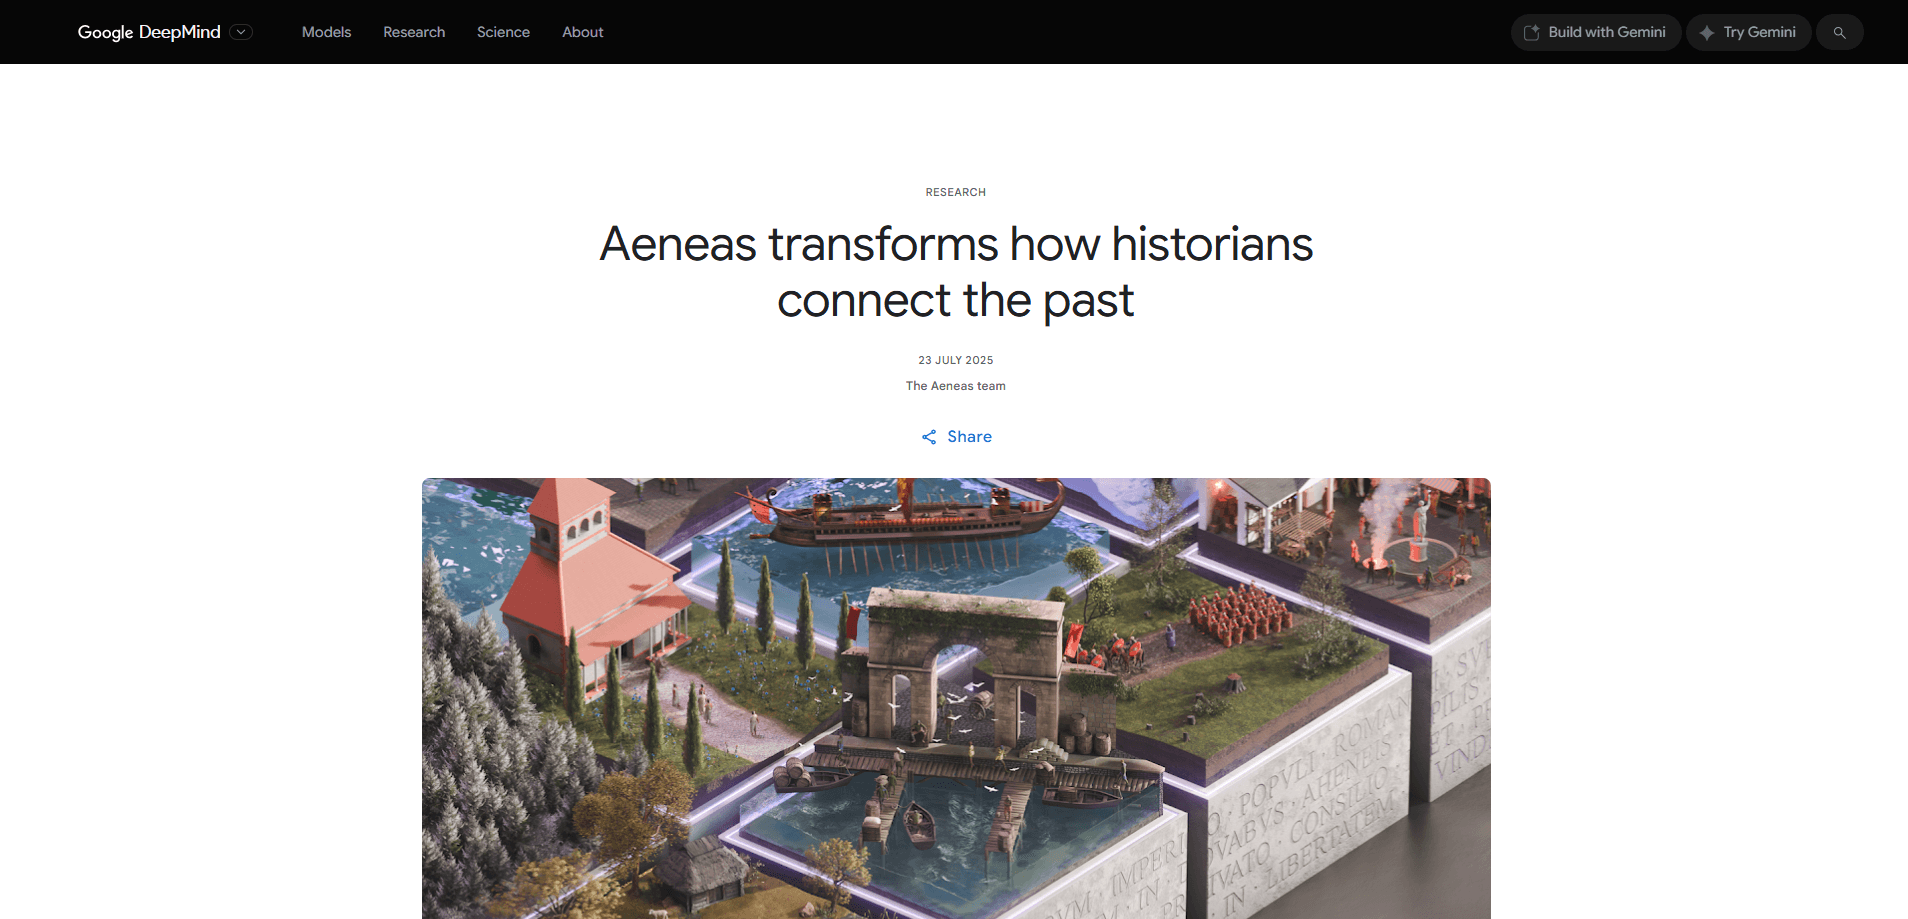
Aeneas ist ein generatives neuronales Netz, das Google DeepMind mit Historikern der Universitäten Nottingham, Warwick und Oxford entwickelt hat. Es liest antike Texte, vor allem lateinische Inschriften auf Stein, Bronze und Keramik, und hilft Forschern, sie in einen weiteren historischen Zusammenhang zu stellen. Das Team veröffentlichte die Arbeit im Juli 2025 in Nature und gab Code und Datensatz als Open Source frei.
Die Aufgabe ist zum großen Teil Suchen und Reparieren. Taucht eine beschädigte oder verwitterte Inschrift auf, wühlt sich der Historiker sonst durch Nachschlagewerke auf der Suche nach Parallelen, also Texten mit ähnlicher Formulierung, Formel oder Herkunft. Diese Suche dauert Tage und hängt davon ab, welche Bibliotheken ein Forscher erreicht. Aeneas automatisiert sie: Das Modell macht aus jedem Text einen historischen Fingerabdruck und zieht die relevantesten Parallelen aus einem Korpus von über 176.000 lateinischen Inschriften. Praktisch steckt damit ein großer Teil der Epigraphik in einem Modell, das man abfragen kann.
Zwei Grenzen bestimmen den Einsatz. Aeneas ist auf Latein trainiert, die veröffentlichten Werte gelten also für diese Sprache. Das Team betont, dass sich das Verfahren auf andere Sprachen, Schriften und Träger übertragen lässt. Und es ist ein Forschungsinstrument, kein fertiges Produkt. Sie führen es über Code, eine Demo-Seite oder ein Notebook aus, brauchen also etwas Übung mit Python oder die Geduld, einer Installationsanleitung zu folgen.
Getting Started
- Öffnen Sie die interaktive Demo auf predictingthepast.com oder besuchen Sie die Projektseite von Google DeepMind für Paper und Links
- Klonen Sie das Repository predictingthepast auf GitHub und folgen Sie den Anweisungen für Modell und Datensatz
- Geben Sie eine Zeichenfolge mit Markierungen für Lücken bekannter und unbekannter Länge ein, dazu ein Bild der Inschrift, falls vorhanden
- Prüfen Sie den wiederhergestellten Text, die nach Relevanz sortierten Parallelen und die Datierungs- und Herkunftsprognosen und behalten Sie, was der Kontrolle standhält
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Aeneas.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Klassische Philologen und Althistoriker
- Archäologen und Museumsmitarbeiter
- Forscher der Digital Humanities
- Studierende und Lehrende
Aufgaben
- Textwiederherstellung
- Geografische Zuordnung
- Chronologische Zuordnung
- Parallelensuche
- Korpusstudie
Szenarien
- Ein verwittertes Altarfragment kommt ohne Fundort
- Ein Museum bereitet eine Ausstellung vor
- Ein Aufsatz braucht eine festere Chronologie
- Ein fächerübergreifendes Team untersucht eine wenig bekannte Schrift
Wichtigste Funktionen
Textwiederherstellung beliebiger Länge
Aeneas ergänzt fehlende Zeichen und Lücken, deren Länge niemand kennt, ein Schritt über frühere Modelle hinaus, die nur Lücken fester Länge lösten. Laut Team findet es Inschriften mit bis zu zehn fehlenden Zeichen mit rund 73 Prozent Genauigkeit wieder. Bei einem beschädigten Text kann das ein unlesbares Fragment in eine brauchbare Quelle verwandeln.
Suche nach parallelen Texten
Das Modell wandelt jede Inschrift in einen historischen Fingerabdruck um und durchsucht einen Korpus von über 176.000 lateinischen Inschriften nach den nächsten Treffern. Diese Parallelen teilen Formulierung, Funktion oder kulturellen Umfeld, weit über die wörtlichen Treffer älterer Werkzeuge hinaus. Es ist die Funktion, die Historiker am meisten nutzen, weil der Kontext einem Fragment erst Bedeutung gibt.
Multimodale geografische Zuordnung
Aeneas ist das erste Modell seiner Art, das Text und Bild verbindet, um zu erraten, wo eine Inschrift entstand. Ein schlankes visuelles Netz liest neben dem Text ein Graustufenbild, was vor allem die geografische Aufgabe genauer macht. Laut Team ordnet es Texte mit rund 72 Prozent Genauigkeit einer von 62 römischen Provinzen zu.
Chronologische Zuordnung
Mit einem vom Historiker vorgegebenen Zeitfenster engt Aeneas das wahrscheinliche Datum auf etwa 13 Jahre ein. Das zählt, weil die Radiokarbondatierung bei Stein und Metall nicht funktioniert, sodass Forscher oft nach Stil und Formel datieren. Ein engeres Fenster erleichtert es, einen Text mit Ereignissen und weiteren Funden abzugleichen.
Ein großer offener lateinischer Korpus
Trainiert wird das Modell mit dem Latin Epigraphic Dataset, das über 176.000 Inschriften und rund 16 Millionen Zeichen aus Quellen wie der Epigraphic Database Roma und der Epigraphic Database Heidelberg bündelt. DeepMind hat Datensatz und Code veröffentlicht, sodass Teams das Modell untersuchen, prüfen oder mit eigenem Material neu trainieren können.
Zusammenarbeit von Mensch und Maschine
Das Team testete Aeneas mit 23 Historikern an echten Inschriften vom 7. Jahrhundert v. Chr. bis zum 8. Jahrhundert n. Chr. Die Historiker hielten die Kontexthinweise in rund 90 Prozent der Fälle für nützlich und meldeten 44 Prozent mehr Sicherheit bei zentralen Aufgaben. Bei Wiederherstellung und geografischer Zuordnung übertrafen Menschen mit dem Modell sowohl das Modell als auch die Historiker allein.
Vor- und Nachteile
Vorteile
- Offenes Modell und offener Datensatz, sodass Forscher es prüfen, neu trainieren und erweitern können
- Löst Lücken unbekannter Länge, was ältere Wiederherstellungswerkzeuge nicht konnten
- Nutzt neben dem Text auch Bilder der Inschriften, als erstes Modell bei der geografischen Zuordnung
- Gestützt auf ein begutachtetes Nature-Paper und eine Studie mit aktiven Historikern
- Kostenlos über die Demo, den Code oder ein Colab-Notebook
Nachteile
- Auf Latein trainiert, die veröffentlichte Genauigkeit gilt also für diese Sprache, der Rest ist ein Forschungsversprechen
- Es ist ein Forschungsinstrument, kein Produkt, der Aufbau verlangt also etwas Erfahrung mit Python
- Es schlägt Parallelen und Daten vor, beweist aber keine Lesung, der Historiker muss das Ergebnis weiter beurteilen
- Keine öffentliche API und keine Preise, weil das Projekt als Code und nicht als Dienst erscheint
Häufige Fragen
Aeneas ist ein Open-Source-KI-Modell von Google DeepMind, das Historikern die Arbeit mit antiken Texten erleichtert, vor allem mit lateinischen Inschriften. Es stellt beschädigten Text wieder her, schlägt Datum und Herkunftsort vor und findet die Inschriften, die der untersuchten am ähnlichsten sind. Das Team veröffentlichte es im Juli 2025 in Nature.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Aeneas.
Alternativen zu Aeneas

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.

iFixAi
iFixAi · Business · SonstigesiFixAi ist ein Open-Source-Auditor für KI-Agenten. Er schickt den Agenten durch eine Simulation Ihres Geschäfts, bewertet jede Antwort und liefert eine Bewertung von A bis F mit Belegen.