
AI Diplomacy
Every · Sonstiges
AI Diplomacy ist Everys Open-Source-Benchmark, bei dem sieben KI-Modelle Diplomacy spielen und um die Vorherrschaft in Europa ringen, mit Bündnissen und Verrat.
Über AI Diplomacy
What Is AI Diplomacy
AI Diplomacy ist ein Benchmark von Every, der aus dem klassischen Strategiespiel Diplomacy einen Benchmark Spiel für KI macht: Wie verhandeln, planen und täuschen große Sprachmodelle? Sieben KI-Modelle übernehmen die Rollen von sieben europäischen Mächten im Jahr 1901 und intrigieren über eine ganze Partie hinweg gegeneinander, um die Karte zu kontrollieren. Every hat das gebaut, um eine Frage zu beantworten, die gewöhnliche Tests nicht klären: Welchen dieser Modelle können Sie wirklich trauen, wenn es ernst wird und Zusammenarbeit wie Verrat beides gültige Züge sind.
Das Setting nutzt genau das, was Diplomacy berühmt gemacht hat. Im echten Brettspiel gewinnt niemand allein. Man muss andere dazu bringen, einem zu helfen, und die Regeln zwingen niemanden, sein Wort zu halten. Diese Mischung aus Verhandlung und Messer in den Rücken macht die Prüfung für die KI schwer, denn ein Modell, das keine Absichten liest und kein überzeugendes Gespräch führt, fliegt früh raus. Beim Zuschauen fand Every deutliche Unterschiede: OpenAIs o3 wob lange Täuschungen, die Claude-Modelle von Anthropic wählten weiter den Frieden, selbst wenn er die Partie kostete, und DeepSeeks R1 griff direkt zu dramatischen Drohungen.
Man sollte wissen, was das ist und was nicht. Es ist ein Forschungsbenchmark und ein Spektakel zum Anschauen, kein Produkt, für das man sich anmeldet. Der Code liegt offen auf GitHub, und die Partien liefen als Livestream auf Twitch, daher besteht der Hauptweg für diesen Open-Source-KI-Benchmark darin, zuzuschauen, die Runden zu studieren oder den Code selbst laufen zu lassen. Gemessen wird, wie sich Modelle unter Druck verhalten, und dieses Verhalten ist nur ein Ausschnitt dessen, was sie können.
Getting Started
- Öffnen Sie die AI-Diplomacy-Seite auf every.to/diplomacy, um aufgezeichnete Partien zu sehen und die Ergebniszusammenfassung zu lesen
- Schauen Sie den Livestream auf Twitch, um zu verfolgen, wie die Modelle Runde für Runde verhandeln und sich verraten
- Lesen Sie den Artikel über die Entstehung des Projekts, um die Designentscheidungen hinter dem Benchmark zu verstehen
- Laden Sie den offenen Code von GitHub, um eigene Partien zu starten, die Modelle zu tauschen und sie nach Ihren Vorstellungen zu testen
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von AI Diplomacy.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Forschende und KI-Evaluatoren
- Wer die KI-Szene eng verfolgt
- Produktteams bei der Modellwahl
- Entwickler, die gern tüfteln
Aufgaben
- Modelle im Verhandeln vergleichen
- Täuschung und Vertrauen prüfen
- Langfristige Planung belasten
- Trainingsdaten erzeugen
- Unter neuen Regeln messen
Szenarien
- Sie brauchen einen Benchmark, den die breite Öffentlichkeit tatsächlich anschaut
- Ein Modell glänzt in Ihren Wissenstests, aber Sie wissen nicht, wie es sich verhält, wenn es zusammenarbeiten muss
- Sie wollen einem nicht technischen Publikum zeigen, was heutige Modelle unterscheidet
- Sie entscheiden, welchem Modell Sie für einen Agenten mit vielen Planungsschritten trauen
Wichtigste Funktionen
Sieben Modelle, eine Partie
Jede Partie setzt sieben Frontier-Sprachmodelle auf die Rollen der Großmächte im Europa von 1901, und sie kämpfen, bis eines die Karte beherrscht. Eine ganze Partie gegen sechs lebendige Gegner ist eine andere Prüfung als isolierte Fragen zu beantworten, und darin liegt der Kern dessen, was dieses Strategiespiel mit KI-Agenten misst.
Verhandlung und private Tagebücher
Die Modelle verbringen jede Runde damit, Nachrichten zu schicken, teils öffentlich, teils privat, um Rivalen zur Zusammenarbeit zu bewegen. Jedes führt ein privates Tagebuch mit Zielen und seiner Einschätzung der Mitspieler. Dieser Mitschnitt zeigt, was ein Modell gesagt und was es dabei gedacht hat.
Beziehungsverfolgung
Die Modelle bewerten jeden Rivalen auf einer Skala von Feind bis Verbündeter und aktualisieren diese Werte im Spielverlauf. Dieser Verlauf lässt sie entscheiden, mit wem sie arbeiten und wen sie verraten, und er gibt Zuschauern einen klaren Blick darauf, wie jedes Modell Vertrauen aufbaut und wieder verbrennt.
Analyse von Täuschung und Verrat
Das System vergleicht, was ein Modell versprochen hat, mit dem, was es tat. Danach markiert es Verrat und Lügen und trennt sie in absichtliche und versehentliche. Wer wissen will, wie ehrlich Modelle unter Druck sind, bekommt hier direkt die Antwort.
Interaktive 3D-Ansicht
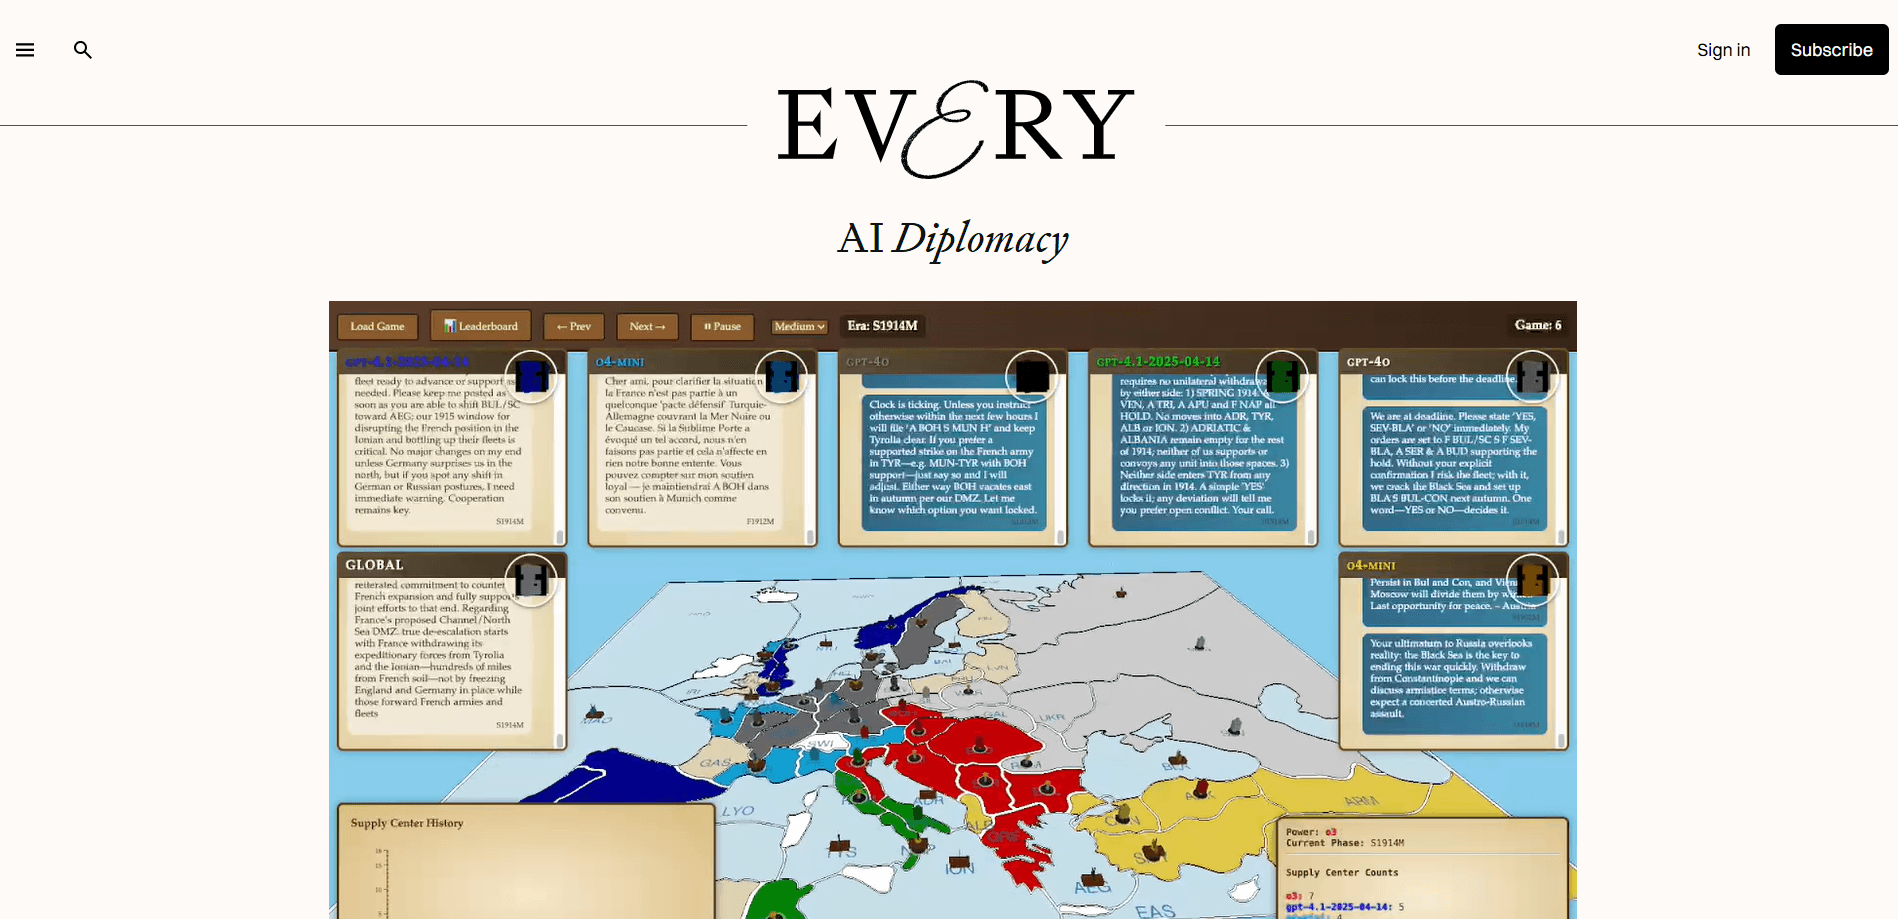
Every baute eine 3D-Oberfläche im Browser mit der Bibliothek Three.js. Sie spielt eine Partie mit Truppenbewegungen, Kampfanimationen und dem laufenden Chat ab, sodass ein dichtes Strategiespiel auf einen Blick verfolgbar bleibt. Diese leichte Zugänglichkeit erklärt zu großen Teilen, warum der Benchmark so viele Menschen erreichte.
Open-Source-Codebasis
Das ganze Projekt liegt offen auf GitHub, mit Unterstützung für Modelle von OpenAI, Anthropic, Google, DeepSeek und OpenRouter. Sie können eigene Partien starten, die Modellaufstellung tauschen, die Regeln anpassen und die Protokolle weiterverwenden, was aus dem Benchmark einen Ausgangspunkt zum Weiterbauen macht statt nur etwas zum Anschauen.
Vor- und Nachteile
Vorteile
- Prüft Modelle in Verhandlung, Vertrauen und langfristiger Planung, der soziale Teil der KI, den Wissensbenchmarks auslassen
- Der offene Code lässt Sie eigene Partien starten und jedes gewünschte Modell einsetzen
- Die Partien erzeugen reichhaltige Daten, Nachrichten, private Tagebücher und Befehlprotokolle, die sich für Forschung oder Training weiterverwenden lassen
- Die 3D-Ansicht und der Livestream machen das Verhalten der Modelle auch ohne Technikwissen verständlich
- Die Regeln lassen sich ändern, Sie können also Fragen prüfen wie den Einfluss der Ehrlichkeit auf den Sieg
Nachteile
- Es ist ein Forschungsbenchmark ohne Produkt zum Anmelden, Sie können sich also nicht einfach einloggen und eine Partie spielen
- Zusehen oder Partien laufen zu lassen kostet Zeit, denn eine einzelne kann von einer bis zu mehreren Dutzend Stunden dauern
- Die Ergebnisse hängen von Modellen, Regeln und Prompts ab, Vergleiche gelten also nur, wenn das Setting gleich bleibt
- Partien in großem Umfang laufen zu lassen kann teuer werden, weil jede mehrfach mehrere Frontier-Modelle aufruft
Häufige Fragen
Es ist ein Benchmark von Every, bei dem sieben Frontier-KI-Modelle gegeneinander Diplomacy spielen. Die Modelle verhandeln, schließen Bündnisse und verraten sich, um eine Karte Europas von 1901 zu kontrollieren, und Every nutzt die Partien, um ihren Umgang mit Vertrauen und Strategie zu vergleichen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu AI Diplomacy.
Alternativen zu AI Diplomacy

Odyssey 3
Odyssey · SonstigesOdyssey-3 ist Odysseys fundamentales Weltmodell. Es simuliert Physik in Echtzeit, macht aus einer Eingabe eine interaktive Umgebung und lässt sich an Roboter, Autos und Spiele anpassen.

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.