

Confident AI
Confident AI · Sonstiges
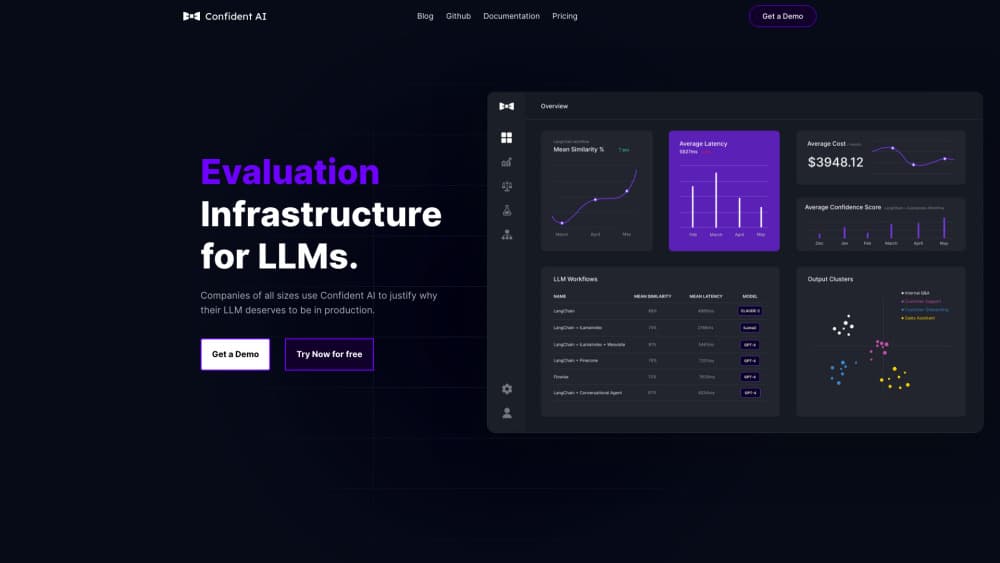
Confident AI ist eine LLM-Evaluierungsplattform auf Basis des Open-Source-Frameworks DeepEval. Teams prüfen damit KI-Anwendungen vor dem Start, bewerten Antworten mit forschungsgestützten Metriken und beobachten danach den echten Traffic.
Über Confident AI
About
Was ist Confident AI
Confident AI ist eine Webplattform zum Testen und Überwachen von Anwendungen auf Basis großer Sprachmodelle. Sie löst den Punkt, an dem viele Teams hängen bleiben: den Nachweis, dass ein Chatbot, eine RAG-Pipeline oder ein Agent nach einer Prompt-Änderung oder einem Modellwechsel noch funktioniert. Sie schreiben Testfälle in Python oder im Browser, lassen sie gegen Ihre Anwendung laufen und erhalten pro Metrik eine Punktzahl mit schriftlicher Begründung.
Das Unternehmen pflegt außerdem DeepEval, das Open-Source-Framework, aus dem die Metriken der Plattform stammen. Das ist praktisch relevant. Sie können dieselben Prüfungen lokal mit DeepEval ausführen und die Ergebnisse zu Confident AI hochladen, damit das Team sie gemeinsam ansieht. Nichts bleibt in der Blackbox eines Anbieters eingeschlossen.
Die härteste Grenze ist der Preis. Kostenlos sind ein Projekt, zwei Nutzer und fünf Testläufe pro Woche. Der ernsthafte Einsatz beginnt beim Starter-Plan für 200 Dollar im Monat. Wer nur gelegentlich prüft, wird diese Rechnung schwer rechtfertigen.
Erste Schritte
- Legen Sie ein kostenloses Konto auf confident-ai.com an und kopieren Sie den API-Schlüssel aus den Projekteinstellungen.
- Installieren Sie das SDK mit
pip install -U deepevalund führen Siedeepeval loginaus, um das lokale Framework mit dem Cloud-Projekt zu verbinden. - Definieren Sie Metriken und Testfälle in einer Python-Datei oder erstellen Sie sie im Browser über den No-Code-Ablauf, sofern Sie einen bezahlten Plan nutzen.
- Starten Sie die Tests, lesen Sie die Punktzahlen pro Metrik im Dashboard und teilen Sie den Berichtslink mit Ihrem Team.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Confident AI.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Engineers, die RAG-Pipelines oder Agenten bauen
- Product Manager mit Verantwortung für KI-Funktionen
- QA-Teams, die in LLM-Tests einsteigen
Aufgaben
- Halluzinationen vor dem Release finden
- Zwei Modell- oder Prompt-Konfigurationen vergleichen
- Produktionsfehler in Testfälle verwandeln
- Einen Kundenchatbot per Red Teaming prüfen
Szenarien
- Ein Startup, das jede Woche das Modell wechselt
- Ein Unternehmen, das Bewertungsmaßstäbe über mehrere Produktteams vereinheitlicht
- Ein Support-Bot, der bereits live läuft
Wichtigste Funktionen
Metrikbibliothek mit Forschungshintergrund
Die Plattform bringt über 50 KI-Evaluierungsmetriken auf Basis von DeepEval mit, für einzelne Antworten und für ganze Gespräche. Enthalten sind Answer Relevancy, Faithfulness, Contextual Precision und Recall, Halluzination, Bias, Toxicity sowie agentenspezifische Prüfungen wie Tool Correctness. Passt keine Standardmetrik, beschreiben Sie mit eigenen G-Eval-Metriken das Kriterium in normaler Sprache.
Simulation mehrstufiger Gespräche
Statt eine einzelne Antwort zu bewerten, spielt der Simulator ein vollständiges Gespräch gegen Ihre Anwendung durch und bewertet den ganzen Verlauf. So fallen Fehler auf, die erst nach mehreren Runden entstehen, etwa ein Bot, der eine früher akzeptierte Einschränkung vergisst. Sie legen Persona und Ziel fest, die Plattform erzeugt die Beiträge.
Regressionstests in der CI/CD
LLM-Regressionstests laufen in GitHub Actions, GitLab CI, Jenkins oder jeder Pipeline, die die API aufrufen kann. Eine fehlgeschlagene Metrik blockiert einen Merge wie ein kaputter Unit-Test. Jeder Lauf wird gespeichert, sodass Sie Releases vergleichen und den Zeitpunkt eines Punkteabfalls genau bestimmen.
KI-Observability im Live-Betrieb
Das Tracing zeichnet jede Anfrage, jeden Span und jeden Thread Ihrer Produktionsanwendung auf und hängt die Metrikpunkte daran. Sie filtern Traces nach niedriger Punktzahl, erkennen Drift über die Zeit und setzen Alerts auf wiederholte Ausgaben oder Frustrationssignale. OpenTelemetry-Spans bleiben erhalten, wenn Sie von einem anderen Werkzeug kommen.
Menschliche Annotation und Metrik-Abgleich
In Annotations-Warteschlangen prüfen Fachexperten Ausgaben nach Ihren eigenen Kriterien. Danach vergleicht die Plattform ihre Labels mit den Metrikpunkten und zeigt, wo beide auseinanderliegen. Genau dieser Abstand ist nützlich: Er sagt Ihnen, ob eine Metrik zu nachsichtig ist, bevor Sie sie als Release-Gate einsetzen.
No-Code-Abläufe und MCP-Zugang
In bezahlten Plänen richten Sie Evaluierungen auf einen Live-Endpunkt, formen die Antwort um und planen wiederkehrende Läufe, ohne Code zu schreiben. Ein MCP-Server erlaubt außerdem Agenten in Cursor oder Claude Code, Evaluierungen zu starten und Ergebnisse direkt im Editor abzurufen.
Vor- und Nachteile
Vorteile
- DeepEval ist Open Source. Sie führen Prüfungen lokal aus und lesen den Metrikcode, statt einer geschlossenen Bewertungsmaschine zu vertrauen.
- Jede Punktzahl kommt mit Begründung, wodurch auch Personen ohne Testkenntnis einen Fehler nachvollziehen können.
- Tracing und Evaluierung liegen an einem Ort, Production-Daten werden also ohne Umweg zu neuen Testfällen.
- Die Integrationen decken den üblichen Stack ab: OpenAI, Claude, Gemini, Bedrock, LangChain, LlamaIndex, CrewAI und OpenTelemetry.
- Enterprise-Funktionen umfassen SSO, eigenes RBAC, SOC 2, HIPAA und On-Premise-Betrieb.
Nachteile
- Der kostenlose Plan begrenzt auf ein Projekt, zwei Nutzer und fünf Testläufe pro Woche. Das reicht zum Ausprobieren und kaum weiter.
- Der echte Team-Einsatz beginnt bei 200 Dollar im Monat, für Solo-Entwickler und kleine Projekte eine hohe Hürde.
- No-Code-Evaluierung, Online-Evaluierungen und Alerts sind kostenpflichtig. Die Gratisstufe setzt also weiterhin Python-Kenntnisse voraus.
- Die Aufrufe des Judge-Modells zahlen Sie selbst, und ein großer Datensatz mit starkem Modell treibt die Kosten schnell nach oben.
Häufige Fragen
Es testet und überwacht LLM-Anwendungen. Sie definieren Testfälle und Metriken, lassen sie gegen Ihre Anwendung laufen und erhalten Punktzahlen mit Begründung. Dieselbe Plattform beobachtet anschließend den Live-Traffic und bewertet eingehende Anfragen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Confident AI.
Alternativen zu Confident AI

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.

iFixAi
iFixAi · Business · SonstigesiFixAi ist ein Open-Source-Auditor für KI-Agenten. Er schickt den Agenten durch eine Simulation Ihres Geschäfts, bewertet jede Antwort und liefert eine Bewertung von A bis F mit Belegen.