
Latitude
Latitude Data S.L. · Sonstiges
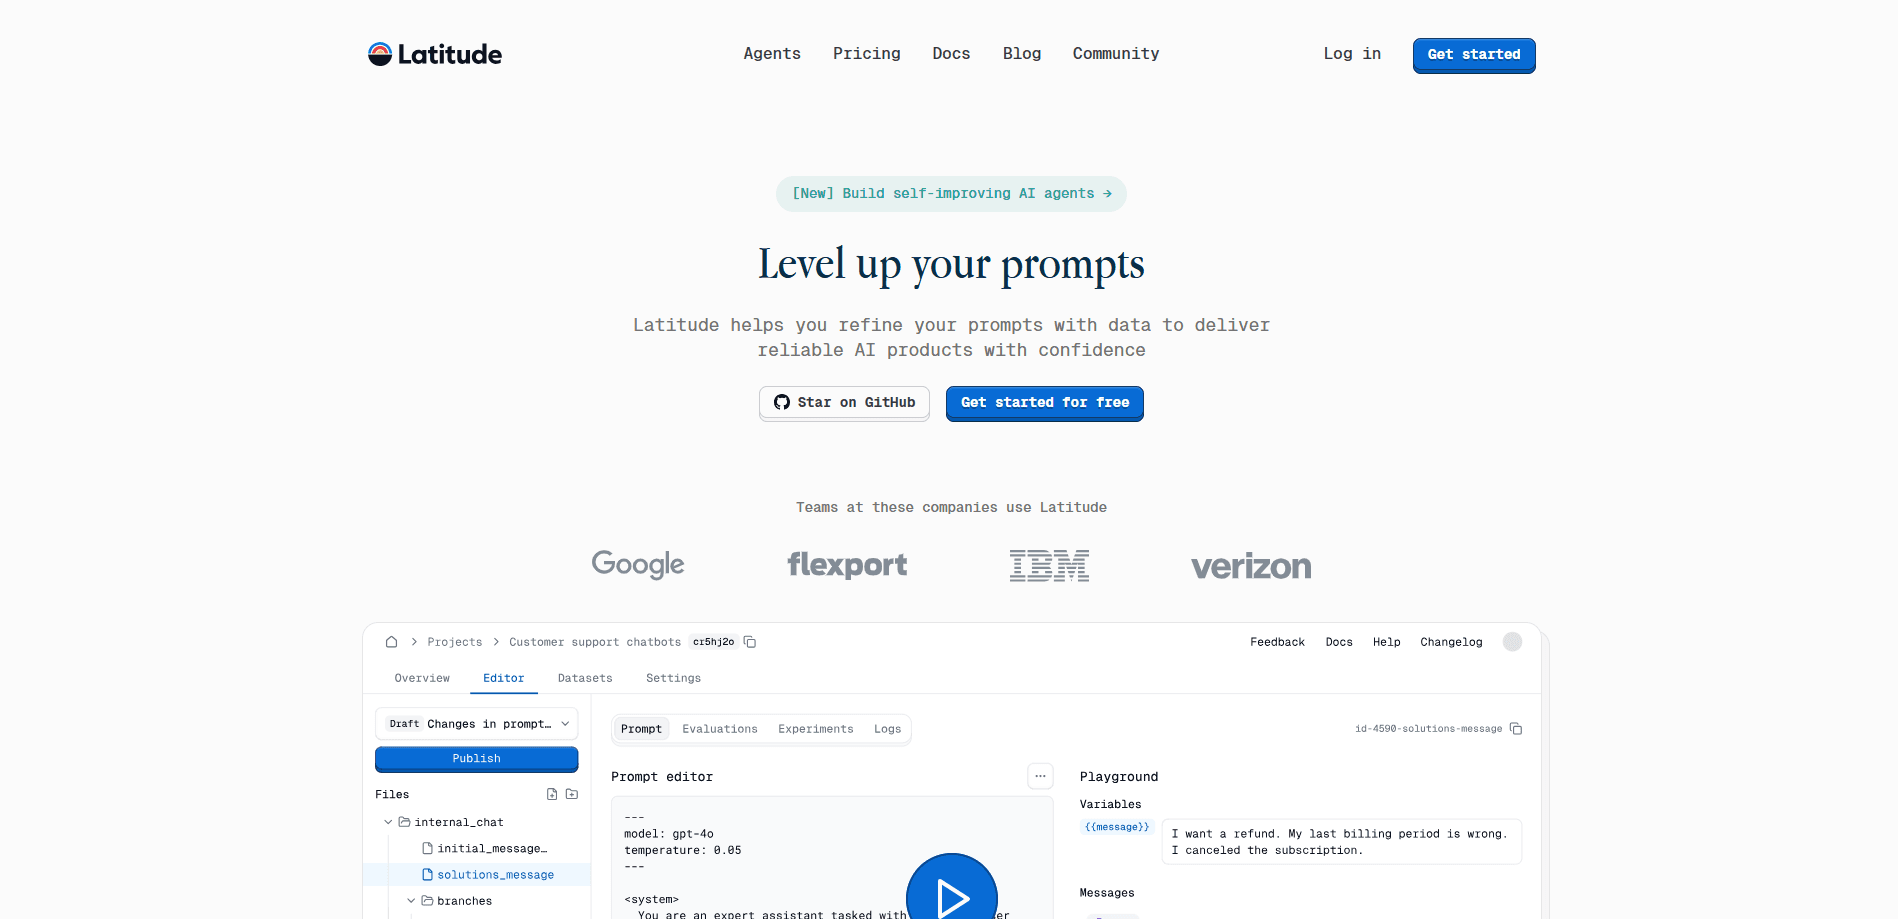
Latitude ist eine Open-Source-Plattform zur Überwachung von KI-Agenten in Produktion. Sie verfolgt echten Traffic, bündelt Fehler zu Signalen und kann den Fix an Ihren Coding-Agenten übergeben.
Über Latitude
What Is Latitude
Latitude ist eine MIT-lizenzierte Plattform zur Verbesserung von KI-Agenten, die bereits in Produktion laufen. Sie begann als Plattform für Prompt-Engineering zur LLM-Bewertung, und heute steht die Überwachung im Mittelpunkt: zu sehen, was ein laufender Agent wirklich tut, und wiederkehrende Fehler in etwas zu verwandeln, das das Team verfolgen und beheben kann.
Das Produkt folgt einem Kreislauf, den es Observe, Understand, Refine nennt. Latitude sammelt die Telemetrie Ihres Agenten und zerlegt jedes Gespräch in Traces und Sessions, sodass Sie Modellaufrufe, Tool-Aufrufe, Tokens, Latenz, Kosten und Fehler an einer Stelle sehen. Danach gruppiert es ähnliche Sessions nach Bedeutung, hebt wiederkehrende Fehlermuster als benannte Signale hervor und öffnet einen Alarm, wenn etwas Neues auftaucht oder ein altes Problem schlimmer wird. Als LLM-Monitoring-Plattform ist dieser Kreislauf das ganze Produkt: die Observability für KI-Agenten zwischen einem laufenden Agenten und dem Team, das für ihn verantwortlich ist. Darin steckt auch der Sinn von Open-Source-KI-Monitoring: der Trace bleibt in Ihrer Hand.
Das Agent-Tracing von Latitude macht aus einer undurchsichtigen Ausführung eine lesbare Folge von Spans und Sessions.
Die Grenze liegt im Umfang. Latitude betrachtet einen Agenten, den es schon gibt. Wer noch nichts gebaut hat, hat nichts zu überwachen. Auch braucht es echtes Produktionsvolumen, um nützlich zu sein, denn Verhaltenserkennung und Fehlerbündelung stützen sich auf Live-Traffic und nicht auf ein paar Testläufe.
Getting Started
- Registrieren Sie sich auf console.latitude.so und legen Sie ein Projekt für Ihren Agenten an.
- Installieren Sie das Latitude-SDK (npm oder PyPI) oder richten Sie Ihre bestehende OpenTelemetry-Pipeline auf Latitude aus.
- Senden Sie Ihre ersten Traces, die als Sessions im Dashboard ankommen.
- Prüfen Sie Traces, Tool-Zuverlässigkeit und Kosten, und lassen Sie Behaviors und Signals die wiederkehrenden Probleme aufdecken.
- Machen Sie aus einem Signal einen Monitor oder eine Evaluation und verbinden Sie optional den Latitude-MCP-Server, damit ein Coding-Agent den Fix aufgreift.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Latitude.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Engineers mit Agenten in Produktion
- Produktteams, die Agent-Funktionen ausliefern
- QA- und Evaluations-Verantwortliche
- Teams, die selbst hosten wollen
Aufgaben
- Mehrstufige Agent-Läufe verfolgen
- Wiederkehrende Fehler bündeln
- Kosten pro Session beobachten
- Verkehrsausschnitte vergleichen
- Den Korrektur-Kreislauf automatisieren
Szenarien
- Ein Support-Agent, der immer wieder hängt
- Ein Recherche-Agent, der das Budget frisst
- Ein nächtliches Release
Wichtigste Funktionen
OpenTelemetry-kompatibles Tracing
Latitude nimmt Agent-Telemetrie über das eigene SDK oder jede vorhandene OpenTelemetry-Pipeline in einem offenen, nicht proprietären Format auf. Modellaufrufe, Tool-Aufrufe, Retrieval-Schritte und verschachtelte Ausführung kommen als Spans an, und zusammengehörige Spans werden zu Sessions, die Sie als vollständige mehrstufige Gespräche lesen. Teams, die bereits OTel-Daten senden, können die Pipeline auf Latitude richten, statt die Instrumentierung neu zu bauen. Mit OpenTelemetry-Tracing bleibt der Datenpfad offen und nicht an einen Anbieter gebunden. Wer Monitoring von KI-Agenten ernst nimmt, braucht beides: eine einheitliche Sicht auf Kosten und Fehler und eine LLM-Observability, die sich selbst hosten lässt.
Signale, die Fehler zu verfolgten Problemen machen
Wenn Traces wiederholt scheitern, bündelt Latitude sie zu Signalen: benannte, priorisierte Fehlermuster mit Beispiel-Traces, betroffenen Nutzern und Trends. Signale entstehen aus menschlichen Anmerkungen, automatischen Flaggern, Evaluations und eigenen Prüfungen, sodass ein Frustrationsanstieg oder ein Tool-Fehler kein Log-Fragment mehr bleibt, sondern ein Problem mit Zuständigkeit wird.
Automatische Problemfindung und Alarme
Latitude beobachtet den eingehenden Verkehr und meldet, wenn ein neues Problem auftaucht oder ein bestehendes schlimmer wird. Alarme gehen an Slack, E-Mail oder Webhooks, sodass das Team davon erfährt, bevor Nutzer Tickets schreiben. Jedes Signal trägt seine fehlerhaften Traces und einen Trend, und genau das unterscheidet einen vagen Hinweis von etwas, auf das man reagieren kann.
Eingebaute Flagger und menschliche Anmerkungen
Die Plattform erkennt gängige Fehlerkategorien selbst, darunter Frustration, Verweigerung, Jailbreaking, Tool-Fehler und leere Antworten. Reviewer hinterlassen außerdem Inline-Feedback zu jedem Trace, Span oder Output, und dieses menschliche Urteil wird zu strukturiertem Signal, das das Team durchsucht, clustert und in Evaluations einfließen lässt.
Verwaltung von Datasets und Evaluations
Latitude baut goldene Datasets aus geprüften Produktions-Traces, eines pro Problem, mit eingebauter Versionierung. Teams führen Evaluations und Regressionstests gegen diese Datasets aus, und aus einem Signal erzeugte Evaluations bewerten den Live-Verkehr weiter, nachdem ein Fix ausgeliefert wurde. So bestätigen Sie, dass der Fix tatsächlich gehalten hat.
MCP-Server und Übergabe an den Coding-Agenten
Ein Model Context Protocol Server gibt Coding-Agenten Zugriff auf den Latitude-Workspace, sodass sie Projekte lesen und verwalten, ohne das Dashboard zu öffnen. Wenn ein Signal eskaliert, kann Latitude Claude Code oder Cursor mit vollem Kontext, Beispiel-Traces und Deep-Link übergeben, und der Agent setzt die kleinste richtige Korrektur um und öffnet einen Pull Request.
Sicherheit und Kontrollen auf Unternehmensniveau
Latitude ist nach SOC 2 Type II zertifiziert und verschlüsselt Daten während der Übertragung mit TLS 1.2+ und im Ruhezustand mit AES-256. Es unterstützt SAML 2.0 Single Sign-on, GDPR-Werkzeuge, Audit-Logs und Datenhaltung in Europa. Enterprise-Tarife ergänzen feine RBAC-Rollen, On-Premises- oder Cloud-Deployment und ein Verfügbarkeits-SLA.
Vor- und Nachteile
Vorteile
- Die ganze Plattform ist Open Source unter MIT, sodass Teams sie selbst hosten und nachvollziehen können, wie Agent-Daten behandelt werden.
- Traces, Tool-Zuverlässigkeit, Memory und Kosten liegen an einer Stelle, was den Sprung von etwas ist kaputt zu hier ist der fehlerhafte Schritt verkürzt.
- Signale und automatische Flagger senken den Triage-Aufwand, weil sie wiederkehrende Fehler bündeln, statt sie als verstreute Logs liegen zu lassen.
- Die Übergabe an den Coding-Agenten schließt den Kreis: ein erkanntes Problem wird zum Pull Request und nicht zu einem Ticket, das noch jemand schreiben muss.
- Der Preis startet kostenlos mit unbegrenzten Sitzen, sodass ein kleines Team es vor dem Bezahlen prüfen kann.
Nachteile
- Es hilft erst, wenn ein Agent in Produktion läuft, daher haben frühe Projekte wenig, worauf es schauen kann.
- Verhaltenserkennung und Fehlerbündelung brauchen echten Verkehr, um nützlich zu sein, was die Hürde für Tools mit wenig Volumen erhöht.
- Der Gratis-Tarif behält 30 Tage Daten und 20K Credits im Monat, daher wechseln Teams mit hohem Volumen schnell zum kostenpflichtigen Pro-Tarif.
- Die Einführung bedeutet, den Agenten zu instrumentieren und die Telemetrie zu verdrahten, echte Einrichtungsarbeit selbst mit dem schnellen OTel-Weg.
Häufige Fragen
Latitude ist ein Monitoring-Werkzeug für KI-Agenten, das auf Agenten ausgelegt ist, die bereits in Produktion laufen. Es erfasst den echten Verkehr als Traces und Sessions und macht dann Fehler, Kosten und Verhaltensmuster sichtbar, damit Teams finden und beheben, was schiefläuft.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Latitude.
Alternativen zu Latitude

Odyssey 3
Odyssey · SonstigesOdyssey-3 ist Odysseys fundamentales Weltmodell. Es simuliert Physik in Echtzeit, macht aus einer Eingabe eine interaktive Umgebung und lässt sich an Roboter, Autos und Spiele anpassen.

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.