
LFM2
Liquid AI · Sonstiges
LFM2 ist eine Familie kleiner Sprachmodelle von Liquid AI, ein KI-Modell auf dem Gerät für den lokalen Einsatz. Die Varianten mit 350M, 700M und 1.2B laufen schnell auf einer gewöhnlichen CPU.
Über LFM2
What Is LFM2
LFM2 ist die zweite Generation der Foundation-Modelle von Liquid AI und erschien im Juli 2025. Das Unternehmen stammt aus dem CSAIL-Labor am MIT und baut Modelle, die rohe Größe gegen Geschwindigkeit und Speichereffizienz tauschen. LFM2 kommt in drei dichten Varianten: 350M, 700M und 1.2B Parameter. Jede ist klein genug, um auf einem Smartphone, einem Laptop oder dem System eines Autos zu laufen, ohne ein Rechenzentrum dahinter.
Das Versprechen ist einfach. Cloud-Modelle sind leistungsstark, aber langsam und teuer im großen Maßstab, und sie schicken Ihre Daten vom Gerät weg. LFM2 will nützliche KI lokal halten, wo Antworten in Millisekunden zurückkommen und nichts die Maschine verlässt. Laut Liquid AI dekodieren und befüllen die Modelle auf einer CPU doppelt so schnell wie Qwen3, und die Trainingspipeline ist dreimal effizienter als bei der ersten LFM-Generation.
Der Haken ist, dass ein kleines Modell wenig weiß. Liquid AI empfiehlt, LFM2 für enge Aufgaben wie Datenextraktion, RAG oder mehrstufigen Chat feinabzustimmen, und warnt vor wissensintensiver Arbeit wie tiefem Schlussfolgern oder komplexer Programmierung. Behandeln Sie LFM2 als schnellen, privaten Baustein, nicht als Assistenten, der alles weiß.
Getting Started
- Wählen Sie auf Hugging Face eine Variante, die zu Ihrer Hardware passt, von 350M für winzige Geräte bis 1.2B für einen Laptop oder eine einzelne GPU
- Laden Sie die Gewichte herunter, oder nutzen Sie ein quantisiertes Format wie GGUF für llama.cpp, wenn der Speicherbedarf noch kleiner sein soll
- Führen Sie das Modell lokal über ein unterstütztes Framework aus, darunter llama.cpp, ExecuTorch oder die Standardwerkzeuge von Transformers
- Stimmen Sie es mit einem Framework wie TRL auf Ihre eigenen Daten ab, falls eine allgemeine Variante Ihre Aufgabe verfehlt, und bringen Sie die abgestimmte Fassung dann auf Ihr Gerät
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von LFM2.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- App-Entwickler mit lokalen Funktionen
- Teams mit Datenschutzauflagen
- Bastler und Neugierige
- Startups unter 10 Mio. USD Umsatz
Aufgaben
- Agentische Abläufe
- Datenextraktion
- Retrieval-Augmented Generation
- Mehrstufiger Chat
- Hilfe beim kreativen Schreiben
Szenarien
- Eine Handy-App muss offline antworten
- Ein Laptop-Nutzer will lokal schreiben
- Ein Gerätehersteller bringt KI auf knappem Raum unter
- Ein reguliertes Team muss Daten im Haus halten
- Ein Entwickler erprobt einen Agenten im Autosystem
Wichtigste Funktionen
Hybride Architektur aus Faltung und Aufmerksamkeit
LFM2 mischt kurze Faltungen mit gruppierter Query-Aufmerksamkeit, statt sich allein auf Aufmerksamkeit zu stützen. Jedes Modell stapelt 16 Blöcke: 10 Blöcke kurzer Faltung mit doppeltem Gate und 6 Blöcke gruppierter Query-Aufmerksamkeit. Das Design erfasst lokale Muster günstig und greift nur dort auf Aufmerksamkeit zurück, wo sie sich lohnt, was Latenz und Speicher auf der Hardware niedrig hält, die tatsächlich in Handys und Laptops steckt.
Tempo auf gewöhnlichen CPUs
Das große Versprechen ist der Durchsatz, nicht die rohe Genauigkeit. Laut Liquid AI dekodiert und befüllt LFM2 auf einer CPU doppelt so schnell wie Qwen3, und die kleinere 700M-Variante bleibt in llama.cpp wie in ExecuTorch schneller als ein Qwen 0.6B, obwohl sie mehr Parameter trägt. Dieser Unterschied zählt auf einem Handy oder einem dünnen Laptop, wo die CPU der einzige Chip ist, auf den Verlass ist.
Vier Größen für verschiedene Geräte
Die Familie reicht von 350M über 700M und 1.2B bis 2.6B Parameter, sodass Sie das Modell ans Gerät anpassen. Die 350M-Variante passt in Wearables und enge eingebettete Ziele, während die 1.2B-Variante auf einem Laptop oder einer einzelnen GPU läuft und mit Modellen mithält, die deutlich mehr Parameter tragen. Als Familie für den Rand bedeutet eine Architektur über mehrere Größen, dass Sie eine Funktion nach oben oder unten schieben können, ohne sie neu zu schreiben.
Wettbewerbsfähiger LFM2-Benchmark im kleinen Maßstab
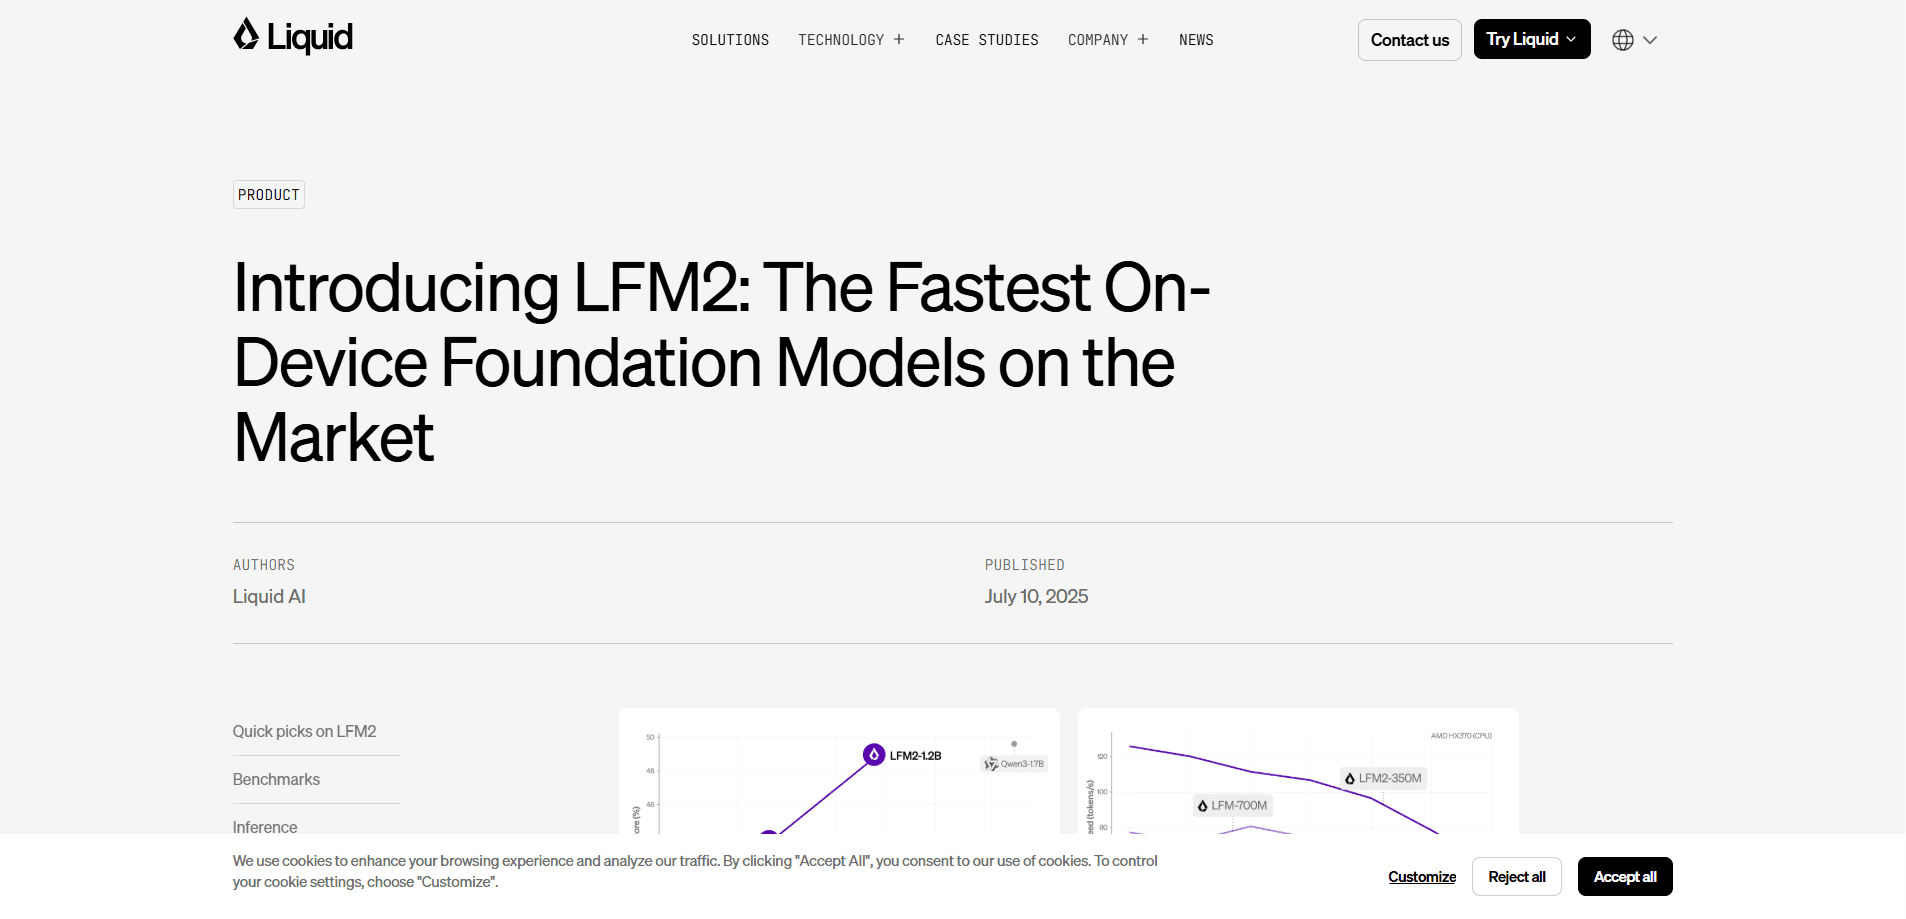
Laut Liquid AI hält LFM2-1.2B mit Qwen3-1.7B mit, einem Modell mit 47 Prozent mehr Parametern, und seine Werte liegen nahe bei Modellen, die ein Vielfaches größer sind. Die 700M-Variante übertrifft Gemma 3 1B IT, und die 350M-Variante liefert sich ein Kopf-an-Kopf-Rennen mit Qwen3-0.6B und Llama 3.2 1B Instruct. In den eigenen Mehrrunden-Tests des Unternehmens bevorzugten die Prüfer das 1.2B-Modell gegenüber Llama 3.2 1B Instruct und Gemma 3 1B IT.
Offene Gewichte und flexible Lizenz
Liquid AI veröffentlicht die Gewichte auf Hugging Face unter einer offenen Lizenz nach dem Vorbild von Apache 2.0. Die akademische und Forschungsnutzung ist kostenlos, und Firmen unter 10 Mio. USD Umsatz dürfen die Modelle kostenlos kommerziell nutzen. Oberhalb dieser Schwelle kontaktieren Sie Liquid AI für eine kommerzielle Lizenz, was die Bedingungen für kleinere Teams einfach hält und Raum für Vereinbarungen mit großen Kunden lässt.
Breite Werkzeugunterstützung
LFM2 exportiert in die Frameworks, die Entwickler ohnehin nutzen. Es läuft über llama.cpp für lokale Inferenz, über PyTorch mit ExecuTorch für Mobilgeräte und mit den Standardwerkzeugen von Transformers fürs Training. Feinabstimmung mit TRL ist ein unterstützter Weg, und GGUF-Versionen machen es leicht, die Modelle in bestehende Inferenz-Apps einzubauen.
32K-Kontext und mehrsprachiges Training
Jede Variante verarbeitet ein Kontextfenster von 32.768 Tokens, genug für lange Dokumente und ausgedehnte Chats. Das Training stützte sich auf 10 Billionen Tokens, aufgeteilt auf rund 75 Prozent Englisch, 20 Prozent mehrsprachig und 5 Prozent Code, mit zusätzlichem Schwerpunkt auf Japanisch, Arabisch, Koreanisch, Spanisch, Französisch und Deutsch. Damit passt LFM2 gut zu Apps, die mehr als eine Sprache bedienen.
Vor- und Nachteile
Vorteile
- Läuft schnell auf den CPUs, die schon in Handys, Laptops und Autos stecken, sodass Sie weder GPU noch Cloud-Dienst brauchen
- Die kleinen Varianten halten den Speicherbedarf niedrig, was zu Wearables und anderen engen eingebetteten Zielen passt
- Die Werte erreichen oder übertreffen größere Modelle wie Qwen3-1.7B und Gemma 3 1B IT bei einem Bruchteil der Größe
- Offene Gewichte und eine kostenlose kommerzielle Lizenz unter 10 Mio. USD Umsatz halten den Einstieg günstig
- Arbeitet mit vertrauten Werkzeugen wie llama.cpp, ExecuTorch und TRL, sodass die Einführung keinen Umbau verlangt
Nachteile
- Kleine Modelle tragen weniger Weltwissen, daher liegen wissensintensive Aufgaben wie tiefes Schlussfolgern oder komplexe Programmierung außerhalb ihres Bereichs
- Liquid AI empfiehlt die Feinabstimmung für enge Anwendungsfälle, was zusätzliche Arbeit bedeutet, bevor die besten Ergebnisse sichtbar werden
- Die kommerzielle Lizenz verlangt eine bezahlte Vereinbarung, sobald Ihr Unternehmen 10 Mio. USD Umsatz überschreitet, sodass das Hochskalieren Kosten mit sich bringt
- Es gibt inzwischen neuere LFM2.5-Varianten und größere LFM2-Modelle, sodass die drei ursprünglichen Größen nicht mehr die neueste Option sind
Häufige Fragen
LFM2 ist für KI auf dem Gerät gebaut, bei der ein kleines Modell lokal statt in der Cloud läuft. Typische Anwendungen sind agentische Abläufe, Datenextraktion, Retrieval-Augmented Generation, mehrstufiger Chat und Hilfe beim kreativen Schreiben. Liquid AI lenkt Entwickler eher auf enge, klar umrissene Aufgaben als auf allgemeines Schlussfolgern.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu LFM2.
Alternativen zu LFM2

Odyssey 3
Odyssey · SonstigesOdyssey-3 ist Odysseys fundamentales Weltmodell. Es simuliert Physik in Echtzeit, macht aus einer Eingabe eine interaktive Umgebung und lässt sich an Roboter, Autos und Spiele anpassen.

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.