
LLM Gateway
The Open Co · Sonstiges
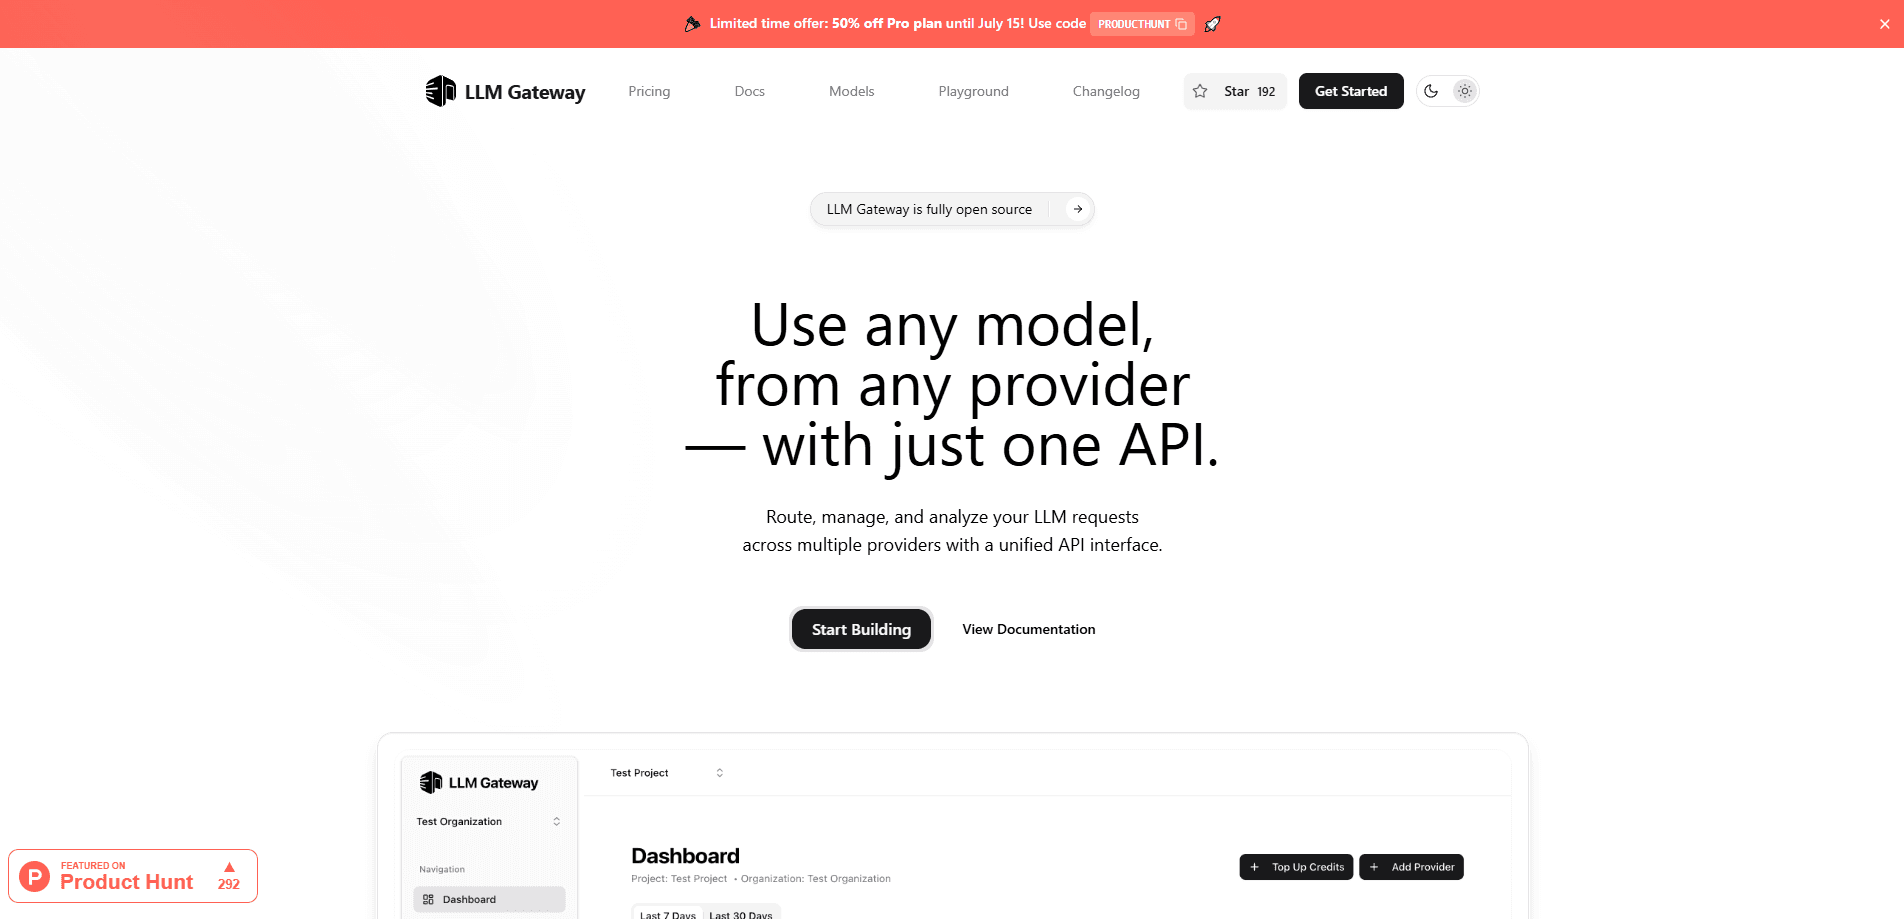
LLM Gateway ist ein Open-Source-KI-Gateway, das Anfragen an über 250 Modelle von 40 Anbietern über einen OpenAI-kompatiblen Endpunkt leitet, mit Failover, Cache und Kostenkontrolle.
Über LLM Gateway
What Is LLM Gateway
LLM Gateway ist eine Zwischenschicht zwischen Ihrer App und den Modellanbietern. Sie richten Ihr OpenAI-SDK auf eine einzige Basis-URL aus, behalten einen API-Schlüssel und rufen das gewünschte Modell auf. Das Gateway schickt die Anfrage an einen Anbieter und gibt die Antwort im Format zurück, das Ihr Code schon erwartet.
Das Problem, das es löst, ist die Zersplitterung der Anbieter. Sobald ein Projekt OpenAI, Anthropic, Google und einen Host für offene Modelle berührt, sammeln sich getrennte Schlüssel, SDKs und Rechnungen an. LLM Gateway fasst das in einer Schnittstelle für den Zugriff auf Modelle mehrerer Anbieter zusammen, sodass ein Modellwechsel eine geänderte Zeichenkette ist und keine Neuentwicklung.
Der Kern ist Open Source unter AGPLv3, was zählt, wenn Sie Prompts lieber im eigenen Netzwerk behalten. Sie können die gehostete Cloud nutzen oder denselben Code selbst als selbst gehosteten LLM-Proxy mit Docker, Compose oder Kubernetes betreiben. Der Haken: Beim Selbsthosten liegen Verfügbarkeit und Updates bei Ihrem Team, und die kostenlose Stufe stützt sich auf Community-Support.
Getting Started
- Melden Sie sich im Dashboard an, legen Sie ein Projekt an und kopieren Sie den erzeugten API-Schlüssel.
- Exportieren Sie den Schlüssel als
LLM_GATEWAY_API_KEYin Ihrer Shell oder einer.env-Datei. - Ändern Sie die Basis-URL Ihres OpenAI-SDK zu
https://api.llmgateway.io/v1und behalten Sie Ihren Code. - Rufen Sie ein Modell über seinen Namen auf, etwa
gpt-4o, und lassen Sie das Gateway den Anbieter wählen. - Beobachten Sie Latenz, Kosten und Anbieteraufteilung im Dashboard und ergänzen Sie Cache oder Failover, wenn der Verkehr wächst.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von LLM Gateway.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend- und Plattformentwickler
- KI-Produktteams
- Datenschutzbewusste Entwicklungsteams
Aufgaben
- Modelle wechseln ohne Neuentwicklung
- Anbieterausfälle überstehen
- KI-Ausgaben steuern
Szenarien
- Einen Chatbot mit mehreren Anbietern produktiv betreiben
- Mit kostenlosen Modellen prototypen
- Daten im Haus behalten
Wichtigste Funktionen
One OpenAI-Compatible Endpoint
Das Gateway spricht das Format der OpenAI-API, sodass Chat-Completions, Embeddings, Bilder, Sprache und Transkription über Ihr bestehendes SDK laufen. Sie ändern die Basis-URL und den Modellnamen, sonst nichts. Für Teams, die schon auf dem OpenAI-SDK sind, ist das die ganze Migration.
Smart Routing and Automatic Fallback
Anfragen lassen sich nach Preis, Latenz, Durchsatz oder Verfügbarkeit leiten, und mit der Form Anbieter/Modell binden Sie einen bestimmten Anbieter fest. Eine Anfrage, die nur ein Modell nennt, wird bei einem anderen Anbieter erneut versucht, der es bedient, wenn der erste scheitert. Mit dem Header X-No-Fallback: true blockieren Sie das, wenn Sie lieber einen klaren Fehler sehen.
Response Caching
Wiederholte Anfragen können aus einem Redis-gestützten Cache bedient werden, was Latenz und Kosten bei identischen Prompts senkt. Die Cache-Steuerung des Anbieters wird ebenfalls durchgereicht, sodass dessen eigenes Verhalten erhalten bleibt. Apps mit hohem Volumen merken das zuerst auf der Rechnung.
Guardrails and PII Protection
Das Gateway erzwingt Schutz vor Prompt-Injection, Erkennung und Schwärzung personenbezogener Daten, Erkennung von Geheimnissen und eine eigene Regel-Engine am Rand. Die Richtlinie läuft an derselben Stelle, die jede Anfrage passiert, nicht in jeder App. Teams mit sensiblen Eingaben gewinnen einen einzigen Kontrollpunkt.
Centralized Key Management
Anbieterschlüssel liegen verschlüsselt und sind mit projektbezogenen API-Schlüsseln verbunden, die Nutzungs- und Ausgabengrenzen sowie vollständige Audit-Spuren tragen. Sie rotieren Schlüssel, ohne den Anwendungscode anzufassen. Genau das verhindert, dass ein wachsendes Team rohe Anbieterschlüssel weiterreicht.
Cloud or Self-Hosted Deployment
Sie können das gehostete Gateway nutzen oder den AGPLv3-Code auf eigener Infrastruktur mit Docker, Compose oder Kubernetes betreiben. Ein selbst gehosteter LLM-Proxy ist kostenlos, und alles vom Routing bis zur Analyse läuft gleich. Die Wahl läuft darauf hinaus, wer die Verfügbarkeit verantworten soll.
Vor- und Nachteile
Vorteile
- Ein einziger OpenAI-kompatibler Endpunkt deckt über 250 Modelle von 40 Anbietern ab, sodass ein Modellwechsel eine geänderte Zeichenkette ist.
- Automatisches Failover und Retry halten Anfragen am Leben, wenn ein Anbieter limitiert oder ausgefallen ist.
- Antwort-Cache und Ausgabengrenzen pro Schlüssel geben direkte Kontrolle über die KI-Kosten.
- Der AGPLv3-Kern lässt sich selbst hosten, was Prompts und Antworten im eigenen Netz hält.
- Leitplanken gegen Prompt-Injection, personenbezogene Daten und Geheimnisse laufen im Gateway statt in jeder App.
Nachteile
- Guthaben im Nutzungsmodell tragen eine pauschale Plattformgebühr von 5% auf die Tokenpreise der Anbieter, sodass die verwaltete Nutzung teurer ist als direkte Anbieteraufrufe.
- Selbsthosting verlagert Verfügbarkeit, Updates und Skalierung auf Ihr Team, was echte Betriebsarbeit bedeutet.
- Die kostenlose Stufe ist begrenzt und stützt sich auf Community-Support, sodass Produktionsteams am Ende zahlen oder selbst hosten.
Häufige Fragen
Es dient dazu, viele KI-Modelle über eine einzige API aufzurufen. Statt OpenAI, Anthropic, Google und andere einzeln einzubinden, schicken Sie Anfragen an einen einzigen OpenAI-kompatiblen Endpunkt und überlassen das Routing dem Gateway.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu LLM Gateway.
Alternativen zu LLM Gateway

Odyssey 3
Odyssey · SonstigesOdyssey-3 ist Odysseys fundamentales Weltmodell. Es simuliert Physik in Echtzeit, macht aus einer Eingabe eine interaktive Umgebung und lässt sich an Roboter, Autos und Spiele anpassen.

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.