
Preprocess
Preprocess · Produktivität · Business
Preprocess war eine API für Dokumenten-Chunking, die PDFs, Office-Dateien und HTML in RAG-fertige Textabschnitte zerlegte. Der Dienst wurde inzwischen eingestellt.
Über Preprocess
What Is Preprocess
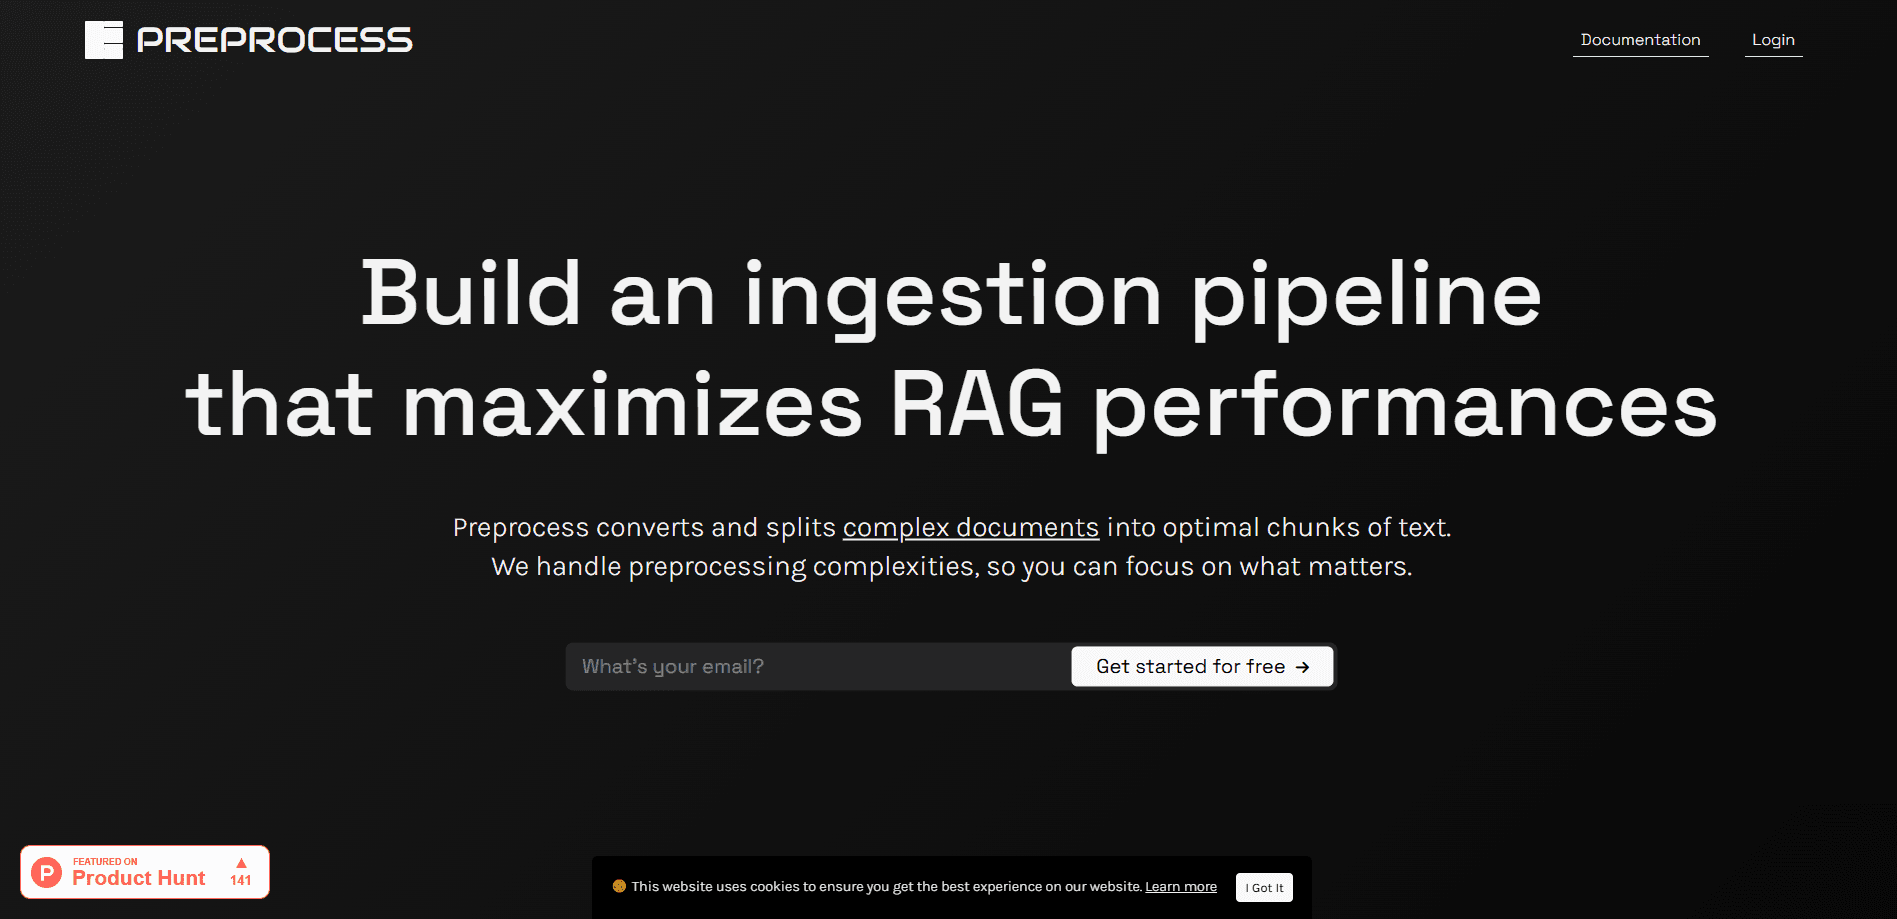
Preprocess war ein API-Dienst, der lange und komplexe Dokumente in Textabschnitte für die Wiederauffindung zerlegte. Statt eine Datei alle paar hundert Wörter zu zerschneiden, las er Titel, Abschnitte, Absätze, Tabellen, Bilder und Listen und trennte den Inhalt dann entlang der Struktur und Bedeutung des Dokuments. Das Unternehmen bot das Ergebnis als RAG-fertige Daten an: saubere Teile, die man vektorisieren, indexieren und ohne Nacharbeit in eine Vektordatenbank legen konnte.
Das Problem, das die Datenvorbereitung für RAG anging, war real. Fast alle Teams zerlegen Dokumente nach einer festen Wortzahl, und diese Methode reicht dem Modell, was gerade ins Fenster fällt. Die PDF-Parsing-API setzte dagegen auf den Aufbau der Datei, anstatt jeden Textblock gleich zu behandeln. Eine Tabellenzeile klebt an einer fremden Überschrift, eine Definition verliert ihre Liste, und das Modell antwortet aus Bruchstücken. Preprocess behauptete, der strukturbewusste Weg könne die RAG-Leistung um bis zu 10x steigern, eine Zahl des Unternehmens selbst und kein unabhängiger Vergleichswert.
Ein Punkt wiegt heute schwerer als jede Funktion. Der Dienst unter preprocess.co ist nicht mehr verfügbar. Die offizielle Website liefert ein leeres Verzeichnis, der Anbieter hat den Dienst abgeschaltet, und sowohl das Python-SDK als auch der LlamaIndex-Reader tragen den Hinweis, dass das Projekt eingestellt ist und aus Projekten entfernt werden soll.
Getting Started
Das waren die Schritte, als der Dienst noch lief.
- Melden Sie sich in der Preprocess-App an und kaufen Sie ein Credit-Paket, um einen API-Schlüssel zu erhalten
- Senden Sie das Dokument per Upload oder über das Python-SDK an den Analyse-Endpunkt
- Lassen Sie die asynchrone Analyse durchlaufen und empfangen Sie das Ergebnis über Ihren Webhook oder holen Sie es binnen 24 Stunden per GET-Aufruf ab
- Schieben Sie die zurückgegebenen Abschnitte direkt in Ihren Vektorspeicher, ohne separaten Text-Splitter
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Preprocess.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Entwickler, die RAG-Pipelines bauten
- Backend-Entwickler ohne eigenen Parser
- Produktteams, die einen KI-Assistenten auslieferten
Aufgaben
- Lange PDFs zerlegen
- Tabellen und Listen extrahieren
- Gescannte Dokumente verarbeiten
- Office- und HTML-Dateien verarbeiten
Szenarien
- Ein Juristen- oder Finanzteam, das dichte Verträge in ein Suchwerkzeug gab
- Ein Support-Bot aus Handbüchern und Hilfeseiten
- Ein Startup ohne Parsing-Team
- Ein Batch-Ingest
Wichtigste Funktionen
Strukturbewusstes intelligentes Chunking
Die Kernfunktion zerlegte Dokumente entlang von Titeln, Abschnitten, Absätzen, Tabellen, Bildern und Listen und gruppierte lange Passagen dann nach Bedeutung. So zielte jeder Abschnitt auf ein Thema, und die Vektorisierung erfasste einen einzelnen Gedanken. Das Unternehmen argumentierte, schon das hebe die Suchqualität und senke Halluzinationen, weil das Modell keine unpassenden Bruchstücke mehr bekam.
Breite Formatunterstützung
Die API nahm PDFs, Microsoft-Office-Dateien, OpenOffice-Dateien, HTML und reinen Text über einen Endpunkt an. Gescannte PDFs liefen ebenfalls, weil die Textextraktion vor dem Chunking startete. Für Teams mit gemischten Quellen bedeutete das eine Integration statt eines Parsers pro Dateityp.
Asynchrone API und Webhooks
Ein langes Dokument zu analysieren dauert, deshalb lief die API asynchron. Ein Analyseaufruf bestätigte den Eingang, und die fertigen Abschnitte kamen per Webhook oder ließen sich 24 Stunden lang per GET-Aufruf abholen. Dieses Design passte zu Batch-Jobs, bei denen Dutzende Dateien gleichzeitig laufen und nichts in der Schlange wartet.
Python-SDK und LlamaIndex-Integration
Ein SDK namens pypreprocess hüllte die API in ein paar Zeilen Python, und ein LlamaIndex-Reader lud bereits zerlegte Dateien oder holte frühere Ergebnisse über die Prozess-ID. Der Reader gab auch den vollen Dokumenttext zurück, wenn ein Team seine eigene Pipeline nutzen wollte. SDK und Reader gelten heute als eingestellt.
Preise über Credits statt Abo
Preprocess verzichtete auf Monatsgebühren. Man kaufte ein Credit-Paket und lud auf, wenn es leer war. Eine Seite eines Dokuments oder einer Präsentation kostete einen Credit, ein Tabellenblatt kostete einen Credit, und HTML- oder Textdateien wurden vor dem Zählen in PDF umgewandelt. Das Modell passte zu Teams mit ungleichmäßiger Last.
Enterprise-Kontrollen
Höhere Tarife ergänzten Bild-Export, Kontrolle der Abschnittsgrenzen, Vereinbarungen zur Null-Datenhaltung, On-Prem-Betrieb und angepasste Verarbeitungspipelines. Diese Optionen zielten auf regulierte Branchen, in denen Dokumentdaten die eigene Infrastruktur nicht verlassen dürfen.
Vor- und Nachteile
Vorteile
- Zerlegte nach Struktur und Bedeutung, sodass die Suche Passagen lieferte, die beim Thema blieben
- Ein Endpunkt deckte PDFs, Office-Dateien, HTML und reinen Text ab, gescannte Dateien inbegriffen
- Kein Abo, nur Credit-Pakete, die zu schwankender Last passten
- Webhooks und das Python-SDK fügten sich ohne zusätzlichen Kleber in bestehende Ingestion-Pipelines
- Der LlamaIndex-Reader brachte es in einen gängigen RAG-Stack
Nachteile
- Der Dienst ist eingestellt, also gibt es heute keine Möglichkeit, sich anzumelden, Credits zu kaufen oder die API aufzurufen
- Der versprochene bis zu 10-fache Gewinn kam vom Anbieter, ohne unabhängigen Beleg
- Der Preis lief über vorausbezahlte Credits statt über einen nutzungsbasierten Tarif, was Vorauszahlung für womöglich ungenutzte Kapazität bedeutete
- Erweiterte Kontrollen wie Abschnittsgrenzen und On-Prem-Betrieb blieben dem Enterprise-Tarif vorbehalten
Häufige Fragen
Preprocess war eine API für Dokumenten-Chunking in RAG-Pipelines. Sie las PDFs, Office-Dateien, HTML und reinen Text und zerlegte sie in Textabschnitte, die der Struktur und Bedeutung des Dokuments folgten, damit jeder Teil allein vektorisiert und indexiert werden konnte.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Preprocess.
Alternativen zu Preprocess

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Knocket
Knocket (Tencent RTC team) · Produktivität · Business · ChatbotKnocket ist ein kostenloses Werkzeug für Live-Chat und Kontaktseite: Besucher schreiben über Ihre Website, Ihre App oder einen Link, und Sie antworten aus Telegram oder einem einzigen Posteingang.

FloorGen
Vinit Kumar (FloorGen) · Produktivität · KI aus ChinaFloorGen ist ein Grundriss-Ersteller im Browser, der aus einem Satz oder einer Skizze einen bearbeitbaren 2D-Plan und einen 3D-Rundgang macht. Export als PDF, DXF oder Video, Zeichnen ohne Konto.