

Query Memory
Query Memory · Produktivität · Lernen
Query Memory ist eine einheitliche Arbeitsbereichsplattform zum Analysieren von Dokumenten, Verwalten von Daten und Bereitstellen von KI-Agenten über einen einzigen API-first-Stack. Sie bündelt Dokumentanalyse, Wissensindexierung, Agenten-Endpunkte und Web-Analyse hinter einem einzigen API-Schlüssel, sodass Teams PDFs, Tabellen, Verträge und E-Mails an ihre Anwendungen schicken können, ohne Dutzende einzelne Tools zu verdrahten. Die Zielgruppe sind Entwickler und Teams, die eine zentrale Gedächtnisschicht für ihre KI-Produkte wollen, nicht noch einen weiteren Chatbot.
Über Query Memory
Was ist Query Memory
Query Memory ist eine API-first-Plattform, die KI-Anwendungen eine Gedächtnisschicht gibt. Statt OCR-Dienste, Vektordatenbanken und separate Agenten-Laufzeitumgebungen zusammenzustückeln, binden Sie ein SDK ein und erreichen jede Fähigkeit über denselben Client. Das Versprechen auf der eigenen Website ist nüchtern: Dokumente analysieren, Datenbanken abfragen und das Web durch eine einheitliche API auslesen.
Das Problem, das sie löst, ist die Zersplitterung. Eine typische KI-Funktion braucht Dateiaufnahme, Aufteilung, Abruf und eine quellengestützte Antwort. Jeder dieser Schritte bedeutet meist einen anderen Anbieter und eine andere Abrechnung. Das summiert sich schnell. Query Memory fasst sie in einem Arbeitsbereich zusammen, mit Nutzungsverfolgung, API-Schlüsseln und gemeinsamen Endpunkten über Dienste hinweg.
Die klarste Einschränkung sind Umfang und Preis. Die kostenlose Stufe ist klein und begrenzt Sie auf 25 Dokumentanalysen und 100 API-Anfragen pro Monat, und echter Produktionsverkehr drängt Sie zum Pro-Plan für 99 $/Monat oder zu einem individuellen Enterprise-Vertrag. Es ist außerdem eine Entwicklerplattform, also gibt es hier noch nicht viel für Sie, wenn Sie keinen Code schreiben.
Erste Schritte
- Erstellen Sie ein Query-Memory-Konto über die Registrierungsseite und öffnen Sie das Dashboard.
- Erzeugen Sie einen API-Schlüssel und initialisieren Sie dann das SDK mit Ihrer Basis-URL und Ihrem Schlüssel.
- Laden Sie Dokumente in eine Wissensdatenbank oder senden Sie sie an den Analyse-Endpunkt für strukturierte Ausgabe.
- Fragen Sie Ihr indexiertes Wissen ab, rufen Sie einen Agenten-Endpunkt auf oder starten Sie eine Web-Analyse-Anfrage über denselben Client.
- Verfolgen Sie Nutzung, Speicher und Endpunktverkehr im Konto-Dashboard, während das Volumen wächst.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Query Memory.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend- und KI-Entwickler, die Dokumentaufnahme und -abruf brauchen, ohne mehrere Anbieter zusammenzusetzen.
- Produktteams, die quellengestützte Assistenten bauen, die Quelldokumente zitieren müssen.
- Daten- und Betriebsteams, die Verträge, Berichte und Akten in einem einzigen berechtigungsgesteuerten Hub durchsuchbar machen wollen.
Aufgaben
- PDFs, DOCX-Dateien, Tabellen, HTML und Bilder in saubere strukturierte Elemente analysieren.
- Eine Dokumentensammlung in eine Wissensdatenbank indexieren und sie mit natürlicher Sprache abfragen.
- Quellengestützte Agenten-Endpunkte bereitstellen, die mit verlinkten Quellen antworten.
- Domänenbezogene Web-Extraktion ausführen, um lebendigen externen Kontext in eine Anwendung zu holen.
Szenarien
- Ein Fintech-Team, das Fragen über Leasingverträge und Zeichnungsunterlagen stellen will.
- Ein Supportprodukt, das Schadensfälle und Vertragsdokumente auf Abruf zusammenfassen muss.
- Ein Recherche-Workflow, der hochgeladene Paper mit Live-Webseiten in einer einzigen Abfrage mischt.
Wichtigste Funktionen
Einheitliche API und SDK
Ein Client deckt Wissen, Agenten und Web-Analyse ab, also initialisieren Sie das SDK einmal und verwenden denselben API-Schlüssel überall wieder. Die Firma selbst formuliert es so, dass dies einen Stapel zersplitterter Tools durch einen einzigen Endpunkt ersetzt. Das zählt vor allem für Teams, die sonst drei Integrationen und drei Sätze von Zugangsdaten pflegen müssten. Weniger bewegliche Teile. Weniger Schlüssel zum Rotieren.
Dokumentanalyse
Query Memory analysiert PDF, DOCX, Tabellen, HTML, Bilder und reinen Text in strukturierte Elemente. Die Website behauptet, ihre spezialisierten multimodalen Modelle erreichen über 98 % Genauigkeit bei komplexen Layouts und übertreffen damit klassisches OCR und generische LLMs. Behandeln Sie diese Zahl als Anbieteraussage, bis Sie sie mit Ihren eigenen Dokumenten testen.
Wissensindexierung
Dateien verbinden sich zu durchsuchbaren Wissensdatenbanken, die schnellen semantischen Abruf unterstützen. Abfragen liefern geordnete Ausschnitte und den umgebenden Kontext zurück, sodass Sie einem Modell quellengestütztes Material geben können, statt rohen Text hineinzuschütten, und jeder Hub bleibt berechtigungsgesteuert, damit sensible Dokumente auf die richtigen Nutzer beschränkt bleiben.
Agenten-Endpunkte
Sie können quellengestützte KI-Agenten mit Modellsteuerung, Prompts und quellenbewussten Antworten bereitstellen. Agenten-Abfragen laufen über dieselbe SDK-Oberfläche. Das hält die Integration flach. Für Teams, die Assistenten ausliefern, entfällt die Notwendigkeit, eine separate Agenten-Laufzeit zu hosten und zu skalieren.
Web-Analyse
Die Web-Analyse führt domänenbezogene Extraktion und geordneten Abruf aus, um lebendigen externen Kontext zu holen. Sie verwendet dieselben Ausgabeformate wie die Dokumentseite. Eine Webseite und ein PDF landen in derselben Form. Diese Konsistenz ist der praktische Gewinn, wenn Sie interne und externe Quellen zusammenführen.
Konnektoren und Integrationen
Die Plattform listet Konnektoren zu Microsoft SharePoint, Google Drive, Snowflake, Databricks, Oracle Cloud Infrastructure und Dropbox und behauptet weitere 400. Diese Abdeckung lässt Teams Daten dort indexieren, wo sie schon liegen, statt erst alles zu migrieren. Die Tiefe jedes Konnektors sollten Sie pro Quelle prüfen, bevor Sie sich festlegen.
Nutzung und operative Sichtbarkeit
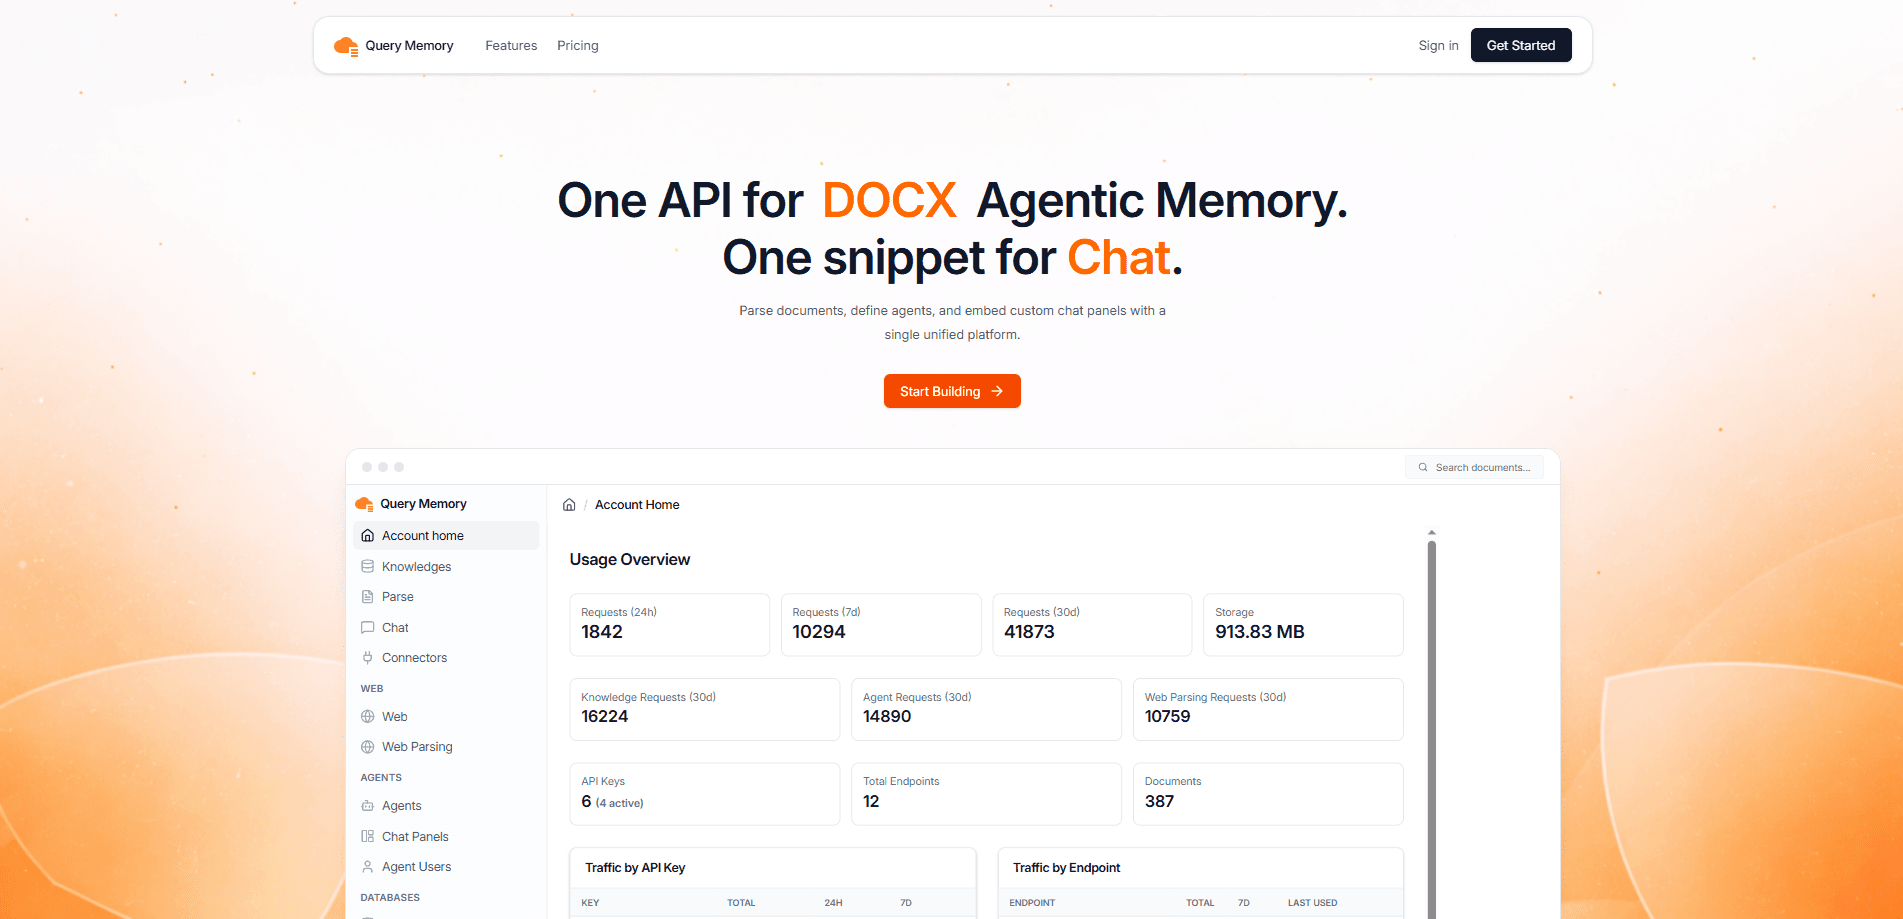
Das Dashboard zeigt Anfragen über 24 Stunden, 7 Tage und 30 Tage, genutzten Speicher, nach API-Schlüssel und Endpunkt aufgeschlüsselten Verkehr und aktuelle Serviceaktivität. Für Teams, die das in Produktion betreiben, beantwortet diese Sichtbarkeit eine einfache Frage. Welcher Endpunkt schießt hoch, und welcher Schlüssel ist dafür verantwortlich? Es ist keine vollständige Observability-Suite. Sie deckt trotzdem das Nötige ab, um zu sehen, welcher Dienst Sie wirklich Geld kostet.
Vor- und Nachteile
Vorteile
- Ein einziger API-Schlüssel und ein SDK decken Analyse, Wissen, Agenten und Web-Abfragen ab, was Integrationsarbeit spart.
- Die strukturierte Ausgabe bleibt über Dokumenttypen und Webseiten hinweg konsistent.
- Die kostenlose Stufe lässt Sie die API zur Dokumentanalyse und die API für Wissensdatenbanken vor dem Bezahlen testen.
- Berechtigungsgesteuerte Wissens-Hubs halten sensible Akten beschränkt.
- Konnektoren zu SharePoint, Drive, Snowflake und ähnlichen Quellen verringern die Datenmigration.
Nachteile
- Die kostenlose Stufe ist knapp, mit 25 Analysen und 100 API-Anfragen pro Monat, und übersteht keine echten Tests.
- Pro springt auf 99 $/Monat, und Überschreitungen werden nutzungsbasiert abgerechnet, also skalieren die Kosten mit starker Nutzung.
- Es ist eine Entwicklerplattform ohne nennenswerten No-Code-Weg, also bleiben nichttechnische Nutzer ausgeschlossen.
- Preis- und Genauigkeitsaussagen kommen vom Anbieter, und unabhängige Benchmarks sind nicht veröffentlicht.
Häufige Fragen
Es ist eine Gedächtnisschicht für KI-Anwendungen. Sie schicken ihm Dokumente, Datenbanken und Webquellen, und es liefert strukturierte Daten, durchsuchbares Wissen und quellengestützte Agenten-Antworten über eine einzige API.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Query Memory.
Alternativen zu Query Memory

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Knocket
Knocket (Tencent RTC team) · Produktivität · Business · ChatbotKnocket ist ein kostenloses Werkzeug für Live-Chat und Kontaktseite: Besucher schreiben über Ihre Website, Ihre App oder einen Link, und Sie antworten aus Telegram oder einem einzigen Posteingang.

FloorGen
Vinit Kumar (FloorGen) · Produktivität · KI aus ChinaFloorGen ist ein Grundriss-Ersteller im Browser, der aus einem Satz oder einer Skizze einen bearbeitbaren 2D-Plan und einen 3D-Rundgang macht. Export als PDF, DXF oder Video, Zeichnen ohne Konto.