
StepFun
StepFun · Sonstiges · KI aus China
Step 3.5 Flash ist ein Open-Source-Grundlagenmodell von StepFun, gebaut als dünn besetztes Mixture-of-Experts-System (MoE), das pro Token nur 11B seiner 196B Parameter aktiviert. Dieses Design hält das Reasoning stark und treibt die Generierungsgeschwindigkeit auf 100 bis 300 Token pro Sekunde. Wer will schon auf ein langsames Modell warten? Niemand. Als KI-Agent-Modell passt es zu Coding-Assistenten und Arbeit mit langem Kontext, wo die Geschwindigkeit entscheidet, ob Sie das Werkzeug wirklich nutzen.
Über StepFun
Was ist StepFun Step 3.5 Flash
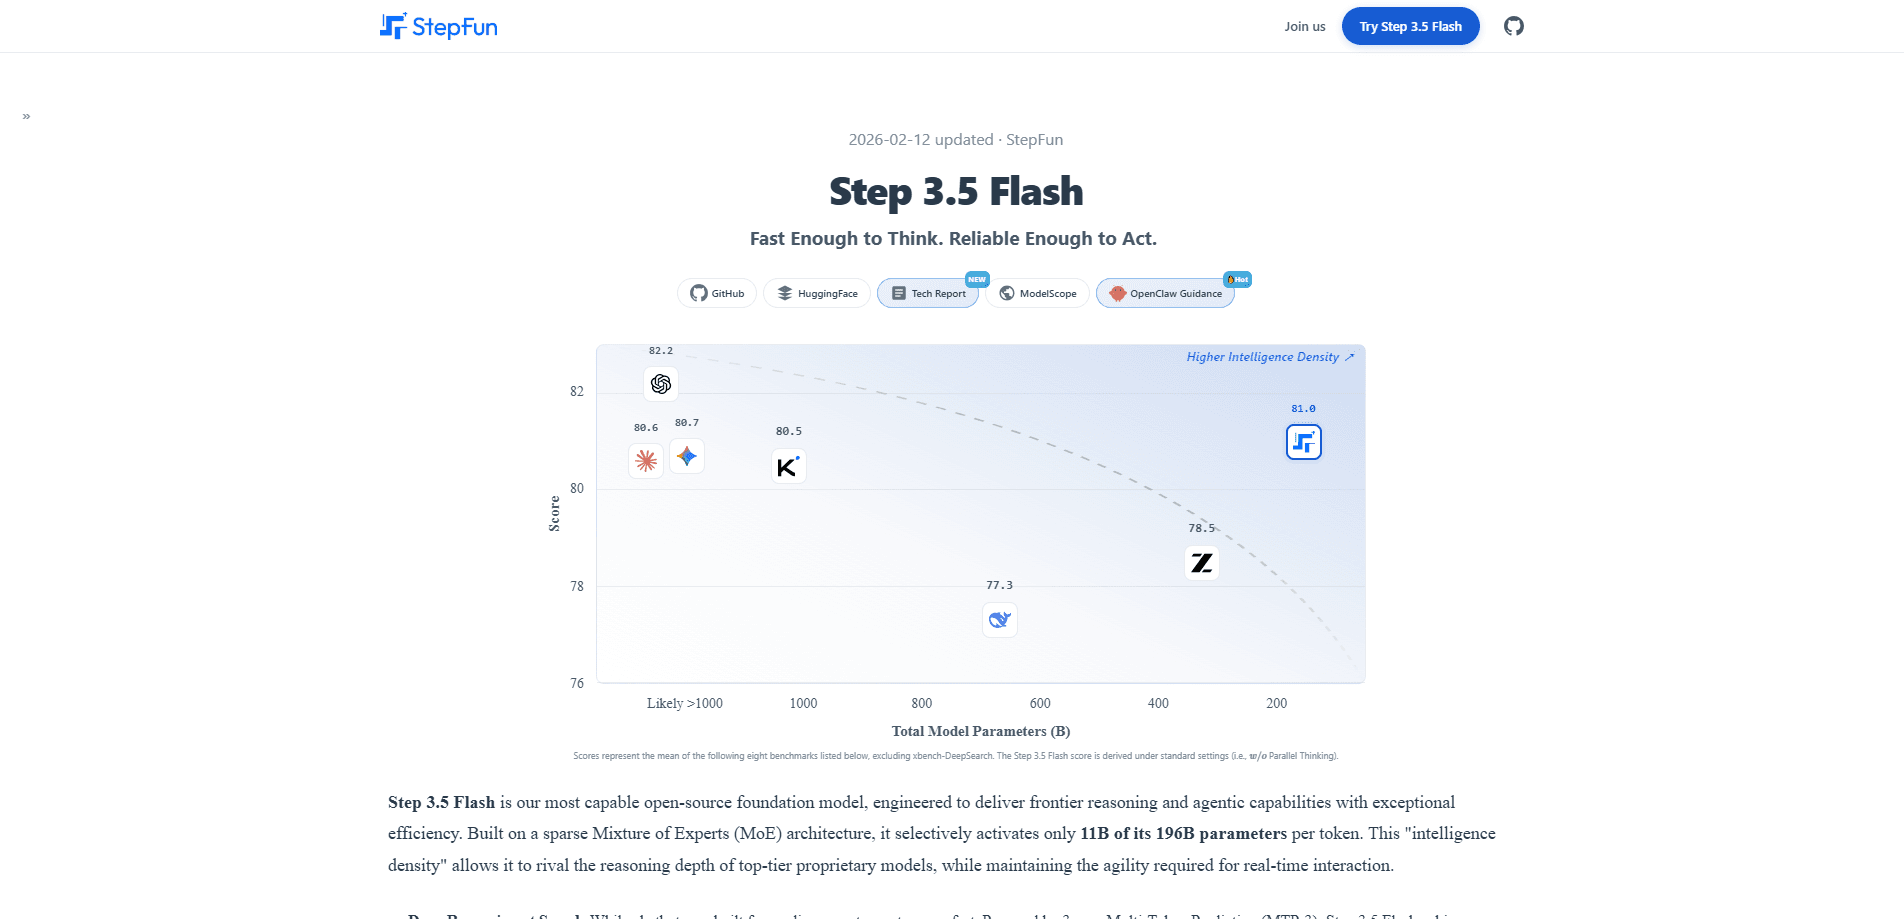
Step 3.5 Flash ist ein textbasiertes KI-Modell, das StepFun als offene Gewichte veröffentlicht hat, sodass jeder die Modelldateien herunterladen und lokal oder über eine Cloud-API ausführen kann. Als Open-Source-KI-Modell ist der Reiz die Effizienz ohne großen Qualitätsverlust. Statt bei jedem Token alle 196B Parameter zu feuern, wählt eine Routing-Schicht den kleinen Teil an Experten, den jeder Token tatsächlich braucht. StepFun nennt das "Intelligenzdichte", und die Zahlen stützen die Aussage: eine Durchschnittsnote von 81,0 über acht Benchmarks, vor mehreren deutlich größeren Modellen im selben Vergleich.
Für Menschen, die Agenten bauen, zählen die praktischen Teile mehr als die Architektur-Folie. Das Modell bewältigt ein Kontextfenster von 256K, kann also eine lange Codebasis oder einen Stapel Dokumente in einem Durchgang halten. Laut StepFun erreicht es 74,4 % bei SWE-bench Verified und 51,0 % bei Terminal-Bench 2.0, also das Ergebnis, das Sie wollen, wenn ein Modell über viele Schritte planen und Werkzeuge aufrufen muss, ohne abzudriften.
Die Grenzen sollte man klar benennen. Die veröffentlichten Benchmark-Zahlen stammen von StepFun selbst. Behandeln Sie sie als Herstellerangaben, bis unabhängige Tests sie bestätigen. Außerdem hat es in dieser Version kein eingebautes Bildverständnis, sodass alles Visuelle von einem separaten Modell erledigt werden muss. Und obwohl es auf High-End-Consumer-Hardware läuft, leistet "High-End" hier echte Arbeit: ein Mac Studio M4 Max oder ein NVIDIA DGX Spark, kein typischer Laptop.
Erste Schritte
- Wählen Sie einen Zugangsweg. Nutzen Sie StepFuns gehostete API für den schnellsten Start, oder holen Sie die offenen Gewichte von GitHub oder ModelScope, wenn Sie es auf Ihrer eigenen Maschine ausführen wollen.
- Holen Sie sich einen API-Schlüssel in der Konsole der StepFun-Plattform, richten Sie Ihren Client auf den OpenAI-kompatiblen Endpunkt (Basis-URL https://api.stepfun.com/v1) und setzen Sie das Modell auf step-3.5-flash.
- Senden Sie eine erste Anfrage über ein beliebiges SDK im OpenAI-Stil, beginnen Sie mit einem kurzen Prompt, um zu prüfen, ob die Verbindung funktioniert.
- Für Agent- oder Coding-Arbeit binden Sie das Modell in Ihre Werkzeugschleife ein und lassen es Funktionen aufrufen oder Code über mehrere Runden ausführen.
- Skalieren Sie. Erhöhen Sie das Kontextfenster für lange Eingaben und wechseln Sie zur lokalen Bereitstellung, wenn Datenschutz Priorität hat.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von StepFun.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die Agenten bauen
- Ingenieure mit Datenschutzbedarf
- Forscher und Bastler
Aufgaben
- Agentisches Coding
- Analyse mit langem Kontext
- Automatisierung mit hohem Durchsatz
Szenarien
- Einen Coding-Agenten über Nacht laufen lassen
- Einen großen Dokumentsatz analysieren
- Einen privaten Assistenten bauen
Wichtigste Funktionen
Dünn besetzte MoE-Architektur mit 11B aktiven Parametern
Step 3.5 Flash hält einen Pool von 196B Parametern, aktiviert aber nur rund 11B pro Token. Kleiner Teil, großes Modell. Das Ergebnis kommt der Geschwindigkeit eines kleinen Modells nahe, mit viel von der Reasoning-Tiefe eines großen, was genau der Kompromiss ist, den Agent-Arbeitslasten brauchen.
Hochgeschwindigkeits-Generierung mit MTP-3
Mit dreifacher Multi-Token-Vorhersage erzeugt das Modell im normalen Einsatz 100 bis 300 Token pro Sekunde, mit Spitzen nahe 350 Token pro Sekunde bei Coding-Aufgaben mit einem einzelnen Stream. Für alle, die auf lange Reasoning-Ketten warten, ist diese Geschwindigkeit der Unterschied zwischen einem Werkzeug, das Sie nutzen, und einem, das Sie meiden.
256K-Kontext mit hybrider Attention
Das Modell kombiniert Sliding-Window-Attention mit voller Attention im Verhältnis 3:1, sodass die meisten Schichten ein lokales Fenster betrachten, während einige die ganze Sequenz abdecken. Das hält die Leistung bei langen Eingaben stabil und senkt zugleich den Rechenaufwand, der sonst mit einem großen Kontextfenster einhergeht.
Starke Coding- und Agent-Benchmarks
Laut StepFun erzielt das Modell 74,4 % bei SWE-bench Verified und 51,0 % bei Terminal-Bench 2.0. Das sind die Tests, die verfolgen, ob ein Modell echte Ingenieursarbeit tatsächlich erledigt, nicht nur Kleinigkeiten beantwortet.
Offene Gewichte und lokale Bereitstellung
Die Modelldateien sind auf GitHub und ModelScope offen, und es läuft auf Hardware wie dem Mac Studio M4 Max, dem NVIDIA DGX Spark und dem AMD AI Max+ 395. Es selbst auszuführen heißt, Ihre Daten bleiben lokal und Sie umgehen die Kosten pro Token ganz.
OpenAI-kompatible API
Der gehostete Endpunkt von StepFun spricht das Format der OpenAI-API, sodass bestehende SDKs und Clients mit einem Wechsel der Basis-URL funktionieren. Auf OpenRouter gibt es zudem eine kostenlose Stufe, mit der Sie Agent-Setups testen können, bevor Sie sich auf bezahlte Nutzung festlegen.
Vor- und Nachteile
Vorteile
- Schnelle Generierung (100 bis 300 tok/s, bis zu 350 beim Coding) passt zu Agenten und interaktiven Werkzeugen.
- Das 256K-Kontextfenster bewältigt große Codebasen und Dokumentsätze in einer Anfrage.
- Offene Gewichte lassen Sie es lokal ausführen und die Daten privat halten.
- Starke veröffentlichte Ergebnisse bei Coding- und Terminal-Benchmarks.
- Die OpenAI-kompatible API hält die Migration von anderen Anbietern einfach.
Nachteile
- Die Benchmark-Zahlen stammen von StepFun, daher ist die unabhängige Überprüfung noch dünn.
- Die lokale Bereitstellung braucht High-End-Hardware, keinen Standard-Laptop.
- Kein eingebautes Bild- oder Multimodalverständnis in dieser Version.
Häufige Fragen
Es ist für Aufgaben gebaut, die schnelles Reasoning und Werkzeugnutzung brauchen, etwa Coding-Agenten, automatisierte Abläufe und Analyse mit langem Kontext. Seine Geschwindigkeit und sein Kontextfenster machen es passend für Pipelines, in denen viele Anfragen nacheinander laufen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu StepFun.
Alternativen zu StepFun

Odyssey 3
Odyssey · SonstigesOdyssey-3 ist Odysseys fundamentales Weltmodell. Es simuliert Physik in Echtzeit, macht aus einer Eingabe eine interaktive Umgebung und lässt sich an Roboter, Autos und Spiele anpassen.

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.