
Thunder Compute
Thunder Compute · Sonstiges
Thunder Compute ist eine serverlose GPU-Cloud für Entwickler. Sie mietet A100- und H100-Instanzen im Minutentakt und startet Sandboxes im Sekundentakt.
Über Thunder Compute
Was ist Thunder Compute
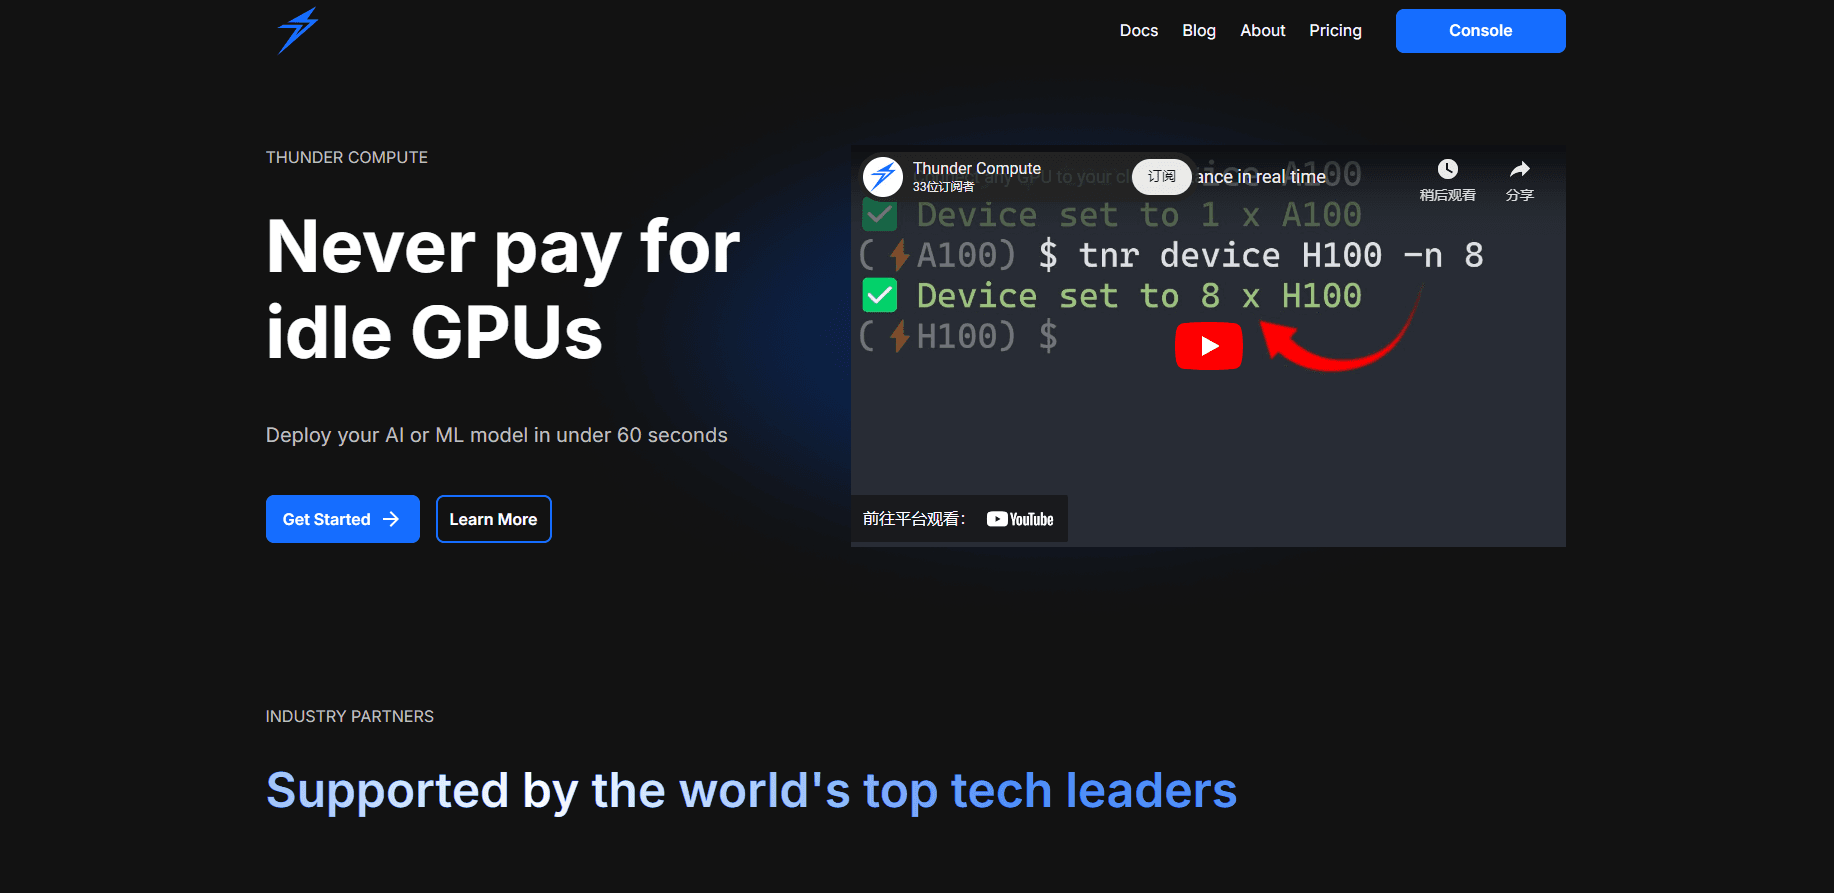
Thunder Compute ist ein Cloud-GPU-Anbieter für alle, die Modelle trainieren, Evaluierungen laufen lassen oder ihre Agenten Rechenleistung verbrauchen lassen. Sie richten keine Maschine Monate im Voraus ein und reservieren kein Rack. Sie fordern eine GPU an, bekommen sie in unter einer Minute, führen Ihren Code aus und hören auf zu zahlen, wenn die Aufgabe endet. Das ist das Versprechen in einem Satz. Keine Warteschlange, keine Leerlauf-Hardware.
Das Unternehmen begann als Forschungslabor für Systeme. Die Gründer lernten sich am Georgia Tech kennen, wo Forschende GPU-Zeit Wochen im Voraus über eine geteilte Tabelle buchten, sodass Experimente stockten, sobald jemand anderes die Reservierung hielt. Dieser Engpass wurde zum Produkt: Thunder Compute virtualisiert GPUs, damit die Hardware beschäftigt bleibt, statt zwischen Reservierungen leerzustehen. Y Combinator unterstützte das Team in seinem Sommer-Batch 2024.
Der Preis für Cloud-GPUs wiegt genauso schwer wie die Technologie. Die meisten Anbieter runden auf die Stunde auf und berechnen die Daten beim Verlassen. Hier nicht. Was spart das nun wirklich? Es hängt davon ab, wie viel Leerlaufzeit Sie derzeit verbrauchen.
Der Dienst teilt sich in zwei Produkte. Instanzen sind dauerhafte GPU-Maschinen, mit denen Sie sich verbinden und die Sie behalten, abgerechnet pro Minute, solange sie laufen. Sandboxes sind kurzlebige, isolierte Aufträge, die Sie mit ein paar Zeilen Python zu Hunderten auffächern können, abgerechnet pro Sekunde. Beide laufen auf derselben Flotte, was zählt, wenn Ihnen daran liegt, dass A100-Miete und die Kapazität der H100-GPU-Cloud verfügbar bleiben, wenn Sie sie brauchen. Die wichtigste Grenze ist der Umfang: Das ist Infrastruktur für Menschen, die bereits programmieren können. Es gibt keinen Drag-and-drop-Baukasten, und wenn Ihr Workload auf eine Laptop-GPU passt, ergibt das Mieten pro Stunde selten Sinn. Wissen Sie, was Sie kaufen.
Erste Schritte
- Registrieren Sie sich in der Konsole und fügen Sie eine Zahlungsmethode hinzu, denn die Abrechnung beginnt in dem Moment, in dem eine GPU startet.
- Wählen Sie einen Editor oder eine Schnittstelle: die VS-Code-Erweiterung, die Kommandozeile, die Webkonsole oder den MCP-Server für Agent-Workflows.
- Erstellen Sie eine Instanz mit einem einzigen Befehl wie
tnr create --gpu a100, oder öffnen Sie eine Sandbox aus Python mit der Bibliothekthunder_sandbox. - Verbinden Sie sich aus VS Code, der CLI oder Ihrem Browser und führen Sie Ihren vorhandenen Code auf der GPU aus.
- Erstellen Sie am Ende einen Snapshot der Festplatte, wenn Sie Ihre Umgebung behalten wollen, und fahren Sie die Instanz dann herunter, um den Zähler zu stoppen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Thunder Compute.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Machine-Learning-Ingenieure
- KI-Forschende, die Evaluierungen fahren
- Startup-Teams mit Blick auf die Reserve
- Agent-Entwickler
Aufgaben
- Modelle trainieren und feinabstimmen
- RL-Umgebungen und Evaluierungen im großen Maßstab fahren
- Kurze, schubweise Aufträge
- Modellcode prototypen
Szenarien
- Ein Forschungslabor, das heute geteilte GPU-Zeit Wochen im Voraus bucht.
- Ein Agent, der während einer langen Denkschleife für ein paar Minuten eine GPU braucht.
- Ein Solo-Entwickler, der prüft, ob ein größeres Modell in seine Pipeline passt, bevor er einen großen Cloud-Vertrag unterschreibt.
Wichtigste Funktionen
Abrechnung pro Minute und pro Sekunde
Instanzen rechnen pro Minute ab, solange sie laufen, und Sandboxes rechnen pro Sekunde ab. Dieser Unterschied zählt: Eine Aufgabe, die in 90 Sekunden endet, kostet 90 Sekunden, nicht eine Aufrundung auf die Stunde. Zusätzliche vCPUs und die Festplatte folgen derselben Uhr, und der Snapshot-Speicher ist der einzige Posten, der separat abgerechnet wird, bis Sie ihn löschen. Leicht zu übersehen. Groß auf der Rechnung.
Instanzen, die Sie behalten und sichern
Eine Instanz ist eine dauerhafte GPU-Maschine, mit der Sie sich verbinden und auf der Sie bleiben. Sie wählen die GPU (RTX A6000, L40, A100 80GB oder H100 SXM), legen vCPUs, RAM und Festplatte fest und erstellen am Ende einen Snapshot der Festplatte. Der Snapshot bewahrt Ihre Umgebung zwischen Läufen, sodass die nächste Sitzung schon konfiguriert startet, statt denselben Abhängigkeitsstapel jedes Mal neu aufzubauen, wenn Sie sich an die Arbeit setzen. Praktisch, wenn ein Setup-Skript länger dauert als die Aufgabe selbst.
GPU-Sandboxes für parallele Arbeit
Sandboxes sind isolierte Aufträge, die hoch- und bis auf null herunterskalieren. Sie starten sie aus Python mit der Bibliothek thunder_sandbox, setzen ein Timeout und fächern Hunderte parallel auf. Jede kann eine eigene GPU tragen oder nur auf CPU laufen für leichtere Aufgaben. Sie werden am Ende gelöscht, was isolierte Umgebungen sauber hält. Für Evaluierungen und bestärkendes Lernen ist genau dieses Auffächern der Punkt. Eine Maschine kommt mit Hunderten Rollouts nicht mit. Dutzende schon.
Mehrere Zugangswege
Sie steuern Thunder Compute über eine VS-Code- oder Cursor-Erweiterung, die Kommandozeile, eine Webkonsole oder einen MCP-Server. Die CLI hält die Einrichtung bei ein paar Befehlen. Der MCP-Server lässt Coding-Agenten selbstständig GPUs anfordern. Wählen Sie die Oberfläche, die zu Ihrer Arbeitsweise passt.
Keine Ausgangsgebühren
Daten, die die Plattform verlassen, kosten nichts. Für Teams, die große Datensätze oder Modell-Checkpoints hinein- und hinausbewegen, ist das oft eine höhere Rechnung als die der GPUs selbst bei anderen Anbietern. Thunder Compute streicht den Posten ganz. Wenn Sie schon einmal einen 200-GB-Checkpoint heruntergeladen und eine Überraschungsgebühr beobachtet haben, werden Sie diesen Punkt schätzen. Kostenlos heißt kostenlos.
Reservierte Kapazität für größere Aufträge
Wenn eine GPU nicht reicht, bietet reservierte Kapazität 8 bis über 512 GPUs mit Rabatt gegenüber dem On-Demand-Preis. Eine A100-Reservierung beginnt bei 1,49 Dollar pro GPU-Stunde gegenüber 1,09 Dollar auf Abruf, und eine reservierte H100 liegt bei 3,20 Dollar pro GPU-Stunde. Sie richtet sich an Teams mit stetigen, großen Trainingsläufen, nicht an gelegentliche Aufträge. Kleine Einzeltests bleiben besser auf Abruf.
Vor- und Nachteile
Vorteile
- Die Abrechnung pro Minute und pro Sekunde bedeutet, dass Sie nur zahlen, solange Workloads wirklich laufen.
- Keine Ausgangsgebühren für Daten, was einen Kostenpunkt beseitigt, der bei großen Modelltransfers schnell steigt.
- Vier Schnittstellen (VS Code, CLI, Konsole, MCP-Server) passen zu unterschiedlichen Workflows, auch zu agentengesteuerten.
- Die Einrichtung braucht einen einzigen Befehl, und eine GPU ist in unter einer Minute bereit.
- Der veröffentlichte Preisvergleich zeigt, dass es Lambda, Runpod und die großen Cloud-Anbieter bei ähnlichen GPUs unterbietet.
Nachteile
- Es gibt keine kostenlose Stufe, Sie können die Plattform also nicht testen, ohne zuerst eine Zahlungsmethode hinzuzufügen.
- Es ist für Entwickler gebaut, die programmieren; eine visuelle No-Code-Oberfläche für nicht-technische Nutzer fehlt.
- Reservierte Multi-GPU-Kapazität beginnt bei 8 GPUs und erfordert den Kontakt zum Vertrieb, was kleine Einzelaufträge ausschließt und den Rabatt schwer erreichbar macht, wenn Sie nicht ohnehin große Trainings-Workloads fahren.
Häufige Fragen
Es mietet Cloud-GPUs für KI-Arbeit: Modelle trainieren und feinabstimmen, Evaluierungen und Umgebungen des bestärkenden Lernens fahren und Agenten Rechenleistung auf Abruf geben. Sie führen Ihren vorhandenen Code auf der GPU aus, statt ihn für die Plattform umzuschreiben.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Thunder Compute.
Alternativen zu Thunder Compute

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.

iFixAi
iFixAi · Business · SonstigesiFixAi ist ein Open-Source-Auditor für KI-Agenten. Er schickt den Agenten durch eine Simulation Ihres Geschäfts, bewertet jede Antwort und liefert eine Bewertung von A bis F mit Belegen.