

W-Okada Voice Changer
w-okada · Stimme & Sprache
W-Okada Voice Changer ist eine kostenlose Open-Source-App, die Ihre Stimme in Echtzeit mit KI unter Windows, macOS und Linux umwandelt.
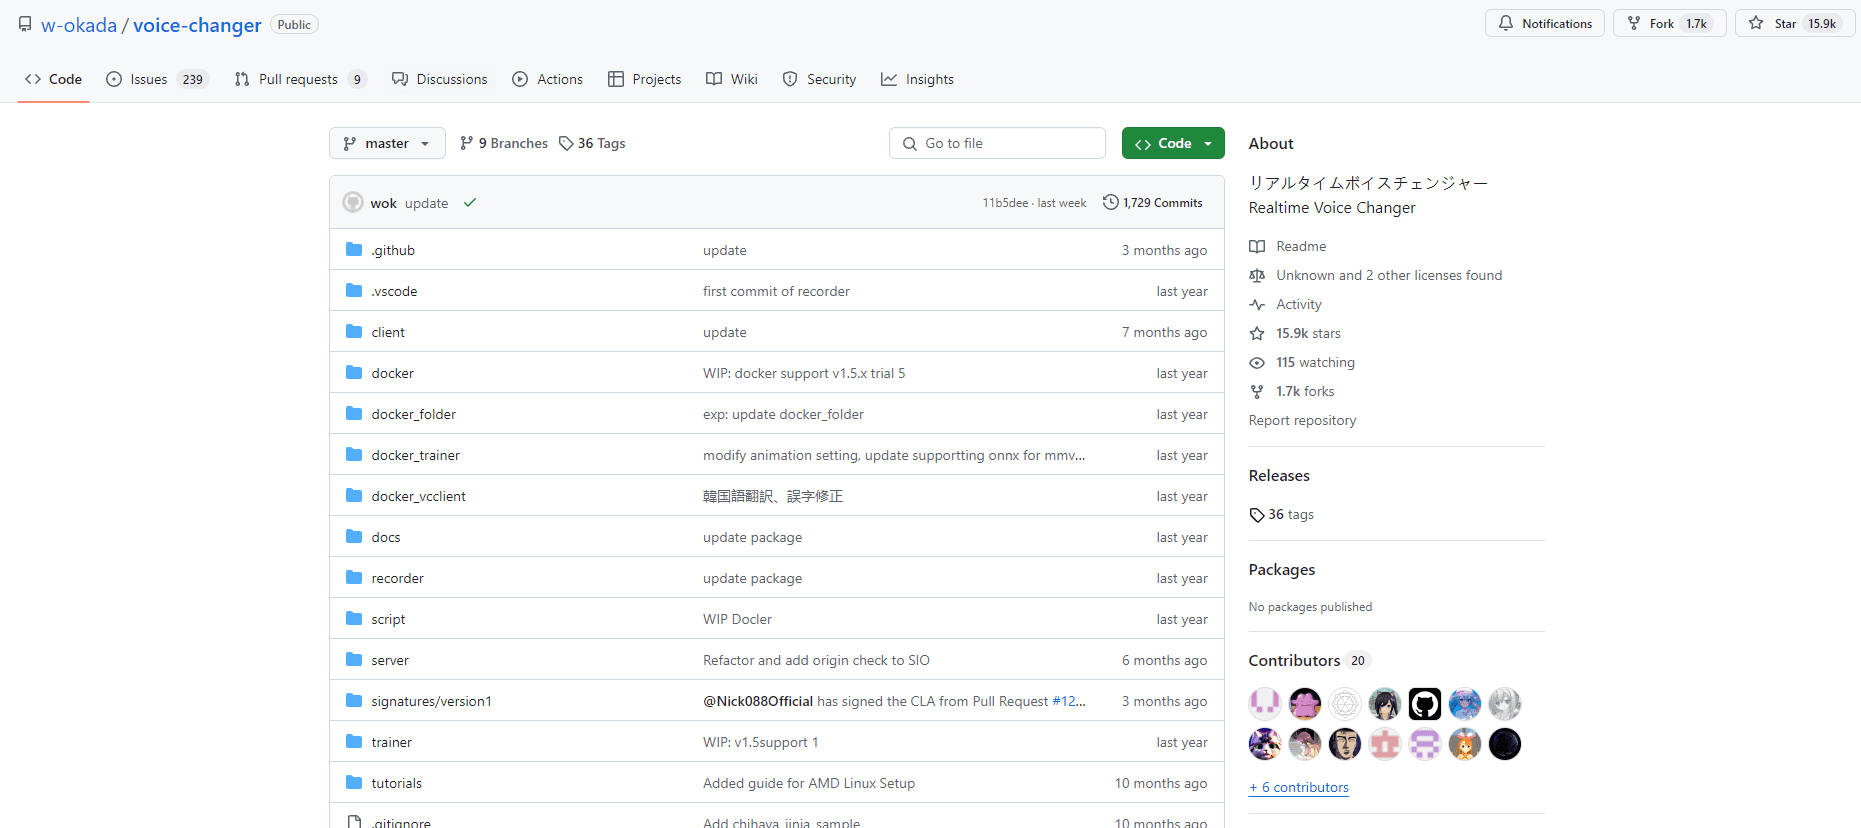
Über W-Okada Voice Changer
Was ist W-Okada Voice Changer
W-Okada Voice Changer, oft VCClient genannt, ist ein Echtzeit-Stimmenverzerrer, der den Klang Ihrer Stimme verändert, während Sie noch sprechen. Sie geben ihm Ihr Mikrofon, wählen ein Ziel-Stimmmodell, und die Software baut Ihr Audio live neu auf, sodass Zuhörer die andere Stimme statt Ihrer hören. Entstanden ist das Projekt in der japanischen Entwickler-Community rund um RVC, ein beliebtes retrieval-basiertes Modell zur KI-Stimmkonvertierung, und seitdem ist die eigene Beatrice-Familie dazugekommen. Wer einen RVC-Stimmenverzerrer ohne Abo sucht, findet hier eine der wenigen ernsthaften Optionen, die offline läuft.
Der größte Reiz liegt darin, dass alles auf Ihrem eigenen Rechner läuft. Ihr Audio geht durch eine lokale Verarbeitung, nicht durch den Server von jemand anderem, was viel bedeutet, wenn Sie in einem Gespräch sind oder etwas aufnehmen, das Sie nicht zu einem Dienst hochladen wollen, den Sie nicht kontrollieren. Dieses lokale Setup ist zugleich die Hürde. Sie brauchen einen Rechner mit ordentlicher GPU oder einem Apple-Silicon-Chip, um die Latenz niedrig genug für den Live-Betrieb zu halten, und je stärker die Konvertierung, desto mehr Rechenleistung frisst sie.
Es ist ein Werkzeug für Bastler, keine App zum Sofort-Loslegen. Zum Einrichten wählen Sie die zu Ihrer Hardware passende Edition, laden Modelldateien herunter und stellen Blockgröße und Tonhöhe so lange ein, bis die Verzögerung stimmt. Wer schon einmal Desktop-Software zum Stimmenändern genutzt hat, findet sich schnell zurecht.
Erste Schritte
- Prüfen Sie Ihre Plattform und wählen Sie eine Release-Edition: std für Windows, macOS (M1) und Linux; cuda oder onnx unter Windows, wenn Sie auch RVC-Unterstützung wollen.
- Laden Sie den Build aus dem Hugging-Face-Repository des Projekts herunter (Windows und M1-Mac), oder klonen Sie unter Linux das GitHub-Repository.
- Starten Sie die App und wählen Sie Ihr Eingabegerät (Mikrofon) und Ausgabegerät.
- Laden Sie ein Stimmmodell und stellen Sie Blockgröße, Tonhöhe und Formant ein, bis die Live-Konvertierung gut klingt.
- Leiten Sie das umgewandelte Audio in Ihren Sprachchat, Ihr Streaming-Programm oder Ihr Aufnahmetool weiter.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von W-Okada Voice Changer.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Streamer und VTuber
- Synchronsprecher und Hobbyisten
- Datenschutzbewusste Anrufer
Aufgaben
- Stimme live in Anrufen und Streams verschleiern
- Charakterstimmen üben
- Experimentelle Audioprojekte
Szenarien
- Einen Gaming-Stream mit markanter Stimme fahren
- Eine Podcast-Demo unter Pseudonym aufnehmen
- Verstehen, wie sich Stimmkonvertierungsmodelle verhalten
Wichtigste Funktionen
Echtzeit-Stimmkonvertierung
Der Kern von W-Okada Voice Changer ist die Umwandlung Ihres Live-Mikrofonsignals auf der Stelle. Wählen Sie ein Modell, und die App baut jeden Audioblock neu auf, während Sie sprechen. Die Latenz hängt von Ihrer Hardware und den Blockeinstellungen ab, aber auf fähigen Rechnern ist sie knapp genug für Gespräche, Streaming und Live-Anrufe.
Mehrere KI-Modelle, darunter RVC und Beatrice
Das Projekt unterstützt mehr als eine Konvertierungs-Engine. RVC ist der langjährige Favorit der Community, während Beatrice das eigene Modell des Entwicklers ist, inzwischen in v2. Welche Modelle Sie fahren können, hängt von Ihrer Edition ab: std-Builds meistern Beatrice, während cuda- und onnx-Builds RVC ergänzen. Dieser Unterschied lohnt einen Blick vor dem Download.
Lokale Verarbeitung ohne Daten-Upload
Alles läuft auf Ihrem eigenen Computer. Ihre Stimme muss Ihren Rechner nie verlassen, um umgewandelt zu werden, ein echter Vorteil für alle, die private Anrufe oder unveröffentlichtes Audio bearbeiten. Der Haken: Sie stellen die Hardware, die die Schwerarbeit leistet, also einen Rechner mit genug GPU- oder Apple-Silicon-Leistung, damit das Audio ohne Ruckeln fließt.
Regler für niedrige Latenz
Blockgröße, Tonhöhe und Formant lassen Sie etwas Stimmqualität gegen Geschwindigkeit tauschen, oder umgekehrt. Das ist der Unterschied zwischen einer Stimme, die eine halbe Sekunde hinterherhängt, und einer, die in einem normalen Hin und Her mithält. Das richtig hinzubekommen braucht ein paar Durchläufe.
Plattformübergreifende Releases
Die App gibt es für Windows, macOS und Linux. Linux-Nutzer klonen das Repository, während Windows- und M1-Mac-Nutzer fertige Builds aus dem Hugging-Face-Repo des Projekts holen. Es gibt separate Editionen für unterschiedliche Hardware, Sie sind also nicht auf einen Weg festgelegt.
Integrierte Unterstützung für Modelltraining
Beatrice bringt eigenen Trainingscode mit, verfügbar sowohl als Repository als auch als Google-Colab-Notebook. So können Sie ein eigenes Stimmmodell bauen, statt nur auf die öffentlichen zu setzen. Das ist mehr Arbeit, öffnet aber Stimmen, die Sie anderswo nicht finden.
Integrierte Audio-Geräteverwaltung
Die App übernimmt die Auswahl von Ein- und Ausgabegeräten direkt, sodass Sie die umgewandelte Stimme in Ihr übriges Setup einbinden. Wählen Sie Mikrofon und Ausgabe, und schicken Sie das Ergebnis dann an eine Chat-App, ein Streaming-Programm oder einen Recorder. Kleinigkeit, aber sie erspart das Gefummel mit virtuellen Kabeln.
Vor- und Nachteile
Vorteile
- Kostenlos und Open Source, ohne Abo oder Nutzungsgebühren.
- Läuft komplett auf eigener Hardware, Ihre Stimmdaten bleiben also privat.
- Unterstützt mehrere Konvertierungsmodelle, darunter RVC und Beatrices des Entwicklers.
- Läuft unter Windows, macOS und Linux mit eigenen Builds.
- Der Trainingscode für Beatrice lässt Sie eigene Stimmmodelle erstellen.
Nachteile
- Braucht eine fähige GPU oder einen Apple-Silicon-Chip für latenzarmen Live-Betrieb; schwächere Rechner geraten ins Stocken.
- Die Einrichtung ist technisch: Editionswahl, Modell-Downloads und manuelles Feintuning.
- Keine öffentliche API, also lässt es sich nicht wie ein gehosteter Dienst in automatisierte Abläufe einbinden.
- Die Dokumentation stützt sich auf die Community, und einige Builds sind als Beta oder experimentell gekennzeichnet.
Häufige Fragen
Ja. Es ist ein Open-Source-Projekt unter einer offenen Lizenz, Download und Nutzung kosten also nichts. Sie brauchen nur Hardware, die stark genug ist, um es auszuführen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu W-Okada Voice Changer.
Alternativen zu W-Okada Voice Changer

Off the Record
Weird Machines · Stimme & Sprache · ProduktivitätOff the Record ist eine macOS-App von Weird Machines. Sie verändert Ihre Stimme in Echtzeit und blockiert so die KI-Transkription: Menschen hören Sie normal, Notiztools bekommen nichts Verwertbares.
Cekura Bench
Cekura · Stimme & Sprache · BusinessCekura Bench ist ein öffentlicher Benchmark, der Speech-to-Speech-Modelle und eingesetzte Voice-Agents durch 82 simulierte Telefonate schickt, jedes dreimal, und Erfolgsquote, Latenz und Kosten pro Minute veröffentlicht.
Griffin by Tavus
Tavus · Stimme & Sprache · Video · ChatbotGriffin by Tavus ist das erste Modell für menschliche Interaktion: ein Full-Duplex-System von Video zu Video, das in einem KI-Videoanruf in Echtzeit beobachtet, zuhört und antwortet.