
ZeroGPU
ZeroGPU.ai · Produktivität
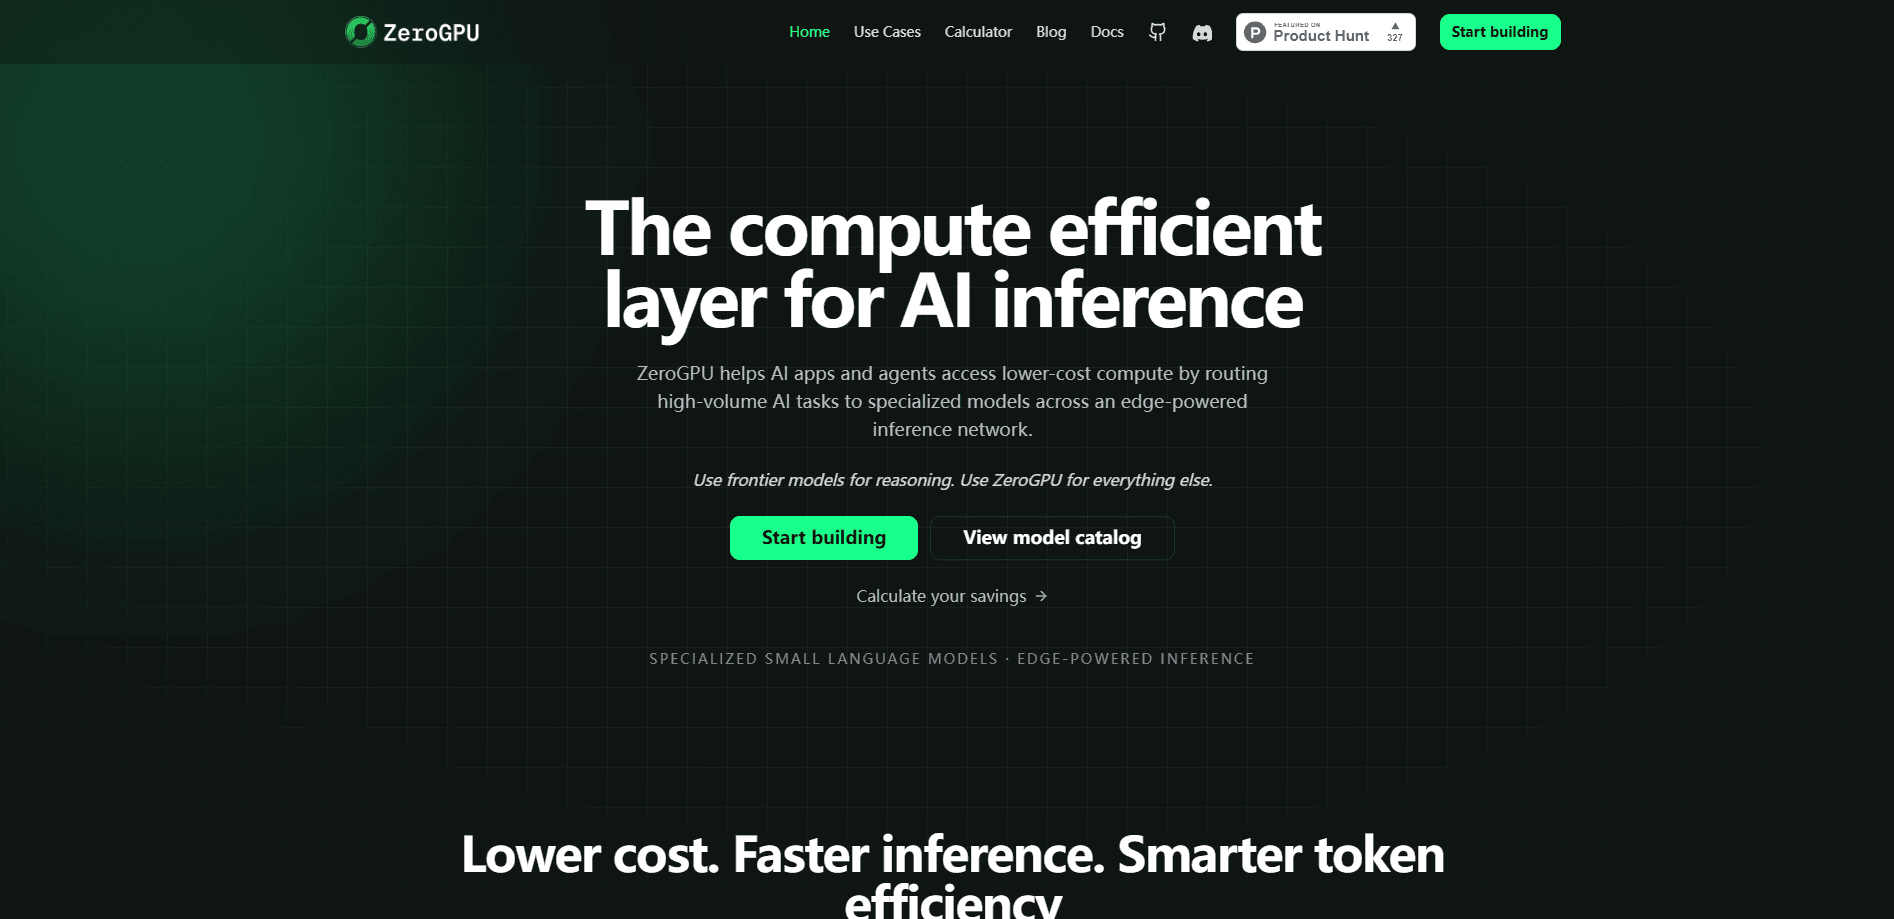
ZeroGPU ist eine Edge-KI-Inferenzplattform, die KI-Workloads mit hohem Volumen auf spezialisierten kleinen und offenen Modellen ausführt statt auf teuren Frontier-GPUs. Sie zielt auf die repetitiven Aufgaben, die den größten Teil des Produktionsverkehrs ausmachen, etwa das Sortieren von Support-Tickets, das Markieren von Spam und die KI-Inhaltsmoderation. Das Versprechen ist simpel. Sie zahlen weniger pro Aufruf. Weil sie eine OpenAI-kompatible API bereitstellt, schieben Teams sie in eine bestehende Pipeline und zahlen pro Token, was Inferenz mit niedriger Latenz in Produktionsmaßstab bezahlbar macht.
Über ZeroGPU
Was ist ZeroGPU
ZeroGPU ist die Effizienzschicht für Rechenleistung bei der KI-Inferenz. Die Idee dahinter ist nüchtern: Die meisten KI-Workloads brauchen kein Frontier-Modell. Ein Support-Ticket zu sortieren oder einen Spam-Kommentar zu markieren erfordert nicht dieselbe Denkleistung wie das Lösen eines mehrstufigen Programmierproblems. ZeroGPU leitet diese wiederkehrende Arbeit an kleine und Nano-Sprachmodelle weiter und führt sie dann über ein Netzwerk von Edge-Geräten statt über zentrale GPUs aus. Das Unternehmen nennt 50 bis 70 % niedrigere Inferenzkosten gegenüber traditionellen GPU-Clouds und bis zu 10-fach schnellere Inferenz bei spezialisierten Workloads. Es weist aber darauf hin, dass die Leistung je nach Workload, Modell und Konfiguration schwankt.
Das Hauptproblem, das die Plattform löst, ist wirtschaftlicher Natur. Wenn Sie Frontier-Preise zahlen, um Millionen von Elementen zu klassifizieren, wächst die Rechnung mit dem Volumen so stark, dass es schnell weh tut. Kleinere Modelle auf Edge-Hardware senken Kosten und Latenz für die fokussierten Aufgaben, die den Produktionsverkehr dominieren. Der Kompromiss ist die Fähigkeit. ZeroGPU ist nicht für komplexes Denken, Langkontext-Analyse oder offene Generierung gebaut. Das bleibt Frontier-Modellen vorbehalten. ZeroGPU steht daneben und übernimmt die Ausführungsschicht mit hohem Volumen.
Noch eine Grenze, die man kennen sollte: Die Plattform setzt auf offene Modelle, die Qualität der Ausgabe hängt also vom konkreten Modell ab, dem ein Workload zugeordnet wird, und Sie bekommen nicht die gleiche Flexibilität wie bei einem vollständig angepassten Modell. Neuere oder Nischenaufgaben haben womöglich noch kein passendes kleines Modell.
Erste Schritte
- Registrieren Sie sich auf der ZeroGPU-Plattform und finden Sie Ihren API-Schlüssel und Ihre Projekt-ID im Dashboard.
- Richten Sie einen bestehenden OpenAI-SDK-Client auf
https://api.zerogpu.ai/v1, oder senden Sie eine Anfrage mit den Headernx-api-keyundx-project-id. - Wählen Sie aus dem Modellkatalog das passende Modell für Ihre Aufgabe, etwa eine Variante für Klassifizierung oder Moderation.
- Senden Sie Ihre erste Anfrage an den responses-Endpunkt und prüfen Sie, ob die Ausgabe zu Ihrer Pipeline passt.
- Bringen Sie den Aufruf in die Produktion und verfolgen Sie die Nutzung gegen das Guthaben Ihres Tarifs.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von ZeroGPU.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend- und ML-Entwickler
- KI-Produktteams
- Startups mit engen Margen
Aufgaben
- Weiterleitung von Support-Tickets
- Inhaltsmoderation
- Datenextraktion
- Sentiment-Analyse
Szenarien
- Täglich eine Batch-Klassifizierung über ein großes Set von Elementen laufen lassen
- Kundenprofile mit Lead-Scoring und Verhaltenssignalen anreichern
- Nutzergenerierte Inhalte vor der Veröffentlichung prüfen
Wichtigste Funktionen
OpenAI-kompatible API
ZeroGPU stellt einen OpenAI-kompatiblen Endpunkt unter https://api.zerogpu.ai/v1 bereit. Wenn Sie schon das OpenAI-SDK nutzen, können Sie es auf ZeroGPU richten und den größten Teil Ihres Codes behalten. Die Authentifizierung läuft über die Header x-api-key und x-project-id statt über das übliche Bearer-Token. Das ist eine kleine Konfigurationsänderung, keine Neuentwicklung. Genau diese Funktion macht die Einführung in bestehende Pipelines günstig. Weniger Reibung, schnellerer Wechsel.
Spezialisierte kleine und Nano-Modelle
Die Plattform ordnet jedem Workload ein kleines oder Nano-Modell zu, das für die Aufgabe gewählt wurde. Ein eigenes Modell für Klassifizierung oder Extraktion kann ein größeres Allzweckmodell bei dieser fokussierten Arbeit schlagen, und läuft dabei günstiger und schneller. Ein Modellkatalog lässt Sie das richtige auswählen, und das System übernimmt das Routing im Hintergrund. Das richtige Modell für die richtige Aufgabe.
Edge-basiertes Inferenznetzwerk
ZeroGPU führt Workloads über ein Netzwerk von Edge-Geräten aus statt über einen einzelnen zentralen GPU-Cluster. Das Unternehmen nennt über 100.000 Edge-Geräte und begründet damit die niedrige Latenz in Produktionsmaßstab. Warum ist das wichtig? Bei wiederkehrenden Aufgaben verkürzt die räumliche Nähe der Rechenleistung zur Anfrage die Umlaufzeit.
Ersparnis bei Kosten und Latenz
Die Kernaussage lautet 50 bis 70 % niedrigere Inferenzkosten gegenüber traditionellen GPU-Clouds und bis zu 10-fach schnellere Inferenz bei spezialisierten Workloads. Übersetzt: günstig und schnell. Das Unternehmen stellt klar, dass die Ergebnisse je nach Workload, Modell und Konfiguration schwanken, die Zahlen sind also eine erste Erwartung, keine Garantie. Ein Ersparnisrechner auf der Website lässt Sie die Wirkung schätzen, bevor Sie sich festlegen. Für KI-Inhaltsmoderation und Massenklassifizierung rechnet sich die Plattform genau hier.
Breite Abdeckung von Anwendungsfällen
Der Katalog der Anwendungsfälle reicht von Klassifizierung der Werbeabsicht über E-Mail-Triage, Inhaltsmoderation, Support-Automatisierung, Datenanreicherung, Übersetzung in über 100 Sprachen, Personalisierung, Dokument-OCR, Betrugserkennung, PII-Schwärzung, Jailbreak-Erkennung bis zu multimodaler Inferenz. Diese Bandbreite zählt, weil sie zeigt, dass die Plattform auf die Ausführungsschicht vieler verschiedener Produkte zielt, nicht auf eine Nische.
Agentenfreundlicher Einkauf
ZeroGPU verkauft direkt an KI-Agenten. Ein Agenten-Storefront veröffentlicht Preise und Zahlungshinweise, und ein Agent kann eine Anmeldedaten registrieren und einen Tarif kaufen, ohne Anmeldeablauf und ohne menschlichen Schritt. Zahlungen laufen per Wallet über x402 oder MPP ab, oder per Karte mit menschlicher Hilfe. Ein ungewöhnliches Setup, das auf autonome Pipelines zielt.
Vor- und Nachteile
Vorteile
- Die OpenAI-kompatible API macht die Migration für Teams, die schon das OpenAI-SDK nutzen, zu einer Konfigurationsänderung.
- Der Preis pro Token lässt die Kosten mit dem tatsächlichen Verbrauch wachsen statt mit festen GPU-Reservierungen.
- Die angegebene Kostensenkung von 50 bis 70 % und die Latenzgewinne bis 10-fach zielen auf die Aufgaben mit hohem Volumen, die den Produktionsverkehr dominieren.
- Agenten-Storefront und autonomer Einkauf passen zu automatisierten Pipelines, die nicht auf eine menschliche Anmeldung warten können.
- Ein breiter Katalog von Anwendungsfällen deckt Moderation, Klassifizierung, Extraktion, OCR und Übersetzung ab.
Nachteile
- Kleine und offene Modelle erreichen Frontier-Modelle weder beim komplexen Denken noch bei Langkontext-Arbeit, also brauchen Sie dafür weiterhin einen zweiten Anbieter.
- Die Ersparniszahlen schwanken je nach Workload und Konfiguration, echte Gewinne brauchen also Ihre eigene Messung, bevor Sie sich festlegen.
- Die Ausgabequalität hängt davon ab, welchem kleinen Modell eine Aufgabe zugeordnet wird, was die Flexibilität bei ungewöhnlichen Aufgaben einschränkt.
- Die Authentifizierung über eigene Header weicht vom üblichen Bearer-Ablauf ab, daher brauchen manche SDK-Integrationen eine Anpassung.
Häufige Fragen
ZeroGPU führt KI-Aufgaben mit hohem Volumen und Wiederholungen auf kleinen und Nano-Modellen über ein Edge-Netzwerk aus. Typische Arbeiten sind Klassifizierung, Inhaltsmoderation, Datenextraktion, Übersetzung und die Weiterleitung von Support-Tickets. Es ist für die Ausführungsschicht einer Pipeline gebaut, nicht für komplexes Denken.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu ZeroGPU.
Alternativen zu ZeroGPU

Base Code
Base44 (Wix) · Coding · ProduktivitätBase Code ist eine geteilte Cloud-Entwicklungsumgebung von Base44. Das Team beschreibt Änderungen an einem bestehenden GitHub-Repository im Chat, prüft sie in der Vorschau und reicht sie als Pull Request ein.

Knocket
Knocket (Tencent RTC team) · Produktivität · Business · ChatbotKnocket ist ein kostenloses Werkzeug für Live-Chat und Kontaktseite: Besucher schreiben über Ihre Website, Ihre App oder einen Link, und Sie antworten aus Telegram oder einem einzigen Posteingang.

FloorGen
Vinit Kumar (FloorGen) · Produktivität · KI aus ChinaFloorGen ist ein Grundriss-Ersteller im Browser, der aus einem Satz oder einer Skizze einen bearbeitbaren 2D-Plan und einen 3D-Rundgang macht. Export als PDF, DXF oder Video, Zeichnen ohne Konto.