
Mnexium AI
Mnexium · チャットボット
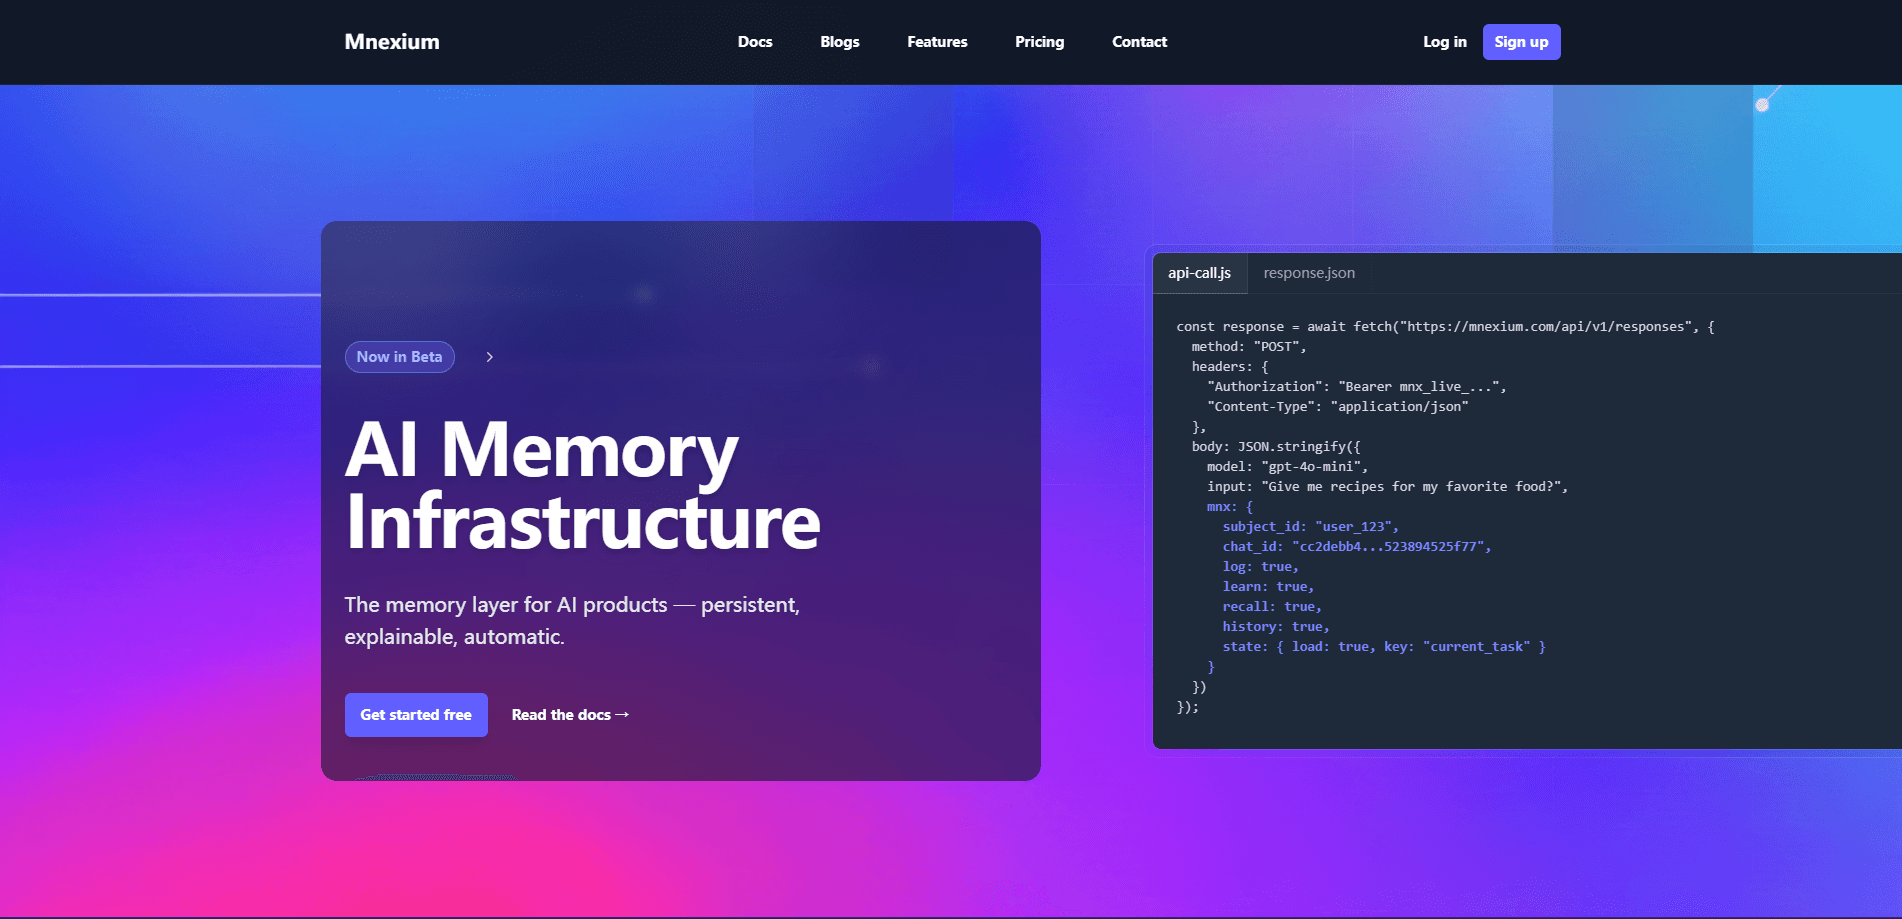
Mnexium AIは、およそ2行のコードでAIアプリとエージェントに永続メモリを追加するAIメモリ基盤プラットフォームだ。AIメモリAPIと考えればいい。アプリケーションとモデルの間に立ち、チャット履歴、AIエージェント向け長期メモリ、構造化コンテキストを毎回のリクエストに注入する。OpenAI、Anthropic、Geminiのモデルと単一のエンドポイントで動く。
Mnexium AI について
Mnexium AIとは何か
Mnexium AIはLLMアプリとエージェントのためのメモリ層だ。ほとんどのAIプロダクトはセッションが終わるとすべて忘れる。新しい会話は毎回ゼロから始まる。Mnexiumはこれを解決する。エージェントがユーザーについて学んだ内容を保存し、次のリクエストで返す。自前のデータベースとオーケストレーション基盤を組む必要はない。サービスとしてまとめた、LLMアプリ向けの永続メモリだ。
プラットフォームはコンテキストを4つのシステムに分ける。現在の会話のチャット履歴、ユーザーに関する長期的な事実のエージェントメモリ、複数ステップのタスク進捗のエージェント状態、チケットやアカウントのようなスキーマで裏付けられたエンティティのレコードだ。それぞれを history: true や recall: true といったフラグで有効にすると、Mnexiumがモデル向けの最終プロンプトを組み立てる。
最大の制約は、Mnexiumが開発者向けである点だ。ドラッグ&ドロップのビルダーはない。ノンコーダー向けのチャットUIもない。コードを編集し、APIキーを接続することに慣れている必要があり、料金は利用量に応じて上がる。高トラフィックのアプリではコストが膨らみやすい。
はじめかた
- Mnexiumのサイトで登録する。または、基本的なAPIテストなら登録不要の無料プランから始める。
- Node.jsなら
npm install @mnexium/sdk、Pythonならpip install mnexiumでクライアントライブラリをインストールする。 - クライアントを初期化し、学習・recall・履歴のオプションをクライアント単位で一度設定する。
- ユーザーごとにサブジェクトを作成し、リクエストで
process()を呼ぶ。Mnexiumがメモリとコンテキストを自動で組み立てる。 - ログとrecallイベントを開き、あるリクエストでどんなメモリが保存・注入されたかを正確に確認する。
AIツール情報
Mnexium AIの料金、対応プラットフォーム、性能を簡単に確認できます。
こんな人におすすめ
このツールが最も力を発揮するユーザー、タスク、シーン。
ユーザー
- 初めてのAIアシスタントを作る個人開発者:無料プランは約100ユーザーと月10,000リクエストをカバーし、請求なしで動くプロトタイプを出せる。
- 本番アプリを運用する小規模プロダクトチーム:月29ドルのBuilderプランは数千ユーザーと月250,000リクエストを処理する。データベースを立てずにローンチできる。
- 高トラフィックなプラットフォームのエンジニアリング責任者:月149ドルのGrowthプランは200万リクエストにわたる安定したトラフィックを支え、メモリ操作が急増したときは優先サポートが付く。
タスク
- チャットボットに過去の会話を記憶させる:Mnexiumがユーザーごとに事実と好みを抽出し、次のセッションで recall する。
- 複数ステップのエージェントワークフローを再開する:エージェント状態がタスクの進捗と保留中のアクションを追跡するので、中断した作業は続きから再開できる。
- AIアプリ内で構造化データを管理する:レコードはアカウントやチケットのようなスキーマで裏付けられたエンティティを保存し、自由形式のメモリと並んで検索と更新に対応する。
シーン
- 顧客の過去チケットを覚えているサポートボット:レコードとメモリが組み合わさり、エージェントはまっさらな状態ではなくコンテキスト付きで顧客に挨拶する。
- 開発者のスタックと好みを思い出すコーディングアシスタント:保存された事実はチャットをまたぎ、モデルプロバイダーをまたいでも残る。
- モデルスタックの切り替え:OpenAI、Anthropic、Geminiの間で移行するチームも、subject_idが同じままであれば同じメモリを保つ。
主な機能
2行のコードで永続メモリ
Mnexiumは既存のアプリを置き換えるのではなく、組み込むために作られている。cURLやHTTP呼び出しに mnx オブジェクトを加えるか、Node.jsとPython向けの公式SDKを使う。それだけだ。この小さな変更が長期メモリを有効にし、LLMアプリは独自のベクトルデータベースなしでユーザーをセッションをまたいで記憶する。
コンテキスト管理のための4つのシステム
プラットフォームはコンテキストをチャット履歴、エージェントメモリ、エージェント状態、レコードに分ける。それぞれ独立して動く。セッション単位の継続性を長期メモリに触れずに保ち、ユーザーの事実を汚さずにタスク状態を保存できるコンテキスト管理APIだ。分けておくことが、同じAPIでパーソナライズされたチャットと決定的なデータワークフローの両方を扱える理由だ。
設計からモデル非依存
MnexiumはOpenAIのChat CompletionsとResponses API、Anthropic、GoogleのGeminiにルーティングし、1つのプロバイダーに縛らない。subject_idを同じに保てば、メモリとレコードはプロバイダーをまたいで使える。モデルは好きなときに切り替えられる。エージェントのメモリはリセットされない。
事実とレコードの自動抽出
learn: true を設定すると、プラットフォームが会話から事実と好みを自分で引き出す。レコードはさらに進む。records.learn を auto か force にすると、Mnexiumが対話から構造化エンティティを抽出する。抽出プロンプトを自分で書かずにきれいなデータが得られる。
決定的なプロンプト組み立て
すべてのリクエストは固定の順序を通る。システムプロンプト、エージェント状態、メモリ、レコード、チャット履歴、そしてあなたのメッセージだ。順序が予測できるので、モデルが何を見るかを正確に推論できる。ログ、トレース、recallイベントが何を注入したか、なぜかを示すので、デバッグは推測よりはるかに楽だ。
組み込みの可観測性
Mnexiumはすべてのステップでログとrecallイベントを公開する。どのメモリが取得され、どのレコードが更新され、モデルがどんなプロンプトを受け取ったかを調べられる。AIメモリ機能を出すチームにとって、この可視性は「出荷する」と「手探りで出荷する」の差になる。
メリットとデメリット
メリット
- 永続メモリは全面的な作り直しではなく、小さなコード変更で手に入る。
- 1つのAPIがOpenAI、Anthropic、Geminiをまたぐので、モデルを替えてもメモリはリセットされない。
- 無料プランが本当に使える。基本のAPIアクセスは登録すら不要だ。
- レコードとエージェント状態は、純粋なベクトルメモリでは届かない構造化ワークフローをカバーする。
- ログとrecallイベントが、モデルが実際に見たものを明確にする。
デメリット
- ビジュアルビルダーがないので、ノンコーダーは開発者がそばにいないと使えない。
- コストはリクエストとメモリ操作に応じて増え、大規模アプリでは積み上がる。
- プロダクトのメモリを外部APIに結びつけると、スタックに依存が1つ増える。
よくある質問
MnexiumはAIアプリとエージェントにメモリとコンテキストを加える。アプリはいくつかの mnx オプションを付けた通常のAPIリクエストを送り、Mnexiumが履歴、長期メモリ、エージェント状態、レコードを取得してから、モデル向けの強化されたプロンプトを組み立てる。
関連コンテンツ
Mnexium AIに関連するツール、スキル、記事を探す。
Mnexium AIの代替ツール

Knocket
Knocket (Tencent RTC team) · 生産性向上 · ビジネス · チャットボットKnocketは無料のライブチャット兼コンタクトページだ。訪問者はウェブサイト、アプリ、共有リンクから書き込み、こちらはTelegramか一つの受信トレイから返信する。
Agibot
Agibot · 生産性向上 · AIアシスタント · チャットボットAgibotはMac向けパーソナルAIエージェントだ。ウィンドウを閉じても動き続け、定時ルーティンを実行し、自分のAPIキーでTelegramやSlackから指示できる。

Melete
Melete · 生産性向上 · AIアシスタント · チャットボットMeleteはチーム向けAIワークスペースだ。エージェントがSlack、Notion、Linear、GitHubで調査し、下書きを書き、作業を実行する。共有メモリと承認の仕組みが人間の関与を保つ。