OpenAI가 GPT-6 제품군에 솔(Sol)과 루나(Luna)를 추가했다. 아스트라 아래 두 자리를 채우는 모델이며, 가격은 GPT-5.6 대비 절반 수준이다.
세 개로 늘어난 GPT-6 라인업
2026년 9월 22일, OpenAI는 GPT-6 솔과 GPT-6 루나를 공개했다. 지난 9월 3일에 나온 GPT-6 아스트라가 최고 성능을 맡고 있었다면, 이번 두 모델은 그 아래 자리를 메운다. 아스트라 하나로는 감당하기 어려웠던 반복 작업과 대량 처리를 겨냥한 구성이다.
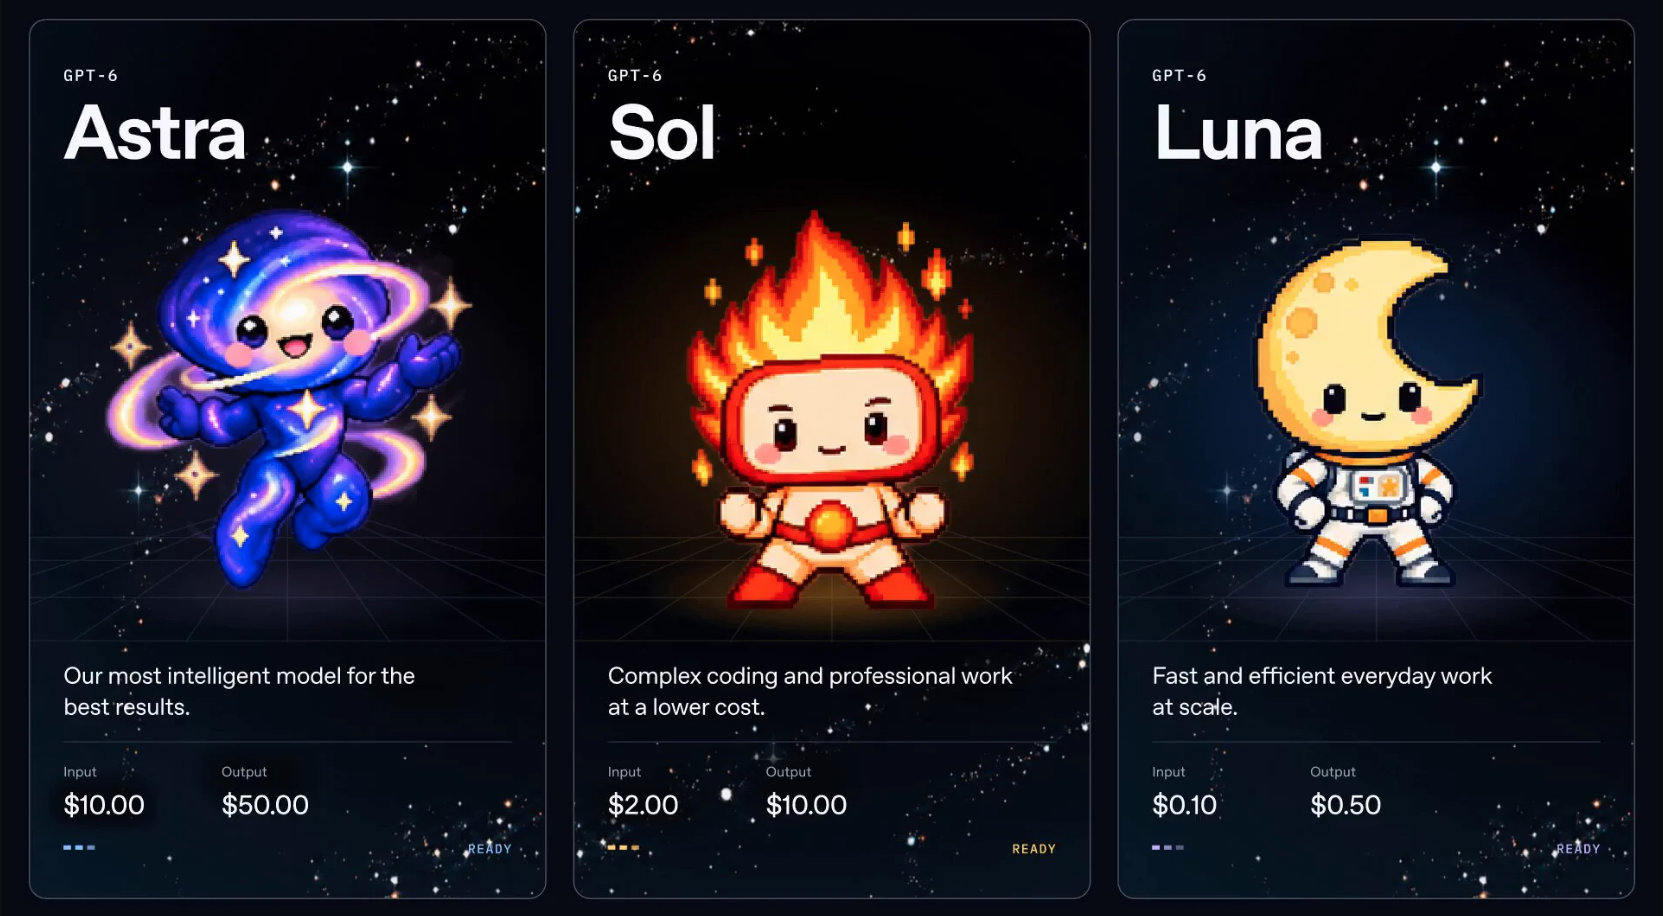
OpenAI가 밝힌 세 모델의 역할은 이렇게 나뉜다.
- GPT-6 아스트라: 결과의 품질이 비용보다 중요한, 가장 어려운 작업
- GPT-6 솔: 복잡한 전문 업무와 코딩, 에이전트 작업에서 성능과 비용을 함께 보는 작업
- GPT-6 루나: 같은 요청을 수없이 반복해야 하는, 비용에 민감한 작업
눈에 띄는 건 새 모델이 두 개 늘었다는 사실 자체보다, GPT-6 라인업의 경쟁 축이 "얼마나 강한가"에서 "강한 모델을 얼마나 싸게 돌릴 수 있는가"로 옮겨갔다는 점이다.
가격이 절반으로 내려갔다
먼저 숫자부터 보자. 100만 토큰당 API 가격은 다음과 같다.
모델 | 입력 | 출력 |
|---|---|---|
GPT-6 솔 | $2 | $10 |
GPT-6 루나 | $0.10 | $0.50 |
직전 세대와 비교하면 인하 폭이 분명하다. GPT-5.6 솔은 프로모션 기준 입력 $4, 출력 $20이었고 루나는 $0.20과 $1.20이었다. OpenAI는 이번 가격이 일회성 할인 프로모션이 아니라 정식 확정 가격이라고 설명했다.
한 번 묻고 답을 받는 식이라면 토큰 가격 차이가 크게 와닿지 않을 수 있다. 하지만 코딩 에이전트가 저장소를 읽고, 코드를 고치고, 테스트를 돌리고, 실패 원인을 확인한 뒤 다시 고치는 과정을 여러 번 반복하면 이야기가 달라진다. 문맥과 출력 토큰이 계속 쌓이기 때문이다. 에이전트 환경에서는 답변 한 번의 값보다 "충분히 좋은 모델을 몇 번이나 반복 실행할 수 있는가"가 더 중요하다.
솔은 어디에 놓이는 모델인가
OpenAI의 업무 자동화 평가인 오토메이션벤치(AutomationBench)에서 GPT-6 솔은 최고 추론 수준(xhigh) 설정으로 33.2%를 기록했다. 같은 평가에서 아스트라는 낮은 추론 수준(low)으로 30.3%였고, 작업당 비용은 솔 xhigh가 아스트라 low의 약 3.9분의 1 수준이었다.
경쟁 모델과 나란히 놓으면 차이가 더 벌어진다. 클로드 오퍼스 5 맥스는 26.9%를 기록했는데, 작업당 비용은 솔의 11.1배로 집계됐다.
이 수치를 모든 업무에 그대로 적용할 수는 없다. 평가마다 쓰는 도구와 실행 환경이 다르고, OpenAI 스스로도 자사 모델의 벤치마크 결과가 실제 ChatGPT나 Codex 환경과 다를 수 있다고 밝히고 있다. 그럼에도 솔의 자리는 읽힌다. 아스트라가 여전히 "가능한 최고 결과"를 위한 모델이라면, 솔은 높은 추론 수준을 충분히 쓰면서도 반복 실행 비용을 감당하려는 작업을 겨냥한다.
코딩에서는 점수 차이보다 비용 차이가 크다
실제 저장소에서 장시간 소프트웨어 엔지니어링 문제를 푸는 DeepSWE 1.1에서 GPT-6 솔은 68.8%, GPT-6 루나도 66.6%를 기록했다. 최상위 모델과의 점수 차이는 크지 않다. 문제는 그 격차를 메우는 값이다.
OpenAI가 함께 제시한 비교에 따르면, 루나는 최고 수준 경쟁 모델과 비교해 작업당 비용이 93~96% 낮다. 루나의 점수가 압도적으로 높아서가 아니라, 거의 비슷한 수준의 결과를 훨씬 적은 비용으로 낸다는 뜻이다.
강점이 뚜렷한 쪽
- 솔: 복잡한 전문 업무, 코딩, 에이전트 작업에서 성능과 비용의 균형
- 솔: 최고 추론 수준을 켰을 때 상위권 성능을 유지
- 루나: 반복 처리량이 많은 작업에서 비용 효율
주의할 쪽
- 루나: 아주 어려운 장기 지식 작업에서는 점수가 낮아질 수 있음
- 모든 수치: OpenAI가 직접 돌린 자체 평가로, 외부 검증은 아직 없음
환각과 사실성은 어떻게 달라졌나
사용자 피드백을 바탕으로 한 OpenAI의 내부 사실성 평가에서 GPT-6 솔은 이전 세대 대비 오류 발생 비율을 절반으로 줄였다. 아스트라 수준에 근접한 결과다. 루나는 높은 추론 수준으로 돌렸을 때 이전 세대 솔과 비슷한 성능을 100분의 1 수준의 비용으로 낸다고 OpenAI는 밝혔다.
챗GPT에서는 어떻게 쓰이나
솔과 루나는 챗GPT 플러스, 프로, 비즈니스, 엔터프라이즈 등 유료 요금제에서 제공된다. 개발자를 위한 프롬프트 캐싱도 개선됐다. GPT-6에서는 기본 캐시 적중률을 높였고, 캐시된 입력 토큰에는 90% 할인이 적용된다. 같은 지시문을 반복해서 보내는 업무라면 토큰 단가 인하와 캐싱 할인이 겹쳐 체감 비용이 더 줄어든다.
무엇을 보면 될까
세 모델 중 무엇을 고를지는 작업의 성격이 정한다. 최고 품질이 필요하면 아스트라, 복잡한 전문 업무와 코딩에서 균형을 원하면 솔, 같은 요청을 대량으로 반복한다면 루나가 자연스러운 출발점이다.
그렇다면 이 세 모델을 어떻게 나눠 써야 할까? 답은 하나로 정해져 있지 않다. 파이프라인 안에서 무거운 판단은 아스트라나 솔에, 단순 반복은 루나에 배치하는 식으로 조합하는 편이 현실적이다.
다만 지금 나온 벤치마크는 대부분 OpenAI가 직접 돌린 결과라는 점을 기억해 두자. 독립 평가 기관이 같은 조건에서 어떤 수치를 내놓는지가 다음 확인 지점이다.