GPT-6 솔과 루나는 같은 제품군에서 나왔지만 토큰 단가가 20배 차이다. 무엇이 이 차이를 만드는지, 어디서 갈리는지 정리했다.
한눈에 보는 두 모델
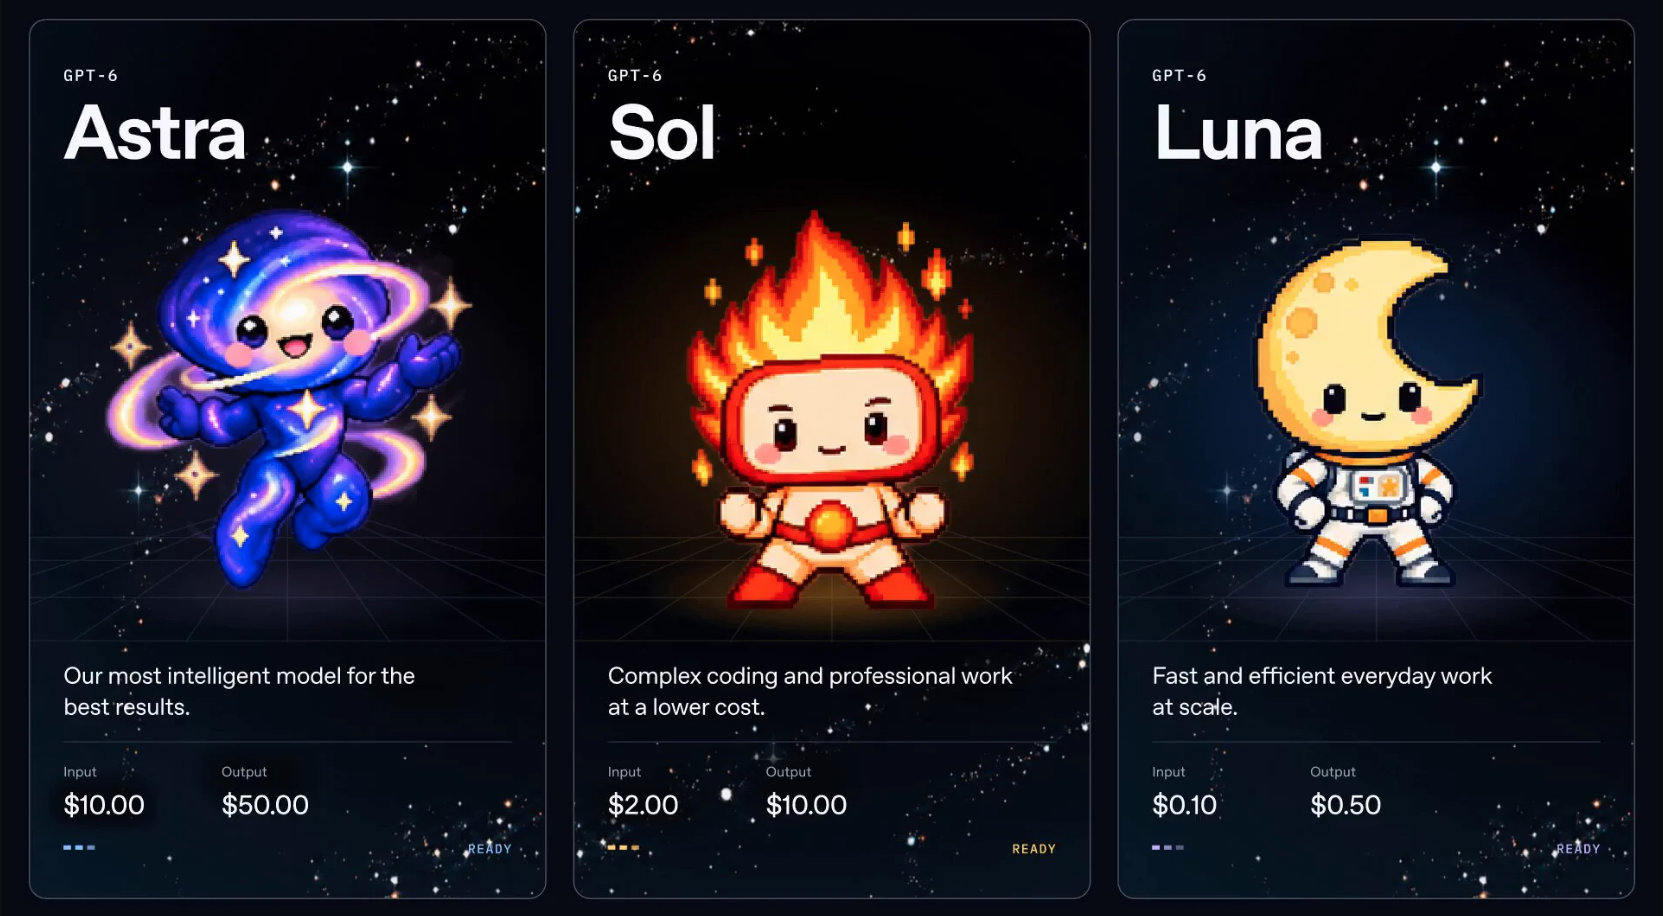
이름만 보면 형제 모델처럼 보인다. 실제로는 쓰이는 자리가 꽤 다르다. GPT-6 솔은 복잡한 전문 업무와 코딩을, 루나는 반복 처리량이 많은 작업을 겨냥한다.
항목 | GPT-6 솔 | GPT-6 루나 |
|---|---|---|
입력 가격 (100만 토큰) | $2 | $0.10 |
출력 가격 (100만 토큰) | $10 | $0.50 |
오토메이션벤치 (xhigh) | 33.2% | OpenAI가 별도 수치 공개 |
딥SWE 1.1 (xhigh) | 68.8% | 66.6% |
겨냥하는 작업 | 복잡한 전문 업무·코딩·에이전트 | 대량 반복·비용 민감 작업 |
20배 차이는 어디서 오나
솔의 토큰 단가는 루나의 20배다. 이 숫자만 보면 루나가 압도적으로 유리해 보이지만, 단가와 실제 청구액은 다른 이야기다.
두 모델의 차이는 "한 번의 답변을 얼마에 파는가"가 아니다. 어느 수준의 추론을 몇 번 반복할 수 있는가의 차이다. 솔은 최고 추론 수준을 켜고 여러 단계를 거치는 작업에서 성능을 유지하도록 설계됐다. 루나는 같은 요청을 대량으로 돌리는 쪽에 맞춰져 있다. 단가 20배는 이 설계 차이가 숫자로 드러난 결과에 가깝다.
에이전트 환경에서는 이 차이가 더 벌어진다. 저장소를 읽고, 코드를 고치고, 테스트하고, 실패 원인을 확인해 다시 고치는 과정이 반복되면 문맥과 출력 토큰이 계속 누적된다. 작업 한 건당 실제 지출은 토큰 단가표보다 훨씬 복잡하게 결정된다.
벤치마크에서 갈리는 지점
오토메이션벤치. 업무 자동화 흐름을 평가하는 이 항목에서 솔은 최고 추론 수준으로 33.2%를 기록했다. OpenAI가 함께 제시한 클로드 오퍼스 5 맥스는 26.9%였고, 솔의 작업당 비용은 그 9% 수준인 $0.27로 집계됐다. 점수가 앞서면서 값은 훨씬 적게 나온 셈이다.
딥SWE 1.1. 실제 저장소에서 장시간 소프트웨어 엔지니어링 문제를 푸는 평가다. 솔은 68.8%, 루나는 66.6%를 기록했다. 두 모델의 점수 차이는 2.2%포인트다. 이 좁은 격차가 비용에서는 어떻게 벌어지는지가 이 비교의 핵심이다. 같은 평가에서 루나는 최고 수준 경쟁 모델 대비 작업당 비용이 93~96% 낮다고 OpenAI는 밝혔다.
솔이 유리한 지점
- 최고 추론 수준에서 성능을 유지해야 하는 작업
- 여러 도구를 함께 쓰는 복잡한 에이전트 흐름
- 결과 품질이 비용보다 중요한 단계
루나가 유리한 지점
- 같은 요청을 수없이 반복하는 처리량 작업
- 분류, 검증, 보조 에이전트 같은 대량 호출
- 어려운 장기 지식 작업이 아닌 실무 반복 업무
판단을 가르는 숫자는 결국 작업당 비용
토큰 단가표만 보면 솔이 20배 비싸다. 그런데 벤치마크 결과를 보면 솔이 앞서는 항목에서도 작업당 비용은 오히려 낮게 나오는 경우가 있다. 추론 수준을 어떻게 쓰느냐에 따라 같은 모델이라도 결과와 값이 크게 달라지기 때문이다.
여기서 주의할 점이 있다. 위 수치는 대부분 OpenAI가 직접 설계하고 돌린 평가에서 나왔다. 평가마다 쓰는 도구와 실행 환경이 다르고, OpenAI 스스로도 벤치마크 결과가 실제 ChatGPT나 Codex 환경과 다를 수 있다고 밝히고 있다. 독립 평가 기관이 같은 조건에서 어떤 값을 내놓는지는 아직 확인되지 않았다.
어떤 작업에 무엇을 쓸까
두 모델 중 하나가 다른 하나보다 낫다고 말할 수 있는 영역은 좁다. 기준은 작업의 성격이다.
여러 단계를 거치며 판단이 필요한 복잡한 코딩, 그리고 결과 품질이 중요한 전문 업무라면 솔의 최고 추론 수준이 맞는다. 반대로 같은 요청을 수천 번 반복하는 분류나 검증, 보조 에이전트 작업이라면 루나가 비용 부담을 크게 줄여준다.
두 모델을 함께 쓰는 방식도 있다. 무거운 단계는 솔로, 반복 단계는 루나로 나누면 전체 파이프라인 비용을 관리하면서 품질을 지킬 수 있다. 그렇다면 둘 중 하나만 골라야 할까? 꼭 그럴 필요는 없다. 어느 쪽이 좋은지보다 어떤 작업을 어디에 배치하느냐가 실제 비용과 결과를 가른다.