
Aeneas
Google DeepMind, with the University of Nottingham, Warwick and Oxford · 其他
Aeneas 是 DeepMind 的開源 AI 模型,能修復破損的拉丁銘文,並預測其年代、出土地與最相近的文本對照。
關於 Aeneas
What Is Aeneas
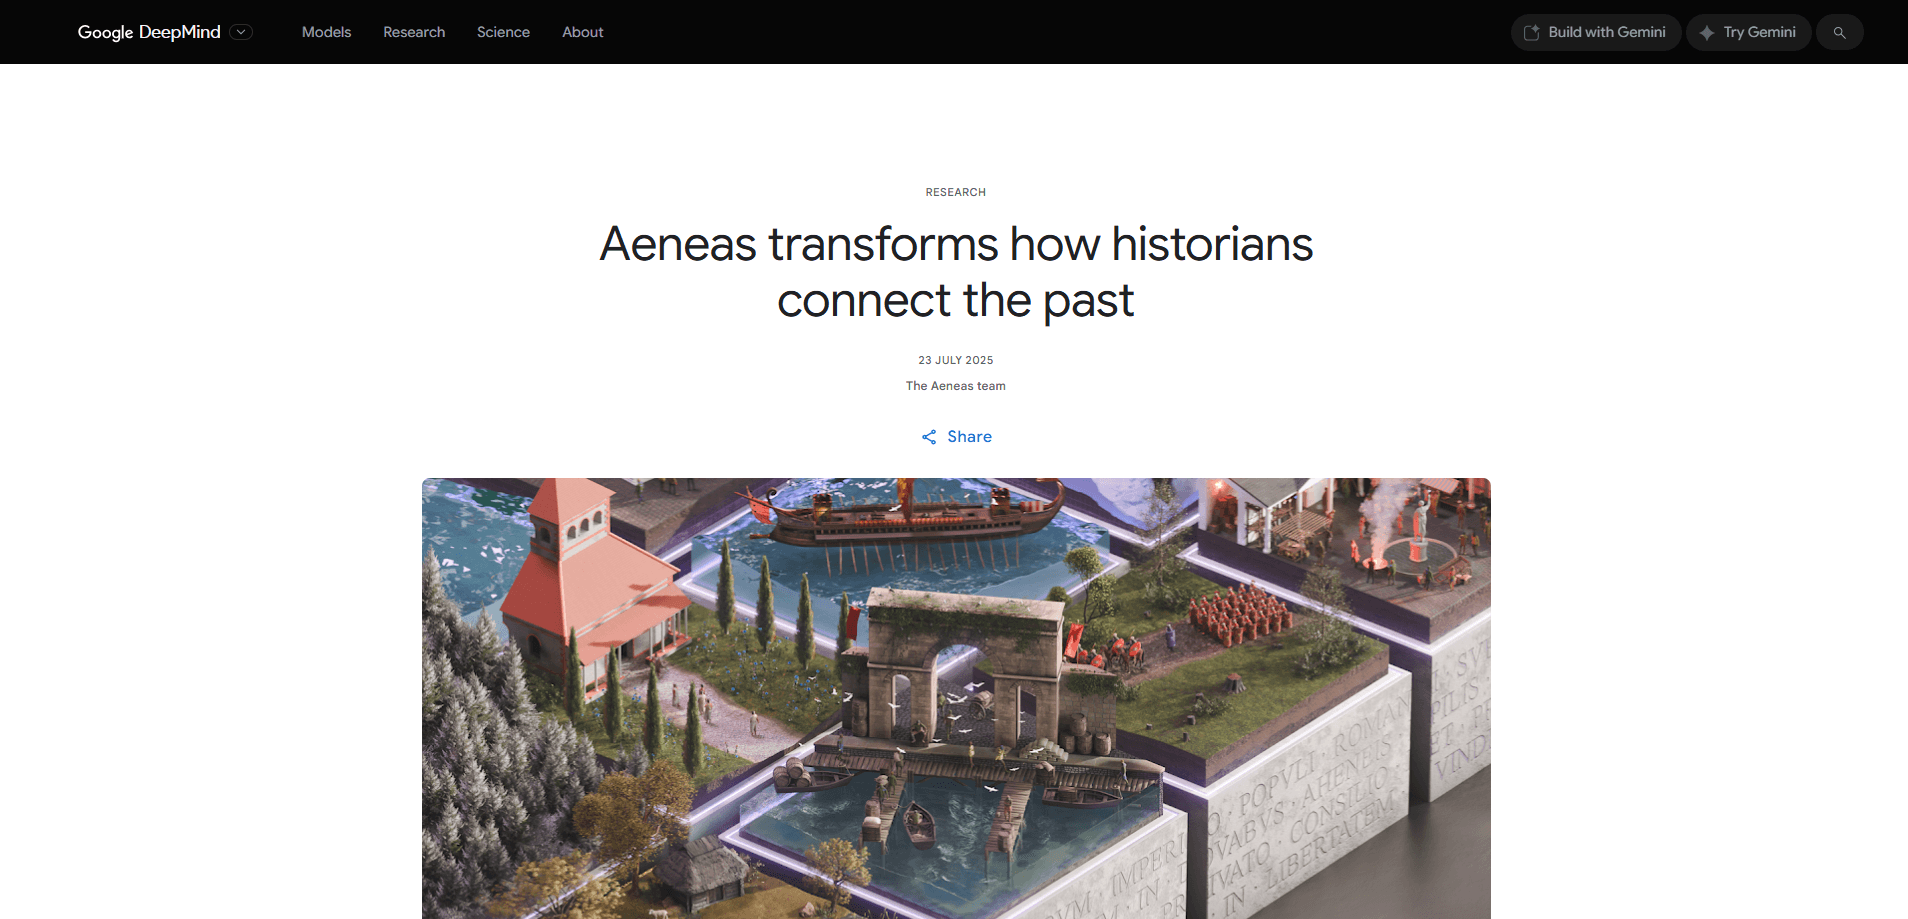
Aeneas 是 Google DeepMind 與諾丁漢、華威、牛津三所大學的歷史學者合作開發的生成式神經網路。它閱讀古代文本,主要是刻在石頭、青銅與陶器上的拉丁銘文,協助研究者把這些文字放回更完整的歷史脈絡。團隊在 2025 年 7 月於《Nature》發表成果,並把程式碼與資料集以開源方式釋出。
它做的事,說到底就是搜尋與修補。當一塊銘文出土時已經破碎或風化,史學家通常得翻遍工具書,找出那些用語、格式或背景相近的對照文本。這道搜尋要花上幾天,還得看學者能取得哪些藏書。Aeneas 把它自動化:為每段文字建立團隊所稱的「歷史指紋」,再從超過 17.6 萬筆拉丁銘文的語料庫中挑出最相關的對照。實際上,等於把一大片銘文學收進一個可以提問的模型裡。
有兩個限制會影響使用方式。Aeneas 以拉丁文訓練,公開的數字只適用這個語言;團隊表示這套方法可以套用到其他語言、文字與載體。另外它是研究工具,不是成品。你得透過程式碼、示範網站或筆記本執行,所以最好有一點 Python 底子,或願意照著安裝說明一步步做。
Getting Started
- 打開 predictingthepast.com 的互動示範,或到 Google DeepMind 的專案頁面看論文與相關連結
- 在 GitHub 上複製 predictingthepast 專案,照說明安裝模型與資料集
- 輸入一段字元序列,用標記標出已知長度與未知長度的缺口,若手上有銘文圖片也一併提供
- 檢視修復後的文字、依相關度排序的對照銘文,以及年代與出土地預測,留下經得起檢驗的結果
產品資訊
快速了解 Aeneas 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 古典文獻與上古史研究者:閱讀拉丁銘文,希望在定調讀法前先拿到對照文本與年代或出土地建議
- 考古與博物館人員:處理新出土或尚未發表的銘文,需要快速判斷一塊殘片大概是什麼
- 數位人文研究者:正在建語料庫與工具,想要一個已訓練好的模型,能改用到其他文字
- 學生與教師:想了解拉丁銘文怎麼修復與斷代,手邊卻沒有完整的研究藏書
任務
- 文本修復:補回銘文缺漏的字元或段落,不論缺口長度是否已知
- 出土地判定:用文本本身與圖片,縮小一段文字出自哪個羅馬行省
- 年代判定:把銘文放進研究者給定的短時間範圍內
- 對照檢索:找出與破損文本共用措辭、格式或脈絡的其他銘文
- 語料研究:觀察某個格式或措辭在數千筆銘文中如何變化
情境
- 一塊風化的祭壇殘片出土卻不知來源:Aeneas 提出可能的讀法、行省與年代區間,替第一份報告指路
- 博物館籌備展覽:館員用對照文本說明一塊青銅殘片在羅馬生活中的位置
- 論文需要更扎實的年代:研究者把提出的年代拿去對照模型給的區間與排序最高的對照文本
- 跨領域團隊研究冷門文字:以新語料重新訓練這套方法,測試它能走多遠
主要功能
任意長度的文本修復
Aeneas 能補回缺漏的字元,也能處理沒人知道長度的缺口,比只能處理固定長度缺口的早期模型更進一步。團隊指出,修復缺十個字元以內的銘文,準確率約 73%。對破損文本來說,這可能把一塊讀不通的殘片變成可用的史料。
對照文本檢索
模型把每筆銘文轉成歷史指紋,再從超過 17.6 萬筆拉丁銘文中找出最接近的對象。這些對照共用措辭、功能或文化背景,遠超出舊工具提供的字面比對。這是史學家最倚賴的功能,因為脈絡正是讓殘片產生意義的關鍵。
多模態出土地判定
Aeneas 是同類模型中第一個同時用文字與圖片推測銘文產地的模型。一個輕量視覺網路會連同文字一起讀取灰階圖片,對出土地判定的準確度尤其有幫助。團隊指出,它能把文本歸入 62 個羅馬行省之一,準確率約 72%。
年代判定
只要研究者給出時間範圍,Aeneas 能把可能年代縮到約 13 年內。這很要緊,因為碳定年在石頭與金屬上派不上用場,學者往往只能靠風格與格式斷代。範圍收窄之後,要把文本對上歷史事件與其他出土文物就容易多了。
大型開放拉丁語料庫
模型以 Latin Epigraphic Dataset 訓練,這個資料集彙整超過 17.6 萬筆銘文、約 1600 萬個字元,來源包括 Epigraphic Database Roma 與 Epigraphic Database Heidelberg。DeepMind 釋出資料集與程式碼,團隊可以研究、稽核,或用自己的材料重新訓練。
人機協作的研究流程
團隊找來 23 位史學家,用真實銘文測試 Aeneas,涵蓋公元前七世紀到公元八世紀。史學家認為它提供的脈絡建議約九成有用,在關鍵任務上的信心提升 44%。在文本修復與出土地判定上,人搭配模型的表現勝過模型或史學家單獨作業。
優缺點
優點
- 模型與資料集開源,研究者能檢視、重新訓練並延伸
- 能處理長度未知的缺口,舊的修復工具做不到
- 除了文字也用銘文圖片,是第一款拿圖片做出土地判定的模型
- 有《Nature》同儕審查論文與史學家實測研究撐腰
- 透過示範網站、程式碼或 Colab 筆記本都能免費使用
缺點
- 以拉丁文訓練,公開的準確率只適用該語言,其他文字目前仍屬研究階段的說法
- 是研究工具而非產品,安裝需要一定的 Python 與程式基礎
- 提供的是對照與年代建議,不是證明某種讀法,史學家仍得自行判斷結果
- 沒有公開 API 也沒有定價,因為專案以程式碼而非服務形式發布
常見問題
Aeneas 是 Google DeepMind 的開源 AI 模型,協助史學家處理古代文本,主要是拉丁銘文。它能修復破損文字、建議年代與出土地,並找出與你正在研究的銘文最相近的其他銘文。團隊在 2025 年 7 月於《Nature》發表。
相關內容
探索與 Aeneas 相關的工具、技能與文章。
Aeneas 替代方案

Odyssey 3
Odyssey · 其他Odyssey-3 是 Odyssey 的基礎世界模型,能即時模擬物理,把一段文字提示變成可互動的環境,並套用到機器人、汽車與遊戲上。

JarvisCore
Prescott Data · 程式設計 · 生產力 · 其他JarvisCore 是開源的 Python 執行環境,讓 AI 代理在網格上以對等節點運作、從共用帳本認領任務,並透過零信任代理服務存取外部系統。
Clef
Cloudflare · 商業 · 其他Clef 是 Cloudflare 推出、可在 Workers AI 上執行的開源決策模型。它針對設定好的題目回傳校準後的機率而非生成文字,讓代理程式快速分類、分流並採取行動。