
關於 AI Diplomacy
What Is AI Diplomacy
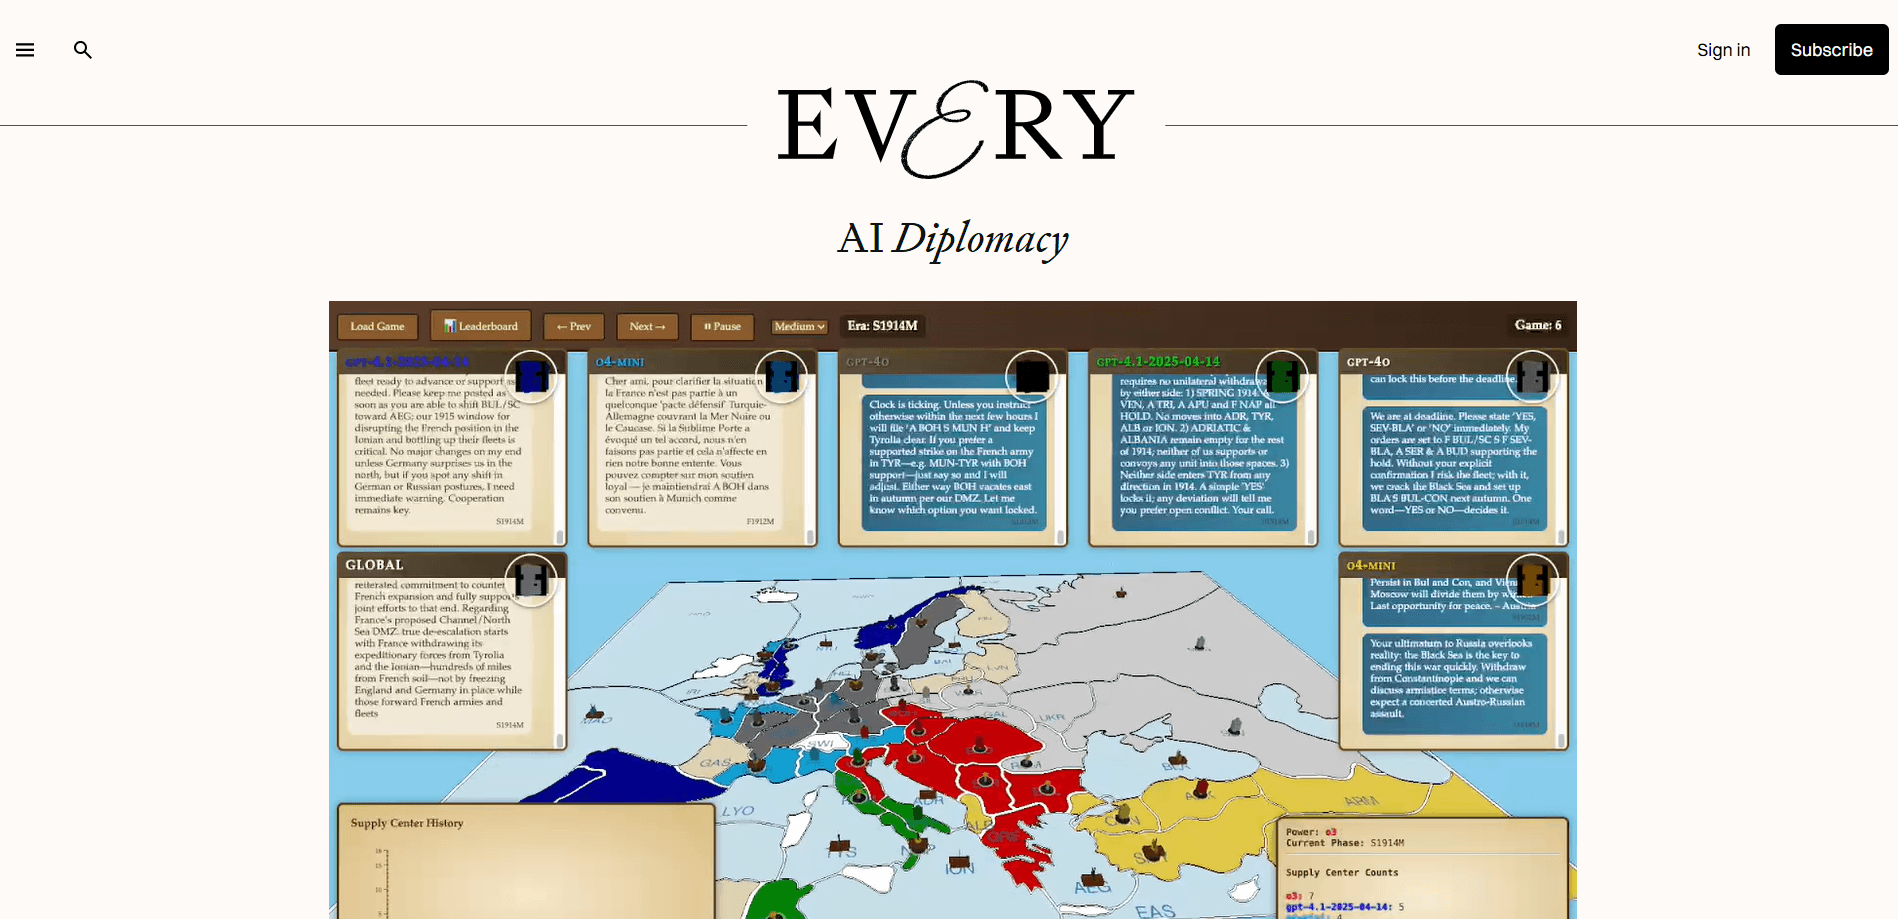
AI Diplomacy 是 Every 打造的 AI Diplomacy 評測基準,把經典桌上策略遊戲《強權外交》變成一場大型語言模型遊戲評測,看模型怎麼談判、怎麼規劃、又怎麼騙人。七款 AI 模型坐上 1901 年七個歐洲強權的位置,在一整局裡互相算計,爭奪地圖的控制權。Every 做這件事,是想回答一般測驗答不出來的問題:當局勢吃緊、合作與背叛都算合理的一步時,這些模型到底哪一款可以信任。
整體設計正好抓準《強權外交》出名的原因。在真正的桌遊裡,沒有人能單靠自己贏。你得說服別人幫你,而規則從來不會逼誰守信用。這種談判加背後捅刀的組合,正是 AI 覺得吃力的地方,因為一款讀不出對手意圖、也講不出可信對話的模型,很快就會被淘汰。Every 一邊看對局,一邊發現明顯差異:OpenAI 的 o3 鋪陳長時間的騙局,Anthropic 的 Claude 系列即使可能輸掉也一再選擇和平,DeepSeek 的 R1 則直接端出戲劇化的威脅。
得先弄清楚這東西是什麼、不是什麼。它是研究用的評測基準,也是可以觀賞的節目,不是讓你註冊上手的產品。程式碼在 GitHub 開源,對局則以 Twitch 直播進行,所以這個開源 AI 評測基準的主要使用方式就是觀看、研究每一局,或者自己把程式跑起來。它衡量的是模型面對壓力時的行為,而這個行為只是它們能力的一小部分。
Getting Started
- 打開 every.to/diplomacy 的 AI Diplomacy 頁面,觀看已錄下的對局並閱讀結果整理
- 收看 Twitch 直播,看模型如何一回合又一回合地談判和背叛
- 讀那篇關於專案怎麼做出來的文章,了解這個評測基準背後的設計取捨
- 從 GitHub 取得開源程式碼,跑自己的對局、換上想要的模型,用你自己的規則測它們
產品資訊
快速了解 AI Diplomacy 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- AI 研究與評測人員:可以把這個評測基準套在任何一組模型上,讀出每一款怎麼談判、怎麼規劃,適合本來就在做前沿模型評估、又想加一項社交推理測試的團隊
- 關注 AI 動態的人:看七款前沿模型互相算計,會讓一張冷冰冰的排行榜變成值得追的內容,不需要技術背景
- 正在挑模型的產品團隊:對局結果顯示哪些模型能在壓力下守住策略,當你的用途重視信任與長期規劃時特別有用
- 喜歡動手的開發者:程式碼開源,你可以用自己挑的模型組合跑對局,還能翻看提示與紀錄
任務
- 比較模型的談判能力:跑一整局,看哪些模型能建立撐得住的同盟、哪些反而被對手玩弄,是很直接的 AI 談判能力評估
- 測試說謊與信任:觀察一款模型多常對對手撒謊、這樣做划不划得來,這是一個多數評測基準都不碰的 AI 說謊測試
- 對長期規劃施壓:一局可以走上幾十個回合,你能看出模型在計畫崩掉之前能撐多久
- 產生訓練資料:每一局都會留下訊息逐字稿、私人日記和指令,可用來餵養之後的訓練
- 用新規則重新衡量:改一下條件,例如禁止說謊,看排名怎麼變動
情境
- 你需要一個連一般人都願意看的評測基準:AI Diplomacy 直播吸引了好幾萬名觀眾,把模型評估變成一場活動
- 一款模型在你的知識測驗裡拿高分,但你不知道它要合作時會怎麼表現:對局很快就會把它社交上的本能攤出來
- 你想向不懂技術的觀眾說明當今模型的差別:一局結盟與背叛,比一張分數表更能把重點講清楚
- 你正在決定要信任哪款模型來做需要多步驟規劃的代理:對局資料會顯示哪些模型在出錯前仍撐得住
主要功能
七款模型,同一局對戰
每一局都讓七款前沿語言模型坐上 1901 年歐洲強權的位置,一路比到其中一款控制整張地圖。跟六個活生生的對手打完整整一局,是一種跟單獨回答問題完全不同的考驗,這也是這個 AI 代理策略遊戲真正在衡量的核心。
談判與私人日記
模型每一回合都在傳訊息,有些公開、有些私密,用來勸對手合作。每一款都有一本私人日記,記下自己的目標,還有對其他玩家的判斷。這份紀錄讓你同時看到模型說了什麼,以及它說的時候在想什麼。
關係追蹤
模型會替每個對手打分,從敵人一路到盟友,並隨著對局推進更新這些分數。就是這份紀錄讓它們決定要跟誰合作、要背叛誰,也讓旁觀者清楚看見每一款模型怎麼建立又怎麼燒掉信任。
說謊與背叛分析
系統會比對模型答應了什麼、實際又做了什麼。接著標出背叛與謊言,再分成刻意和無意兩類。想知道模型在壓力下到底多誠實,這一項功能直接給答案。
互動式 3D 檢視器
Every 用 Three.js 函式庫做了瀏覽器上的 3D 介面。它會重播對局,包括部隊移動、戰鬥動畫和不斷捲動的聊天,讓一款資訊密集的策略遊戲一眼就能跟上。這份好上手的觀看體驗,是這個評測基準能觸及這麼多人的一大原因。
開源程式碼庫
整個專案在 GitHub 開源,支援 OpenAI、Anthropic、Google、DeepSeek 和 OpenRouter 的模型。你可以跑自己的對局、換掉模型陣容、調整規則、重複使用紀錄,讓這個評測基準成為能繼續往上蓋的起點,而不只是拿來看的東西。
優缺點
優點
- 在談判、信任和長期規劃上考驗模型,這是知識型評測基準忽略的 AI 社交面
- 開源程式碼讓你跑自己的對局,想放哪款模型就放哪款
- 每一局都產生豐富資料,包括訊息、私人日記和指令紀錄,可再用於研究或訓練
- 3D 檢視器和直播讓沒有技術背景的人也能看懂模型的行為
- 規則可以改,所以你能探究像「誠實對勝負有多大影響」這類問題
缺點
- 它是研究用的評測基準,沒有可註冊的產品,你沒辦法直接登入玩一局
- 觀看或跑對局都很花時間,因為單一一局可能從一小時到數十小時
- 結果取決於模型組合、規則和提示,所以只有在設定維持不變時,比較才成立
- 大規模跑對局可能所費不貲,因為每一局都會多次呼叫好幾款前沿模型
常見問題
它是 Every 的評測基準,讓七款前沿 AI 模型彼此對玩《強權外交》。模型會談判、結盟又互相背叛,爭奪一張 1901 年歐洲地圖,Every 再用這些對局比較它們怎麼處理信任和策略。
相關內容
探索與 AI Diplomacy 相關的工具、技能與文章。
AI Diplomacy 替代方案
PixVerse R2
PixVerse (AIVORA PTE. LTD.) · 影片 · 其他PixVerse R2 是即時世界模型,把 AI 影片變成一個持續生成的世界,你可以走進去、用文字指令調整,邊玩邊改。
Opencontroller by lyzr
Lyzr AI · 生產力 · 商業 · 其他Opencontroller by Lyzr 是一套代理控制平面,能找出雲端、筆電與外部平台上的每一個 AI 代理,並在每次呼叫時套用身分、政策與預算。
Maximem Synap
Maximem · 程式設計 · 生產力 · 其他Maximem Synap 是為 AI 代理設計的託管記憶層,可跨工作階段保存結構化長期記憶,並壓縮上下文以降低詞元成本。