

Confident AI
Confident AI · 其他
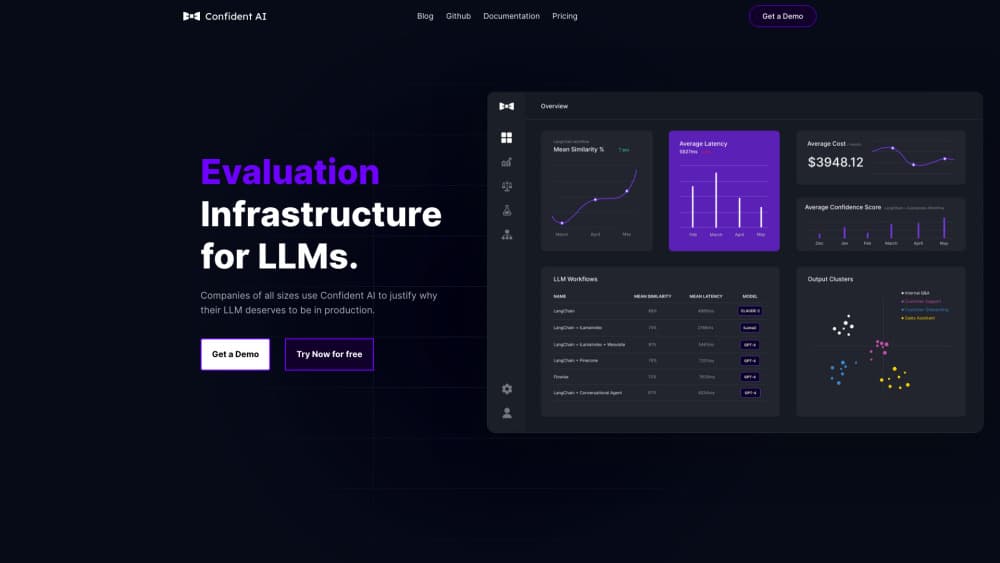
Confident AI 是一套 LLM 評估平台,底層建立在開源框架 DeepEval 之上。團隊能在上線前測試 AI 應用、用有研究依據的指標替回答打分,上線後再監控真實流量。
關於 Confident AI
About
Confident AI 是什麼
Confident AI 是一個用來測試與監控大型語言模型應用的網頁平台。它處理的是多數團隊最卡住的那一關:證明聊天機器人、RAG 流程或代理程式在有人改了提示詞、換了模型之後仍然正常。你可以用 Python 或在瀏覽器裡寫測試案例,對著應用跑一輪,然後拿到每項指標的分數,以及每個分數的文字說明。
這家公司同時維護 DeepEval,也就是支撐平台指標的開源評估框架。這件事在實務上有差別。你可以在自己的電腦上用 DeepEval 跑同一套檢查,再把結果送到 Confident AI 讓團隊一起看,不必把品質判斷交給單一廠商的封閉黑箱。
最硬的限制是價格。免費版只給一個專案、兩個席位、每週五次測試。認真使用要從 Starter 方案起跳,每月 200 美元。如果只是偶爾檢查一下,這筆費用很難說服老闆。
開始使用
- 在 confident-ai.com 註冊免費帳號,從專案設定複製 API 金鑰。
- 用
pip install -U deepeval安裝 SDK,再執行deepeval login,把本機框架接到雲端專案。 - 在 Python 檔案裡定義指標與測試案例;如果用的是付費方案,也可以直接在瀏覽器用無程式碼流程建立。
- 執行測試,在儀表板讀取各指標分數,把報告連結分享給團隊。
產品資訊
快速了解 Confident AI 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 打造 RAG 流程或代理程式的 AI 工程師:指標庫涵蓋脈絡召回、忠實度、工具呼叫正確性與任務完成度,不必從零寫評分邏輯。
- 負責 AI 功能的產品經理:無程式碼評估流程讓你改完提示詞就重跑檢查,不用開工程單,但需要付費席位。
- 轉做 LLM 測試的 QA 團隊:迴歸測試把新版本跟存下來的基準比對,直接接上原本的發版習慣。
任務
- 上線前抓出幻覺:忠實度與幻覺指標會拿回答對照檢索到的脈絡評分,每個分數都能連回出錯的那筆案例。
- 比較兩組模型或提示詞設定:並排實驗把同一份資料送進兩個版本,直接看出哪項指標變動、變了多少。
- 把線上事故變成測試案例:追蹤紀錄可以整理成資料集,使用者週二遇到的爛回答,從此成為永久的迴歸檢查。
- 對客戶端聊天機器人做紅隊測試:對抗式測試涵蓋注入攻擊、有害輸出與政策違規,結果留存下來當審查證據。
情境
- 每週都在換模型的初創團隊:CI 裡的自動評估能抓到單元測試看不見的品質下滑。
- 想把評估標準統一的多產品線企業:同一套指標定義到處適用,治理關卡會擋下沒通過檢查的版本。
- 已經在線上的客服機器人:線上評估替真實流量打分,準確度一漂移就發出警示。
主要功能
有研究依據的指標庫
平台內建 50 多項 AI 評估指標,全部出自 DeepEval,單輪與多輪情境都涵蓋。內容包括回答相關性、忠實度、脈絡精確率與召回率、幻覺、偏誤、毒性,以及工具呼叫正確性這類代理程式專屬檢查。標準指標都不合用時,還能用自訂 G-Eval 指標,以自然語言描述判準。
多輪對話模擬
模擬器不是只看單一回覆,而是對著你的應用演完一整段對話,替整串互動評分。這樣才抓得到要好幾輪之後才冒出來的問題,例如機器人忘了先前答應過的條件。你設定角色與目標,平台負責生成每一輪發言。
CI/CD 迴歸測試
LLM 迴歸測試可以直接跑在 GitHub Actions、GitLab CI、Jenkins,或任何能呼叫 API 的流程裡。某項指標沒過,就跟單元測試掛掉一樣能擋下合併。每次執行都會存檔,所以能逐版比較,看出分數是哪一版掉下去的。
真實流量的 AI 可觀測性
追蹤功能會記錄正式環境應用送出的每個請求、區段與執行緒,再把指標分數貼在旁邊。你可以依低分篩選追蹤紀錄、觀察長期漂移,並針對重複輸出或使用者挫折訊號設定警示。如果原本用的是別家工具,OpenTelemetry 的區段可以直接帶過來。
人工標註與指標對齊
標註佇列讓領域專家依照你們自己的標準審閱輸出。平台接著把人工標籤跟指標分數擺在一起,指出兩邊不一致的地方。這個落差才是重點:它告訴你這項指標是不是太寬鬆,適不適合拿來當發版關卡。
無程式碼流程與 MCP 存取
付費方案可以把評估指向線上的 API 端點、重塑回應內容,並排定週期性執行,全程不寫程式。平台也提供 MCP 伺服器,讓 Cursor 或 Claude Code 裡的代理直接跑評估、在編輯器裡取回結果。
優缺點
優點
- DeepEval 是開源專案,你可以在本機跑檢查、翻開指標原始碼,不用相信一套封閉的評分引擎。
- 每個分數都附說明,沒寫過測試的人也能看懂失敗原因。
- 追蹤與評估放在同一個地方,正式環境的資料可以直接變成新的測試案例。
- 整合涵蓋常見技術堆疊:OpenAI、Claude、Gemini、Bedrock、LangChain、LlamaIndex、CrewAI 與 OpenTelemetry。
- 企業級控管包含 SSO、自訂 RBAC、SOC 2、HIPAA 與地端部署。
缺點
- 免費版限制一個專案、兩個席位、每週五次測試,拿來試用剛好,再多就不夠。
- 團隊正式使用每月 200 美元起,對獨立開發者或小型專案是不小的門檻。
- 無程式碼評估、線上評估與警示都要付費,免費版仍然預設你會寫 Python。
- 評審模型的呼叫費用由你自行負擔,資料集一大、評審模型一強,帳單很快就往上跑。
常見問題
它測試並監控 LLM 應用。你定義測試案例與指標,對著應用執行,拿到附說明的分數;同一個平台接著緊盯真實流量,替進來的請求評分。
相關內容
探索與 Confident AI 相關的工具、技能與文章。
Confident AI 替代方案

Odyssey 3
Odyssey · 其他Odyssey-3 是 Odyssey 的基礎世界模型,能即時模擬物理,把一段文字提示變成可互動的環境,並套用到機器人、汽車與遊戲上。

JarvisCore
Prescott Data · 程式設計 · 生產力 · 其他JarvisCore 是開源的 Python 執行環境,讓 AI 代理在網格上以對等節點運作、從共用帳本認領任務,並透過零信任代理服務存取外部系統。
Clef
Cloudflare · 商業 · 其他Clef 是 Cloudflare 推出、可在 Workers AI 上執行的開源決策模型。它針對設定好的題目回傳校準後的機率而非生成文字,讓代理程式快速分類、分流並採取行動。