
關於 LFM2
What Is LFM2
LFM2 是 Liquid AI 於 2025 年 7 月推出的第二代基礎模型。這家公司出身自麻省理工學院的 CSAIL 實驗室,做的模型以速度和記憶體效率換取體積。LFM2 有三個稠密版本:350M、700M 與 1.2B 參數。每一個都小到能跑在手機、筆電或車用系統上,背後不需要資料中心。
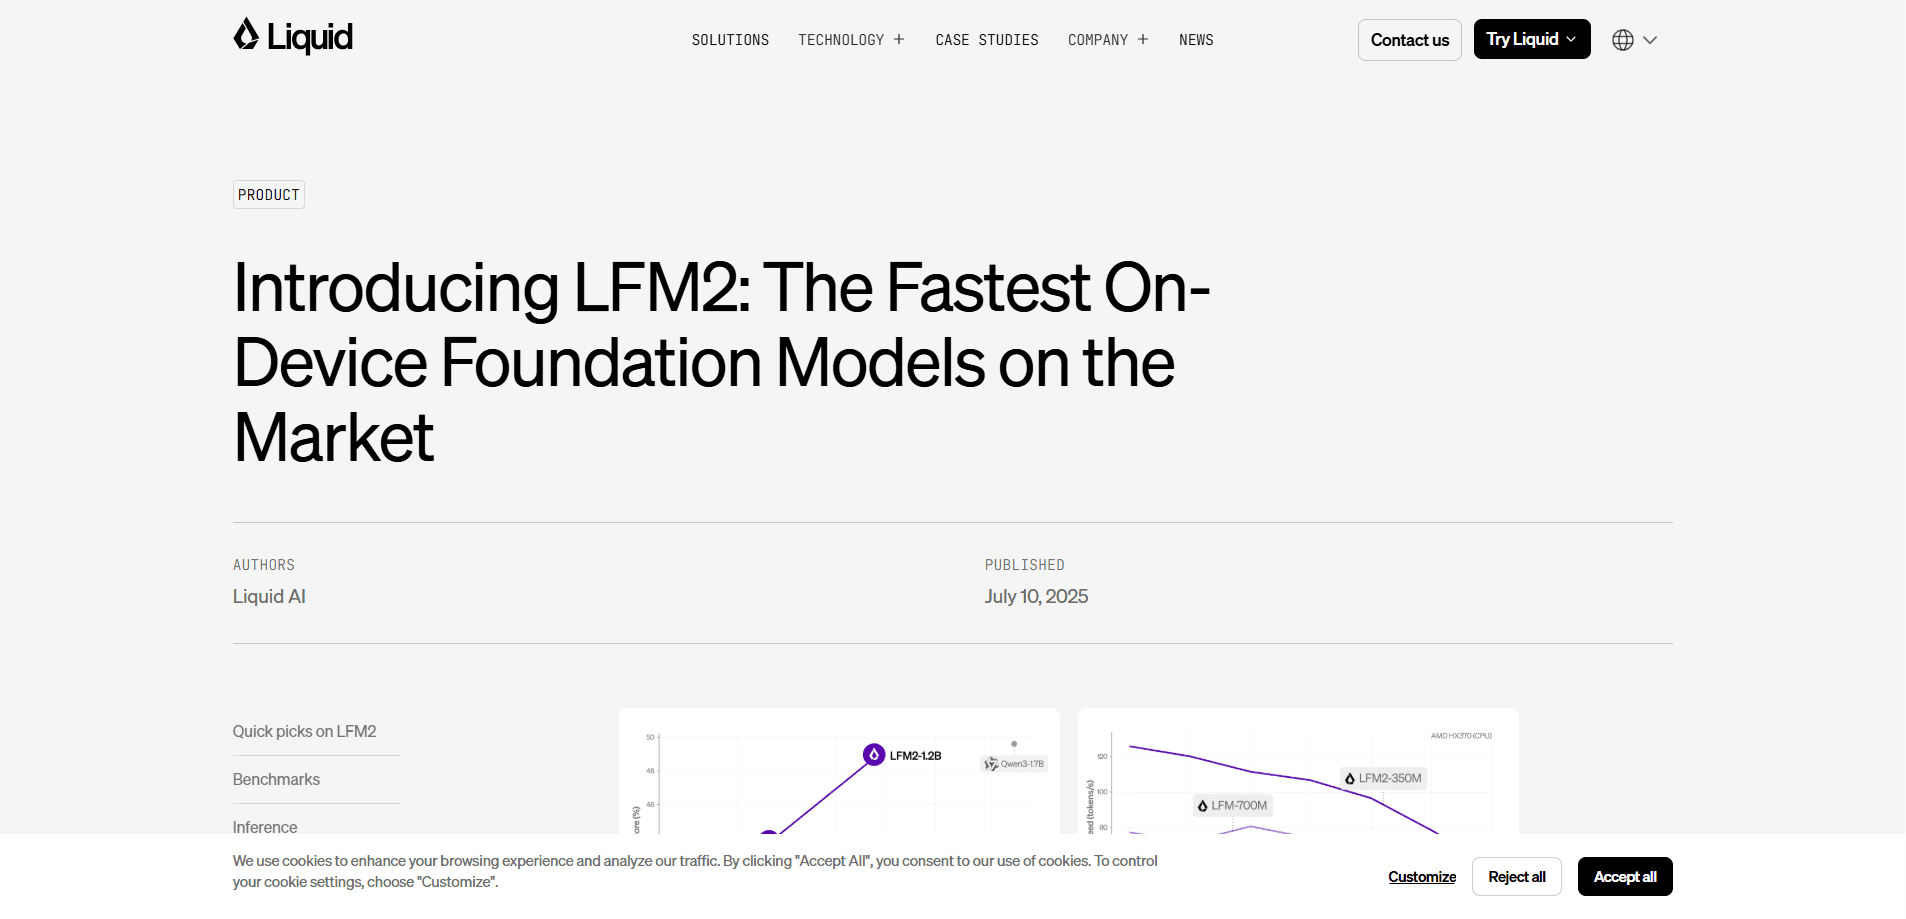
它的訴求很單純。雲端模型很強,但速度慢、大規模運行又貴,還得把資料送出裝置。LFM2 想把好用的 AI 留在本機,回應在毫秒內回來,資料也完全不離開機器。根據 Liquid AI 的說法,這些模型在處理器上解碼與預填的速度是 Qwen3 的兩倍,訓練流程也比第一代 LFM 效率高 3 倍。
問題在於小模型的知識量有限。Liquid AI 建議把 LFM2 微調到特定任務,例如資料擷取、RAG 或多輪對話,並提醒它不適合吃重知識的工作,像是深度推理或複雜程式開發。把 LFM2 當成快速又私密的積木,而不是什麼都懂的助理。
Getting Started
- 在 Hugging Face 上挑一個符合硬體的版本,從給微型裝置的 350M 到給筆電或單張 GPU 的 1.2B
- 下載權重,或改用 GGUF 這類量化格式搭配 llama.cpp,把佔用空間再壓低
- 用支援的框架在本機執行,包括 llama.cpp、ExecuTorch 或標準的 Transformers 工具鏈
- 若通用版本不符合你的任務,用 TRL 這類框架在自己的資料上微調,再把調校後的版本部署到裝置
產品資訊
快速了解 LFM2 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 開發裝置端功能的 App 開發者:想在應用程式內放一個小模型、不想付雲端帳單也不想要網路來回的工程師
- 有隱私限制的團隊:在醫療、金融或國防領域工作,不能把使用者資料送到第三方伺服器的人
- 玩家與自造者:想在筆電或樹莓派上跑語言模型、了解各部件怎麼組合起來的人
- 年營收低於 1,000 萬美元的新創:想要一份免費商業授權、能自行微調基礎模型的小公司
任務
- 代理工作流程:給代理一顆反應快的本機大腦,用來呼叫工具與規劃短步驟
- 資料擷取:在裝置上從文件、表單與訊息裡取出結構化欄位
- 檢索增強生成:用自家私密文件庫支撐簡短回答
- 多輪對話:在規格普通的硬體上撐起一個反應俐落的助理
- 創意寫作輔助:在本機起草與改寫短文,不用呼叫雲端
情境
- 手機 App 需要離線回應:沒有訊號時,LFM2 讓助理照常運作
- 筆電使用者想在本機起草:在 CPU 上跑 1.2B 版本,草稿留在機器裡
- 裝置廠商想壓低成本做 AI:把 350M 模型嵌進記憶體吃緊的穿戴裝置或智慧家電
- 受監管的團隊必須把資料留在內部:在私有伺服器上處理紀錄,而不是走外部 API
- 開發者在車用系統上測試代理:裝置端模型就算沒有行動網路也能快速回應
主要功能
卷積與注意力混合架構
LFM2 把短卷積與分組查詢注意力混在一起,不是只靠注意力。每個模型疊了 16 個區塊:10 個雙閘控短程卷積區塊,加上 6 個分組查詢注意力區塊。這種設計用低成本抓取局部樣式,只在划算的地方動用注意力,於是延遲與記憶體在手機、筆電真正搭載的硬體上都壓得很低。
在一般處理器上的速度
主打的是吞吐量,不是原始準確度。根據 Liquid AI 的說法,LFM2 在處理器上解碼與預填的速度是 Qwen3 的兩倍,體型較小的 700M 版本即使參數更多,在 llama.cpp 與 ExecuTorch 裡仍比 Qwen 0.6B 更快。這個差距在手機或輕薄筆電上很有感,因為處理器是你唯一能指望的晶片。
對應不同裝置的四種尺寸
這個家族涵蓋 350M、700M、1.2B 與 2.6B 參數,方便你依裝置挑選。350M 版本放得進穿戴裝置與吃緊的嵌入式目標,1.2B 版本則跑在筆電或單張 GPU 上,還能跟參數多出許多的模型一較高下。作為面向邊緣的語言模型家族,單一架構橫跨多種尺寸,代表功能要往上或往下調整時不必重寫。
小尺寸下的 LFM2 評測數據
根據 Liquid AI 的說法,LFM2-1.2B 的表現與 Qwen3-1.7B 相當,後者參數多了 47%,而 LFM2 的分數也接近體積大上好幾倍的模型。700M 版本勝過 Gemma 3 1B IT,350M 版本則與 Qwen3-0.6B 和 Llama 3.2 1B Instruct 互有勝負。在自家做的多輪測試裡,評審更偏好 1.2B 模型,勝過 Llama 3.2 1B Instruct 與 Gemma 3 1B IT。
開放權重與彈性授權
Liquid AI 以基於 Apache 2.0 的開放授權,在 Hugging Face 上發布權重。學術與研究用途免費,年營收低於 1,000 萬美元的公司也能免費用於商業。超過這個門檻就得聯絡 Liquid AI 談商業授權,這讓小團隊的條件保持單純,也為大企業的合作留下空間。
廣泛的工具鏈支援
LFM2 能匯出到開發者已熟悉的框架。它可透過 llama.cpp 做本機推論,透過 ExecuTorch 在 PyTorch 上跑行動裝置,也能用標準的 Transformers 工具鏈訓練。用 TRL 微調是官方支援的路線,GGUF 版本則讓模型更容易放進既有的推論應用。
32K 脈絡與多語言訓練
每個版本都支援 32,768 詞元的脈絡視窗,足以處理長文件與長時間對話。訓練動用了 10 兆詞元,約 75% 英文、20% 多語言、5% 程式碼,並特別加強日文、阿拉伯文、韓文、西班牙文、法文與德文。這讓 LFM2 適合服務多種語言的應用。
優缺點
優點
- 在手機、筆電與汽車本來就有的處理器上跑得快,不必額外準備 GPU 或雲端服務
- 小版本佔用記憶體少,適合穿戴裝置與其他空間吃緊的嵌入式目標
- 評測成績以極小體積追平甚至超越 Qwen3-1.7B、Gemma 3 1B IT 等更大的模型
- 權重開放,年營收低於 1,000 萬美元還免商業授權,起步成本低
- 支援 llama.cpp、ExecuTorch 與 TRL 等熟悉工具,採用時不必重寫系統
缺點
- 小模型的知識量較少,深度推理或複雜程式開發這類吃重知識的任務超出它的守備範圍
- Liquid AI 建議針對特定用途微調,你得先花功夫設定才能看到最好的效果
- 公司年營收一旦超過 1,000 萬美元,商業授權就得簽付費協議,規模放大會產生成本
- 現在已有更新的 LFM2.5 版本與更大的 LFM2 變體,原本的三種尺寸不再是唯一的最新選擇
常見問題
LFM2 為裝置端 AI 而生,小模型在本機運行,不必上雲。常見用途包括代理工作流程、資料擷取、檢索增強生成、多輪對話與創意寫作輔助。Liquid AI 建議開發者鎖定狹窄、明確的任務,而不是通用推理。
相關內容
探索與 LFM2 相關的工具、技能與文章。
LFM2 替代方案

Odyssey 3
Odyssey · 其他Odyssey-3 是 Odyssey 的基礎世界模型,能即時模擬物理,把一段文字提示變成可互動的環境,並套用到機器人、汽車與遊戲上。

JarvisCore
Prescott Data · 程式設計 · 生產力 · 其他JarvisCore 是開源的 Python 執行環境,讓 AI 代理在網格上以對等節點運作、從共用帳本認領任務,並透過零信任代理服務存取外部系統。
Clef
Cloudflare · 商業 · 其他Clef 是 Cloudflare 推出、可在 Workers AI 上執行的開源決策模型。它針對設定好的題目回傳校準後的機率而非生成文字,讓代理程式快速分類、分流並採取行動。