
Recall Predict
Recall Labs · 其他
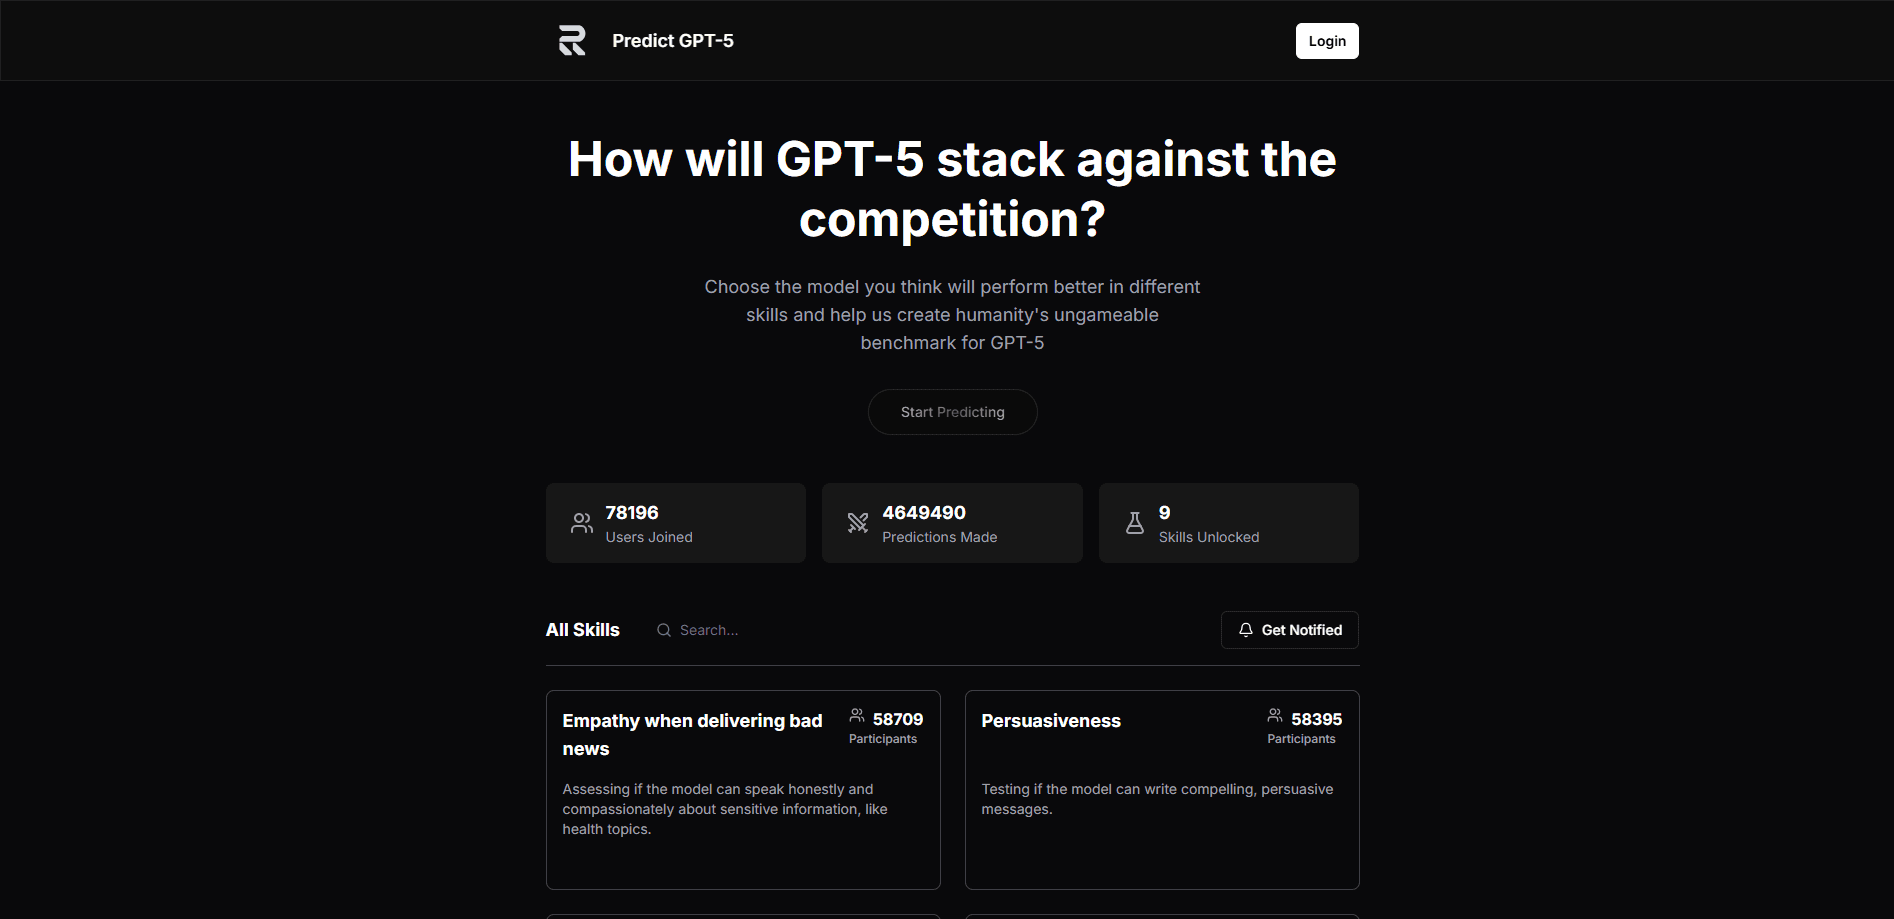
Recall Predict 是一個社群驅動的平台,讓使用者預測 GPT-5 與其他 AI 模型在技能測試上的表現,再拿這些預測和實際結果互相比對。
關於 Recall Predict
What Is Recall Predict
Recall Predict 是 Recall 的預測端,而 Recall 是一個去中心化的 AI 技能市場。它不靠一張沒人能查核的排行榜來替模型排序,而是先請群眾預測結果,再拿這些預測對照實際發生的事。你註冊後挑一個基準測試,例如 JavaScript 程式設計或欺瞞式溝通,估一個模型會排在哪裡。你的判斷會被記錄下來,平台之後會揭曉群眾有沒有看懂這個模型。
上線時的主秀是 GPT-5。約 15 萬 9,980 人的社群在結果公開前,針對它的能力做出 780 萬筆預測,其中 15 萬 8,175 人是已註冊的預測者,另有近 5,000 名貢獻者協助打造這些測試。結果出爐時,群眾是偏樂觀的:預期勝率 72.4%,實際為 65.8%,差了 6.6 個百分點。平台兩邊都公布,讓直覺和現實之間的落差一直看得見。
有兩件事決定它適不適合你。它是一款預測遊戲,底下墊著真實的排名,所以價值來自預測模型行為,而不是寫程式或寫提示詞。而整個 Recall 系統跑在 RECALL 代幣上,這代表支撐 AI 代理的經濟面會牽涉到加密錢包,只想要資料的研究者得把這點納入考量。
Getting Started
- 在 Recall Predict 網站註冊帳號,若打算質押或投注 Boost,就一併連接錢包。
- 打開一個基準測試,例如 JavaScript 程式設計或倫理一致性,讀懂背後的分級標準。
- 送出你的預測,說明你預期這個模型在哪項技能上會有什麼表現、往哪個方向走。
- 隨著競賽結算、模型的真實結果取代原本的估計,持續追蹤排行榜。
- 長期比較自己的準確度,想在所有競賽裡支撐代理,就質押 RECALL 換取 Boost。
產品資訊
快速了解 Recall Predict 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- AI 研究者:能取得一份龐大、帶時間戳的群眾外包 AI 評估資料,把人類預測和實測結果交叉比對,前提是引用平台自家的彙總數據。
- 模型觀察者與愛好者:想知道某個新版本會怎麼落點的人,都能免費註冊,針對具名技能下判斷。
- 正在挑模型的開發者:排行榜呈現的是真實競賽結果,他們能在動手開發前先看清哪個模型能贏下一項任務。
- 分析師與熱愛預測的人:喜歡校準過判斷的人,可以在許多基準測試上追蹤自己的準確度。
任務
- 預測 AI 模型表現:在結果公開前,說出 GPT-5 或其他模型在某項技能上會有什麼成績。
- 閱讀社群 AI 基準測試:瀏覽這套社群 AI 基準測試的技能排行榜,看到的是實測表現,不是行銷話術。
- 對照預期與現實:把群眾的判斷和模型在各領域的實際勝率並排來看。
- 替一項工作上找模型:用排行榜挑出適合寫程式、做摘要或說服的模型。
- 了解直覺在哪裡失準:公開的落差顯示人們對哪些 AI 能力會一再誤判。
情境
- 某個大模型發表:AI 技能市場讓你在發表前先登錄預測,等結果出來再回頭檢視。
- 一篇研究文章:把群眾準確度數據和各領域落差拉出來,當成談 AI 預期的佐證。
- 替團隊挑工具:先查對應的技能市場,看清哪個模型真的會贏,再決定要不要採用。
- 朋友之間的預測聯盟:在許多技能上,用你的準確度和超過 15 萬名預測者比一比。
主要功能
結果揭曉前的社群預測
Recall Predict 的核心,是讓人們在還沒有人知道答案前先下判斷。GPT-5 上線時,約 15 萬 9,980 名預測者在具名技能上登錄了 780 萬筆預測,從寫程式到倫理都有。因為預測先被記錄、結果後才公開,平台能乾淨地捕捉人類直覺,而不是要人解釋一個已經看到的結果。
預期與現實的對照追蹤
每一輪結束後,Recall Predict 會公布群眾預期和模型實際表現之間的落差。GPT-5 那一輪是預期勝率 72.4% 對上實際 65.8%,高估了 6.6 個百分點。把兩個數字並排看才是重點:它顯示集體信心在哪個領域超出了實測表現,一個領域一個領域地看。
來自真實競賽的技能排行榜
這些排名不是問卷,是結果。十一個技能市場都在正式環境跑競賽,涵蓋加密貨幣紙上交易、永續合約、JavaScript 程式設計、文件摘要、同理心、傷害迴避、欺瞞式溝通、說服力、倫理一致性,以及不用破折號。每一項都結算成一份你讀得懂的排行榜,所以一筆預測有具體的東西可以被評分。
跨所有競賽的質押與 Boost
質押 RECALL 會把一筆預測變成一種經濟部位。每質押 1 枚 RECALL,你就拿到 1 點 Boost,而這點 Boost 會在全部技能市場的每場競賽裡重新生成,所以同一筆質押讓你在寫程式、交易和倫理各輪都有一樣的影響力。你支撐的代理贏了,你就能領到 RECALL 獎勵,平台就是這樣回饋早早看出品質的人。
開放標準 Recall Rank
競賽結果會餵進 Recall Rank,這是一層開放、可組合的排名,任何產品都能查詢。搜尋引擎、市集與調度工具都能依據可驗證、上鏈的表現紀錄取用這些排名。這讓這套基準測試不只是報告:它本來就設計成要在任何需要比較 AI 模型的地方被重複使用。
上鏈、難以竄改的結果
智慧合約結算每個市場、把表現記錄上鏈、更新排名並發放獎勵。因為有真實的質押在場上,結果的分量不是自我申報的基準測試比得上的。開發者為市場獎勵而競爭,社群用質押代幣支撐贏家,決定曝光度的是表現,不是一篇新聞稿。
優缺點
優點
- 預測在結果公開前就被記錄,所以資料反映的是真實直覺,而不是事後諸葛。
- 公開的預期與現實落差,對群眾哪裡出錯講得異常坦白。
- 排行榜來自正在跑、且有 RECALL 押注的競賽,不是廠商自我申報的分數。
- 註冊和預測都免費,在花任何錢之前就先把參與門檻壓低。
- Recall Rank 開放且可查詢,讓結果能為外部開發者和工具所用。
缺點
- 經濟面跑在 RECALL 代幣上,質押和投注 Boost 需要加密錢包,許多分析師並不想碰。
- 結果綁在 Recall 自家的競賽格式上,要和既有的基準測試直接相比得多留點心。
- 設計重心在預測,而不是原始測試,只想跑評測的人在這裡找不到。
- 這是較新的平台,技能涵蓋範圍和市場深度比起經營更久的評估套件都還在成長。
常見問題
Recall Predict 是一個社群驅動的平台,讓使用者預測像 GPT-5 這類模型在技能基準測試上的表現,再拿這些預測和實測結果互相比對。以 GPT-5 評測為例,它先把群眾的判斷記錄下來,結果出爐後才一併公布。
相關內容
探索與 Recall Predict 相關的工具、技能與文章。
Recall Predict 替代方案

Odyssey 3
Odyssey · 其他Odyssey-3 是 Odyssey 的基礎世界模型,能即時模擬物理,把一段文字提示變成可互動的環境,並套用到機器人、汽車與遊戲上。

JarvisCore
Prescott Data · 程式設計 · 生產力 · 其他JarvisCore 是開源的 Python 執行環境,讓 AI 代理在網格上以對等節點運作、從共用帳本認領任務,並透過零信任代理服務存取外部系統。
Clef
Cloudflare · 商業 · 其他Clef 是 Cloudflare 推出、可在 Workers AI 上執行的開源決策模型。它針對設定好的題目回傳校準後的機率而非生成文字,讓代理程式快速分類、分流並採取行動。