
Preprocess
Preprocess · 生產力 · 商業
Preprocess 是一套文件切塊 API,依文件結構把 PDF、Office 檔與 HTML 切成 RAG 可用的文字片段。這項服務目前已終止。
關於 Preprocess
What Is Preprocess
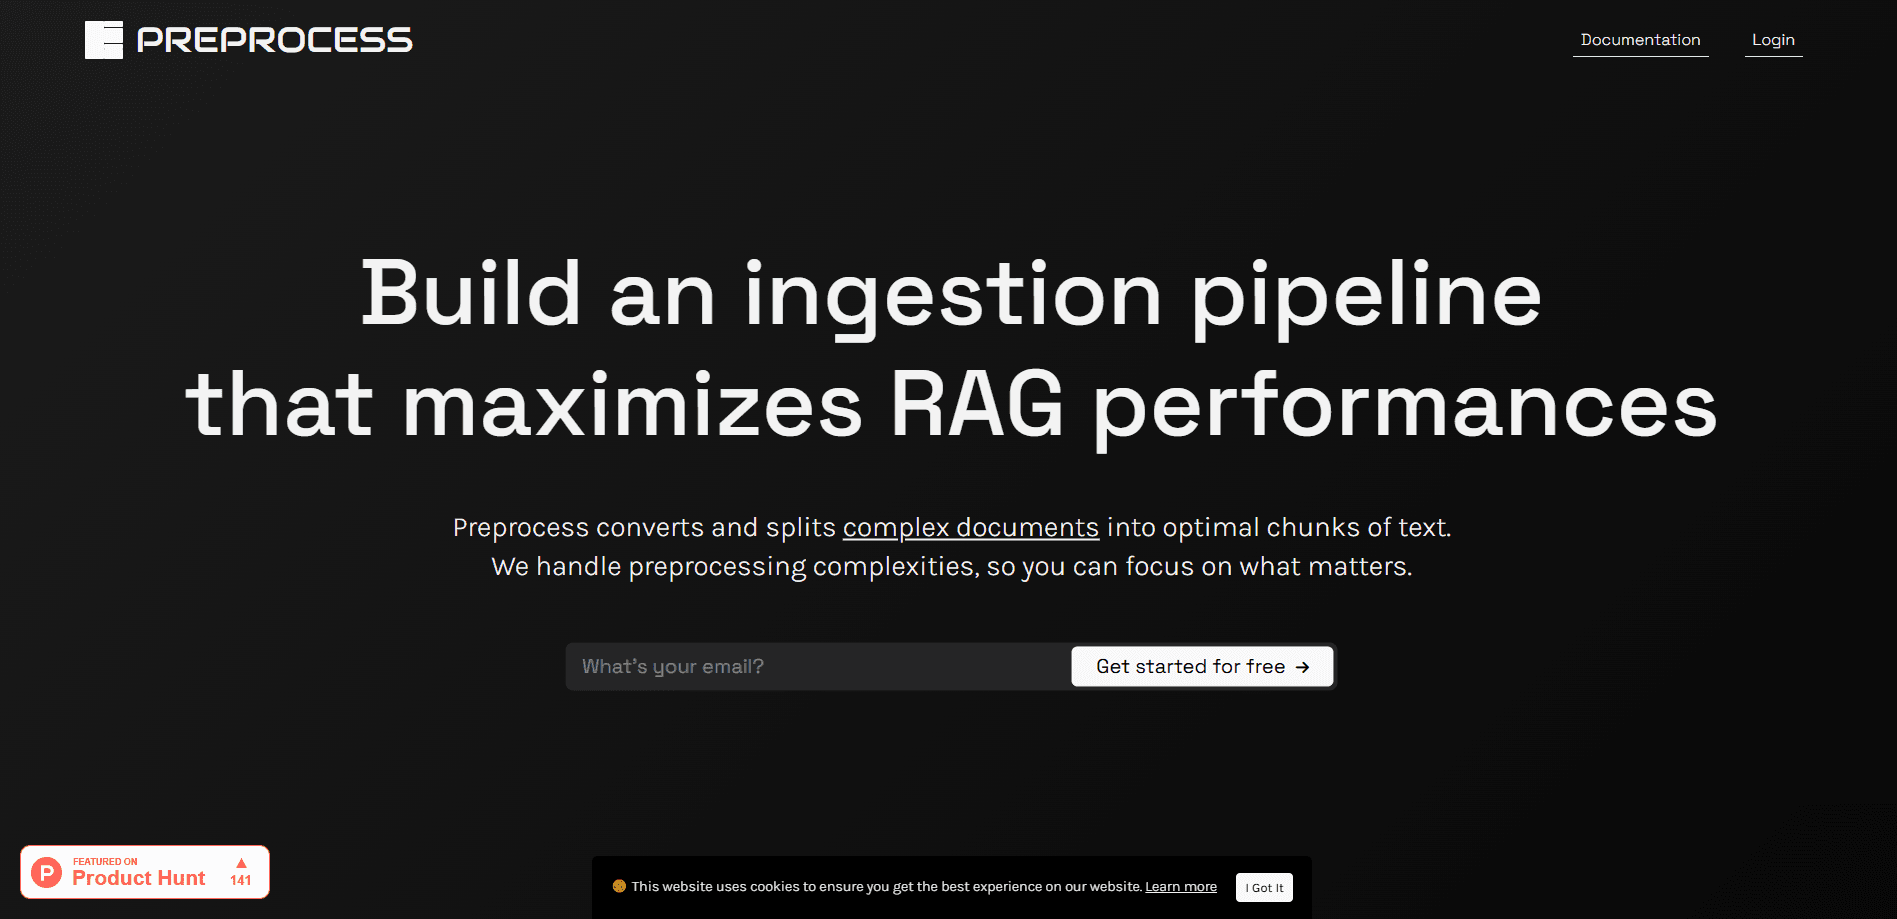
Preprocess 是一套 API 服務,專門把又長又複雜的文件轉成適合檢索的文字片段。它本質上是一款 PDF 解析 API,不會每幾百個字就硬切一刀,而是先讀懂標題、章節、段落、表格、圖片與清單,再順著文件本身的結構與語意切分。官方把產出稱為 RAG 可用資料:乾淨的片段可以直接向量化、建立索引,丟進向量資料庫時不必先清理。
它鎖定的問題很真實。多數團隊用固定字數切文件,這種做法等於把落在視窗裡的內容一股腦交給模型。RAG 資料前處理走的是另一條路,先讀懂文件的結構再動手。表格某一列可能黏上無關的標題,定義失去原本的清單,模型只能拼湊零碎資訊作答。Preprocess 聲稱這種結構感知的做法能讓 RAG 表現提升最多 10 倍,這是官方自己的數字,並非第三方實測。
現在有一件事比任何功能都重要。preprocess.co 這項服務已無法使用。官網只回傳一個空目錄,廠商關閉了服務,Python SDK 與 LlamaIndex 讀取器也都標註專案已終止,建議從專案中移除。
Getting Started
以下是服務還在運作時的流程。
- 在 Preprocess 應用程式註冊,購買一組點數以取得 API 金鑰
- 用上傳或 Python SDK 把文件送到解析端點
- 等待非同步解析完成,結果會送到你的 webhook,或在 24 小時內用 GET 呼叫取回
- 把取回的片段直接送進向量資料庫,不必再另外切分文字
產品資訊
快速了解 Preprocess 的定價、支援平台與效能。
適合對象
這項工具最適合的使用者、任務與情境。
使用者
- 建置 RAG 流程的 AI 工程師:需要按主題而非字數聚在一起的片段,這項服務能接進既有的資料匯入步驟
- 沒有自製解析器的後端開發者:API 涵蓋 PDF、Office 檔與 HTML,團隊不必自己寫結構處理邏輯
- 正在推出 AI 助理的產品團隊:片段品質好,代表較少答案是用斷裂的上下文拼出來的,展示時幻覺也跟著變少
任務
- 切分長篇 PDF:報告與手冊會依標題與章節切分,而不是切在句子中間
- 擷取表格與清單:表格資料與項目清單維持完整,檢索不會只回傳半張表
- 處理掃描文件:OCR 會先把純圖片 PDF 的文字抓出來再切塊,省掉一道獨立步驟
- 處理 Office 與 HTML 檔:Word、PowerPoint、Excel 與網頁都走同一個端點
情境
- 法務或財務團隊把厚重的合約丟進搜尋工具:結構感知的片段會讓每個條款跟著自己的標題
- 用產品手冊與說明頁打造的客服機器人:依章節切出的片段,能提供更乾淨的引用來源
- 沒有解析團隊的新創公司:買點數比自建並維護一套切分工具更划算
- 批次匯入工作:平行任務讓大批文件同時送進 API 處理
主要功能
結構感知的智慧切塊
核心功能會依標題、章節、段落、表格、圖片與清單切分文件,再把長段落按語意歸類。這樣一來,每個片段都指向單一主題,向量化時也能抓到單一概念。官方主張光是這一點就能拉高檢索品質、降低幻覺,因為模型不再收到對不上的片段。
廣泛的格式支援
API 用單一端點收下 PDF、Microsoft Office 檔、OpenOffice 檔、HTML 與純文字。掃描 PDF 同樣能處理,因為文字擷取會在切塊前先跑一遍。對於來源混雜的團隊來說,這代表只要接一次,而不是每種檔案各寫一個解析器。
非同步 API 與 webhook
解析長文件很花時間,因此 API 採非同步運作。解析呼叫會先確認收到檔案,完成後的片段會送到 webhook,或在 24 小時內用 GET 請求取回。這種設計適合批次工作,一次跑幾十個檔案,也不必排队等待。
Python SDK 與 LlamaIndex 整合
名為 pypreprocess 的 SDK 用幾行 Python 就包好 API,LlamaIndex 讀取器則能載入已切塊的檔案,或用處理程序 ID 取回先前的結果。團隊想跑自己的流程時,讀取器也能回傳整份文件文字。如今 SDK 與讀取器都已標註終止。
點數計價,不用訂閱
Preprocess 不收月費。你買一組點數,用完再加購。文件或簡報的一頁算一點,試算表的一張工作表算一點,HTML 或文字檔會先轉成 PDF 再計算頁數。這種模式適合工作量起伏不定的團隊。
企業級控管
較高方案加入圖片匯出、片段邊界控制、零資料保留協議、地端部署與自訂處理流程。這些選項鎖定受監管的產業,因為這類單位的文件資料不能離開自家基礎設施。
優缺點
優點
- 依結構與語意切塊,檢索取回的段落能緊扣主題
- 單一端點涵蓋 PDF、Office 檔、HTML 與純文字,掃描檔也包含在內
- 不用訂閱,只有點數方案,能配合忽多忽少的工作量
- webhook 與 Python SDK 能接進既有匯入流程,不必額外寫串接
- LlamaIndex 讀取器讓它能放進常見的 RAG 架構
缺點
- 服務已終止,現在無法註冊、購買點數或呼叫 API
- 官方宣稱最多 10 倍的效能提升沒有第三方實測佐證
- 計價採預付點數而非用量制,等於要先為可能用不到的額度付錢
- 片段邊界、地端部署等高階控管都鎖在企業方案裡
常見問題
Preprocess 是一套供 RAG 流程使用的文件切塊 API。它讀取 PDF、Office 檔、HTML 與純文字,再切成遵循文件結構與語意的文字片段,讓每個片段能單獨向量化與建立索引。
相關內容
探索與 Preprocess 相關的工具、技能與文章。
Preprocess 替代方案
Harness Router
Protocol Lattice · 程式設計 · 生產力Harness Router 在你原本的 AI 代理 harness 裡挑出下一個工具,靠快取決策、Jev 路由與選用的 MCTS 運作。實際執行仍留在你的迴圈裡。
VibeDefend by CybeDefend
CybeDefend · 程式設計 · 生產力VibeDefend 用一行指令把商業規則與安全規則帶進 Claude Code、Cursor、Windsurf、Copilot 與 Codex,攔下有風險的操作,並在提交前掃描每一份差異。
Peas and Pans
Peas and Pans · 生產力 · 商業Peas and Pans 是給營養教練與營養師使用的餐點規劃軟體。它匯入食譜、把每項食材對到官方營養資料庫,再以私人連結或 PDF 送出掛著你品牌的計畫。